Drei Ratschläge stehen in jedem Prompt-Leitfaden: sag dem Modell, es soll Schritt für Schritt denken. Gib ihm eine Rolle. Zeig ihm ein Beispiel. Alle drei klingen vernünftig, alle drei kosten Tipparbeit, und keiner davon war auf meiner Hardware je geprüft. Also habe ich sie geprüft — vier Aufgaben, vier Prompt-Varianten, elf Modelle, 528 Messzellen auf einer einzigen Maschine.
Das Ergebnis in einem Satz: die Tricks helfen deutlich — außer dort, wo das Modell die Aufgabe ohnehin löst. Dann schaden sie.
Was gemessen wurde
Vier Aufgaben mit eindeutig richtiger Antwort, nicht mit gut aussehender: rechnung (mehrstufige Preisrechnung), plan (kleines Zuordnungsproblem), extrakt (sechs Felder als JSON, inklusive Datumsrechnung über die Monatsgrenze) und raetsel (fünf Personen auf Platz, Projekt und Getränk, elf Bedingungen). Die Eindeutigkeit der Rätsellösung habe ich per vollständiger Enumeration über 1.728.000 Belegungen bestätigt; jede der elf Bedingungen ist notwendig.
Dazu vier Varianten desselben Prompts, identischer Kern, identischer Formatblock: nackt (nur die Aufgabe), schritte („denk Schritt für Schritt“), rolle („du bist ein erfahrener …“) und beispiel (ein gelöstes Beispiel voran). Elf Modelle, je drei Durchgänge. Macht 528 Anfragen, null Fehler.
Warum der Formatblock eine abschließende ERGEBNIS:-Zeile verlangt statt Erklärtext zu verbieten: verböte ich Erklärungen, wäre schritte von vornherein kaputt. So darf jede Variante beliebig viel davor schreiben und wird gleich bewertet.
Die Regel stand vor den Daten fest
Damit ich mir hinterher nicht die passende Auswertung aussuche: „Der Trick hilft“ heißt, dass die Zahl vollständig gelöster Zellen gegenüber nackt um mindestens 3 von 33 steigt — auf derselben Aufgabe. Darunter ist es das Umkippen einzelner Modelle und wird als „kein Effekt“ berichtet. Bewertet wird je Aufgabe, nie im Gesamtmittel: die vier Aufgaben haben verschiedene Deckeneffekte, ein Mittelwert würde sie verwischen. Eine halb richtige Rechnung ist eine falsche Rechnung.
Das Ergebnis je Aufgabe
Vollständig gelöste Zellen, jeweils von 33:
| Aufgabe | nackt | schritte | rolle | beispiel |
|---|---|---|---|---|
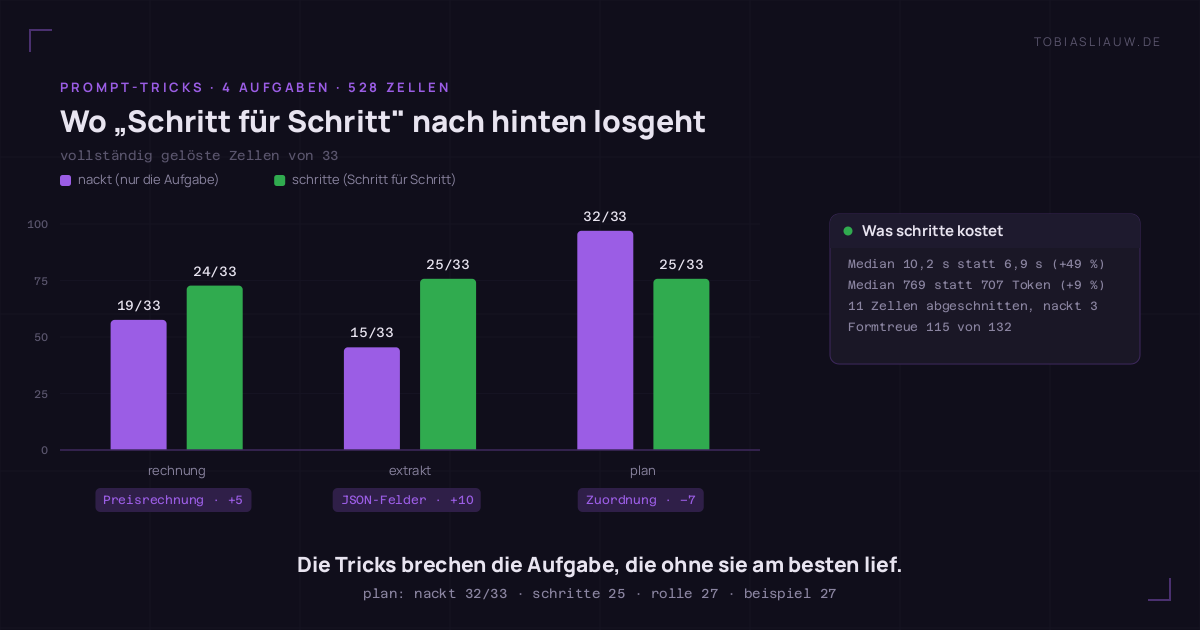
rechnung | 19 | 24 | 24 | 21 |
plan | 32 | 25 | 27 | 27 |
extrakt | 15 | 25 | 21 | 23 |
raetsel | 11 | 14 | 14 | 14 |
Bei rechnung reißen schritte und rolle die Schwelle mit je +5, beispiel bleibt mit +2 darunter. Bei extrakt reißen alle drei sie deutlich — schritte mit +10 am stärksten. Bei raetsel schaffen alle drei exakt +3 und damit die Schwelle auf den Punkt; dort ist das Niveau aber so niedrig, dass ich das nicht überinterpretiere.
Die Stelle, an der es kippt
Und dann ist da plan. Nackt lösen die Modelle 32 von 33 Zellen — praktisch alles. Mit „denk Schritt für Schritt“ fallen sie auf 25. Mit Rolle auf 27. Mit Beispiel auf 27.
Alle drei Ratschläge machen die Aufgabe kaputt, die ohne sie am besten lief. Das ist der interessanteste Befund der Messreihe, und er ist unbequem, weil er die Ratschläge nicht widerlegt, sondern ihre Reichweite begrenzt: Ein Trick, der einem Modell beim Nachdenken hilft, stört es, wenn es nicht nachdenken muss. plan ist klein genug, dass die Modelle es direkt sehen. Wer sie zwingt, den Weg auszuformulieren, gibt ihnen sieben zusätzliche Gelegenheiten, sich zu vertun.
Ich habe die abweichenden Zellen einzeln gelesen, statt der Zahl zu glauben. Die Verluste sind echte Fehler in der Zuordnung, keine verrutschten Antwortmarker.
Der Preis
Ein Trick, der nichts bringt und nichts kostet, ist eine andere Nachricht als einer, der nichts bringt und die Zeit um die Hälfte streckt. Mediane über alle Zellen:
| Variante | Tokens | vs. nackt | Sekunden | vs. nackt |
|---|---|---|---|---|
nackt | 707 | — | 6,9 | — |
schritte | 769 | +9 % | 10,2 | +49 % |
rolle | 711 | ±0 % | 8,7 | +25 % |
beispiel | 662 | −6 % | 7,3 | +6 % |
Die auffälligste Zeile ist schritte: neun Prozent mehr Token, aber neunundvierzig Prozent mehr Wanduhrzeit. Die Differenz steckt nicht in der Länge der Antwort, sondern darin, dass längere Ausgaben häufiger ins Token-Limit laufen und der Lauf dann bis zum Anschlag weiterrechnet — schritte hat elf abgeschnittene Zellen gegenüber drei bei nackt.
beispiel ist der stille Gewinner der Kostentabelle: sechs Prozent weniger Token als nackt, nur sechs Prozent mehr Zeit — und bei extrakt trotzdem +8. Ein gelöstes Beispiel voranzustellen ist der einzige der drei Tricks, der in dieser Messung nennenswert hilft, ohne nennenswert zu kosten.
Formtreue
Getrennt gezählt, weil es ein Formfehler ist und kein Denkfehler: wie oft stand das Ergebnis wirklich in der letzten Zeile, wie gefordert? beispiel 123 von 132, nackt 120, rolle 117, schritte 115. Wer das Modell zum Ausformulieren bringt, bekommt häufiger Text nach dem Ergebnis.
Hierhin gehört auch ein Fehler von mir. Meine erste Prüfroutine erkannte ### ERGEBNIS: … nicht und hätte korrekt antwortende Modelle mit null Prozent bewertet. Gefunden habe ich das nur, weil ich die Ausgaben gelesen habe statt die Punktzahlen. Später kam derselbe Fall noch zweimal — einmal ein fehlendes Stopp-Token, einmal ein einzelner vertippter Buchstabe im Antwortmarker, sechs Zellen mit vollständig richtiger Lösung als null bewertet. Jede auffällig runde Null ist verdächtig, besonders ein exaktes null von N.
Was das nicht zeigt
- Vier Aufgaben sind vier Aufgaben. Sie sind kurz, eindeutig prüfbar und decken kein offenes Schreiben ab.
- Die Varianten liefen innerhalb eines Modells nacheinander; ein Reihenfolgeeffekt ist nicht ausgeschlossen, nur unwahrscheinlich gemacht.
- Die drei Durchgänge je Zelle sind keine Seed-Variation. Nachgemessen liefern
ornith:35bundqwen3.6:27büber alle drei Seeds byteidentische Ausgaben, währendqwq:32bbei identischem Seed unterschiedlich antwortet. Die drei Durchgänge fangen Streuung ab, wo es welche gibt — sie prüfen nicht die Wirkung des Seeds. - Gemessen wurde mit
think=false. Fürqwq:32bunddeepseek-r1:14bist inzwischen belegt, dass dieser Schalter nicht steuert, ob gedacht wird — die Einschränkung „mit abgeschaltetem Denkmodus“ gilt also nicht für alle Modelle in dieser Tabelle. laguna-xs-2.1läuft hier in der reparierten Fassung mit ergänzter Stopp-Angabe. Ohne sie wären alle 48 Zellen ins Token-Limit gelaufen und die Zeile wäre eine Aussage über die Verpackung gewesen, nicht über das Modell.
Die Hardware und die Regeln, denen jede Messung auf dieser Seite folgt, stehen auf Wie ich messe.
Was ich davon mitnehme
Für Aufgaben, an denen ein Modell sichtbar arbeiten muss — Extraktion mit Zwischenschritten, mehrstufige Rechnung —, ist „denk Schritt für Schritt“ die stärkste der drei Anweisungen und ihre halbe Minute wert. Für Aufgaben, die das Modell direkt sieht, ist sie ein Rückschritt. Und ein gelöstes Beispiel voranzustellen kostet fast nichts und hilft fast überall ein bisschen.
Was ich nicht mehr tun werde: einen Prompt-Trick pauschal einschalten, weil er in einem Leitfaden steht. Auf plan hätte mich das sieben von dreiunddreißig Zellen gekostet.