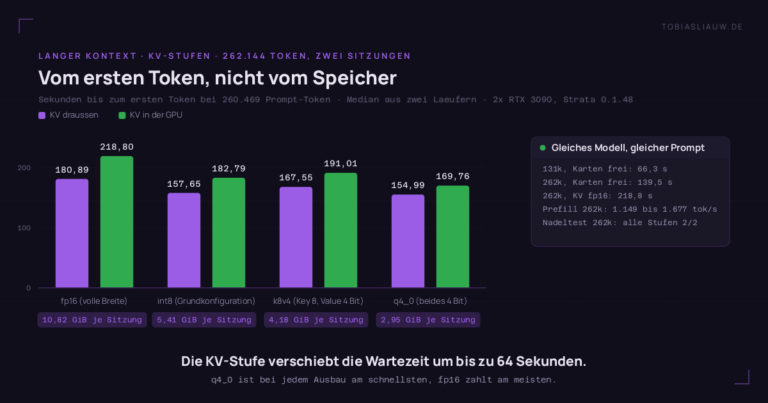
Vier KV-Stufen, zwei Nächte: 139 Sekunden bis zum ersten Token — und was die Kompression nicht kostet
KV-Cache von fp16 bis q4_0, 8.192 bis 262.144 Token, ein bis acht Sitzungen auf zwei RTX 3090: Der Flaschenhals ist die Zeit bis zum ersten Token,…
Blog
Infrastruktur, KI, Werkzeuge – und die Entscheidungen dahinter.
KV-Cache von fp16 bis q4_0, 8.192 bis 262.144 Token, ein bis acht Sitzungen auf zwei RTX 3090: Der Flaschenhals ist die Zeit bis zum ersten Token,…
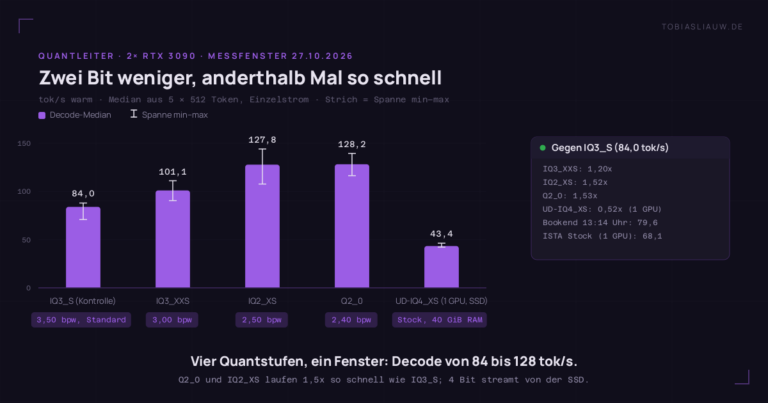
Vier Quantstufen eines Experten-Modells, ein dichtes 27B mit MTP und ein 321B-MoE mit CPU-Offload auf zwei RTX 3090: 2 Bit sind 1,53 Mal so schnell, kosten…
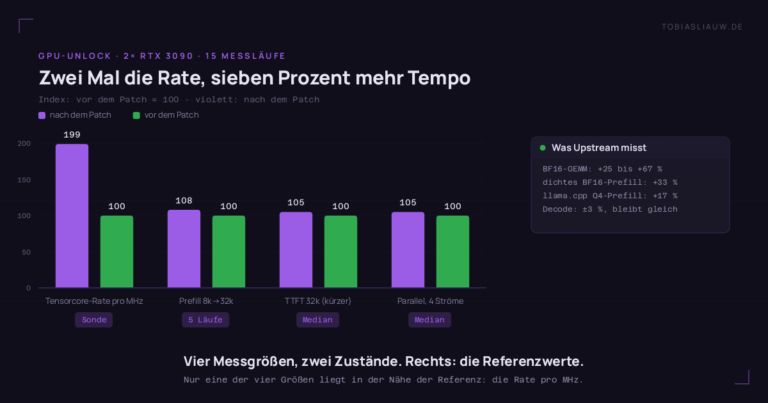
Ein Kernel-Modul schaltet die halbierte Rechenrate der GeForce-Karten frei. Ich habe nachgemessen: Die Rate pro Taktzyklus ist wirklich doppelt so hoch — mein Sprachmodell wird davon…
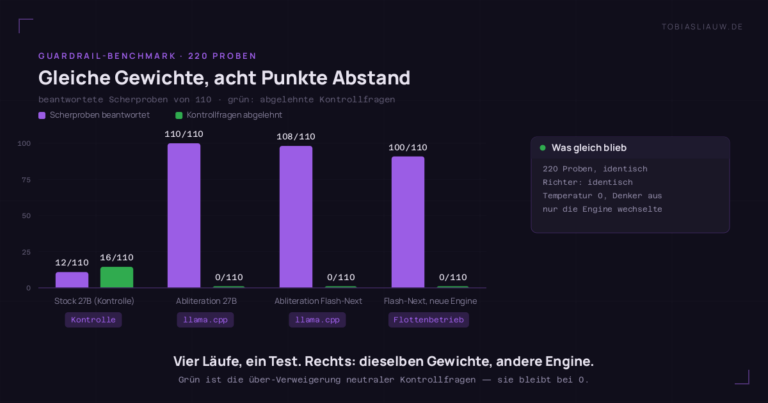
Dasselbe Modell, dieselben 220 Proben, derselbe Richter, Temperatur null: auf llama.cpp beantwortete es 108 von 110 Scherproben, auf der neuen Engine nur 100. Über-Verweigerung in beiden…
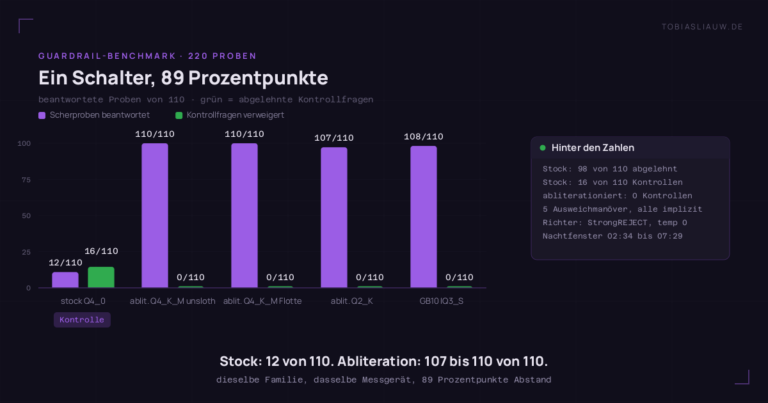
Ein Guardrail-Test fragt nicht, ob ein Modell gut antwortet, sondern ob es überhaupt antwortet. Fünf Builds derselben Familie: der Stock-Build beantwortete 12 von 110 Scherproben und…
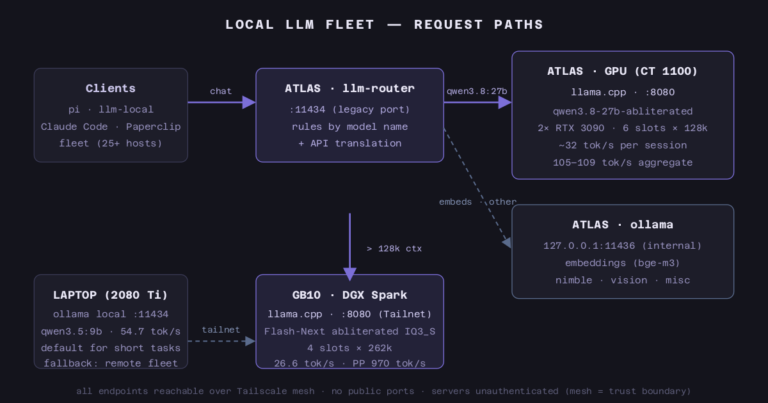
Ein Dual-3090-Server mit sechs 128k-Plaetzen, ein DGX-Spark fuer alles ueber 128k, ein Laptop, der schneller ist als beides - und ein 200-Zeilen-Router, der alle Clients am…
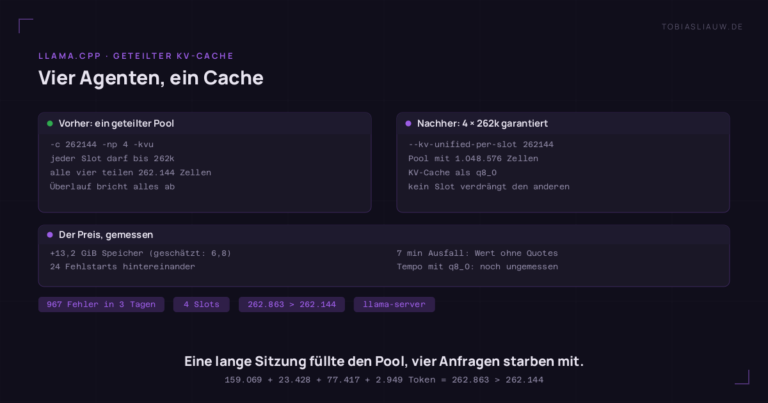
Mein Coding-Agent brach immer wieder mit Error: Context size has been exceeded ab. Seine Statuszeile zeigte 16,7 % von 262k, also rund 44.000 Token. Die automatische Verdichtung…
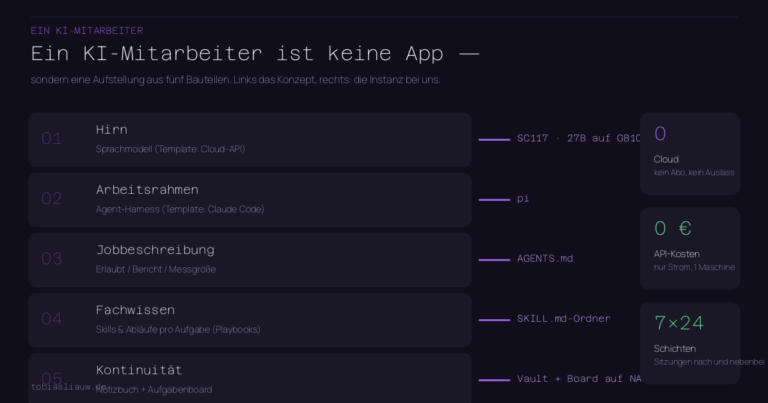
Aus einem einzigen Arbeitsrechner wird ein Buro: lokales Sprachmodell als Gehirn, Agent-Harness als Arbeitskraft, Skills und Notizen als Betriebswissen. Fuenf Bauteile, drei Hirne, null Cloud.
Am 10. Oktober hatte ich eine GB10 mit einem einzigen Modell und einer einzigen Frage beladen: Was kostet das Kontextfenster auf 124,5 GB, und reicht ein…
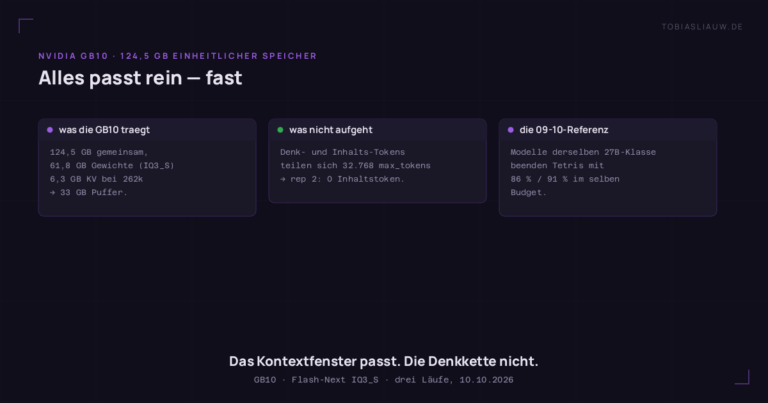
Eine Nvidia-GB10 hat 124,5 GB gemeinsamen Speicher. Ich habe daraus ein einzelnes Modell gemacht, gemessen, wo das Kontextfenster endet - und Tetris gezuehlt.