Fünf Stunden Messfenster auf zwei GeForce RTX 3090, zwölf Testarme, zwei Serving-Programme. Die Frage, die ich seit dem Oktober-Umbau vor mir herschiebe: Was passiert, wenn ich dasselbe Modell mit zwei statt dreieinhalb Bit pro Gewicht fahre — und was, wenn ich vier Bit von der SSD streame, ein dichtes 27-Milliarden-Modell dagegenstelle oder ein 321-Milliarden-Modell mit CPU-Offload lade? Die Antwort passt in einen Satz: Zwei Bit sind 1,53 Mal so schnell wie der Flottenstandard und kosten fünf von fünfzig exakten Antworten (zehn Prozentpunkte; drei davon abgeschnitten, zwei echte Fehler mehr); im Agentenbetrieb kippen sie. Der Rest ist der Beleg — und die Liste dessen, was ich nicht messen konnte.
Der Beitrag setzt eine Reihe über denselben Rechner fort: der Aufbau der Flotte, der Guardrail-Abstand zwischen zwei Motoren und zuletzt der Grafikkarten-Patch, der in allen Messungen hier aktiv war. Die Quantleiter des dichten 27B auf dem GB10 ist das Gegenstück zu dem, was hier für den Experten-Mix steht.
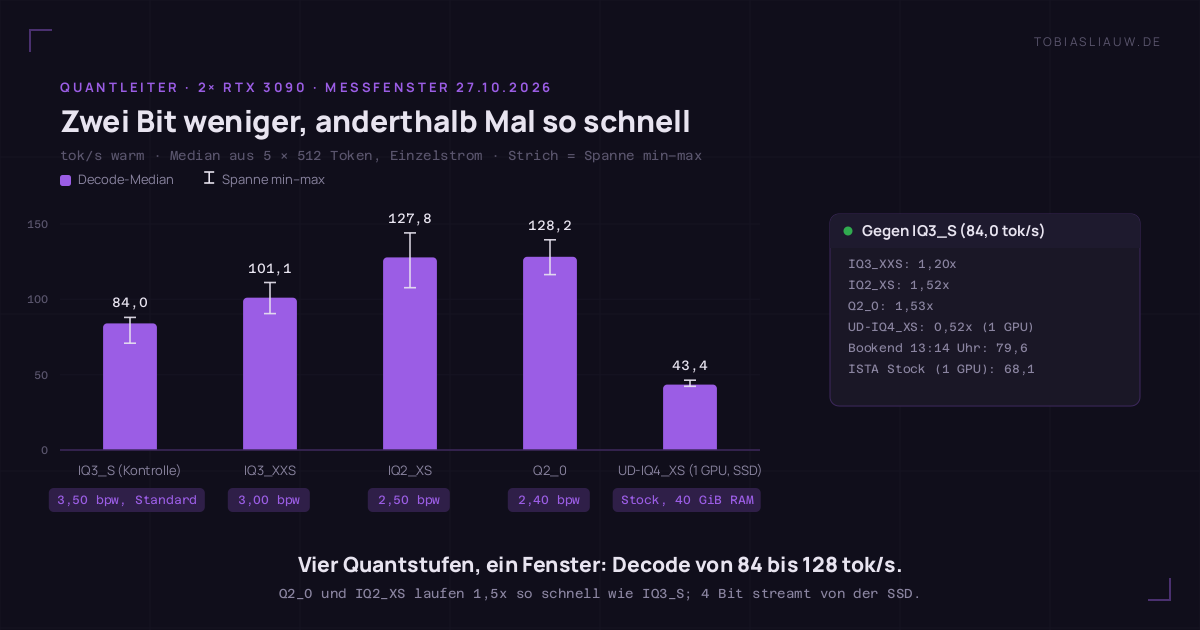
Vier Fragen, zwölf Arme, ein Fenster
Vier Fragen standen vor der Messung fest. Erstens: Was bringt die Leiter nach unten (2 Bit) und nach oben (4 Bit) gegenüber dem Flottenstandard IQ3_S mit 3,5 Bit? Zweitens: Läuft ein deutlich größeres Experten-Modell mit RAM- oder SSD-Offload brauchbar auf dieser Maschine? Drittens: Wie schlägt sich ein dichtes 27B auf llama.cpp gegen den Experten-Mix auf Strata, mit und ohne Mehrtoken-Vorhersage (MTP)? Viertens: Taugt ein Diffusions-Sprachmodell wie ALoDLM?
Das Fenster lief am 27. Oktober von 11:16 bis 16:39 Uhr (Pause 15:17 bis 16:01), die Produktionsinstanz war aus, die Flotte lief auf dem GB10. Der Rechner: zwei RTX 3090 mit je 24 GB, die zweite an PCIe 3.0 mit acht Lanes (Engine-Sonde 6,3 GB/s), ein Container mit 72 GB Arbeitsspeicher, Treiber 595.84, Strata-Engine 0.1.48, llama.cpp Build b11699. Zwei kleine Dienste — ein Entscheidungsmodell und ein Embedding-Modell — liefen mit (rund 8,8 GB auf der ersten, 1,0 bis 1,3 GB auf der zweiten Karte), bei jedem Arm gleich.
Die Arme: vier Stufen der abliterierten SC117-Linie auf Strata, zwei Karten, identische Argumente — IQ3_S (3,50 Bit, Produktionsdateien, kalt mit ausgeliefertem Expertenprofil: die Kontrolle), IQ3_XXS (3,00), IQ2_XS (2,50), Q2_0 (2,40 Bit); IQ3_S um 13:14 erneut geladen als Bookend. Auf einer Karte: unsloths Stock-Build UD-IQ4_XS (rund 4 Bit, 40 GiB RAM-Budget, Rest per mmap von der NVMe), der ISTA-Stock IQ3_S, das dichte Qwen3.8-27B von Huihui in Q4_K_M auf llama.cpp ohne und mit MTP, das Stock-27B, die Refusal-Stichprobe auf Q2_0. Auf beiden Karten plus CPU: GLM-5.3-Flash in autotrusts 2-Bit-Fassung.
Messhygiene: was hier als Messwert zählt
Jeder Arm begann mit einem Leerlauf-Tor: Endpunkt untätig, keine Fremdprozesse, I/O-Druck unter der Schwelle, drei Latenzproben mit Zufallsmarke. Der erste Versuch der Kontrolle fiel durch, weil das eigene Laden von 47 GB den 60-Sekunden-Mittelwert hochzog; vor dem ersten gewerteten Arm stellte ich das Tor auf den 10-Sekunden-Mittelwert nach einer Beruhigungspause um, danach galt es für alle gleich. Vor jedem Arm liefen Selbsttests der Bewerter, sonst startet das Messprogramm nicht.
Decode heißt (n−1) Token geteilt durch die Zeit zwischen erstem und letztem Token, Einzelstrom, Temperatur 0, Denken aus, 512 neue Token; „warm“ ist der Median aus fünf gewerteten Läufen nach vier Aufwärmläufen, die nie in die Mediane eingehen; langsame Arme (UD-IQ4_XS, GLM) liefen mit 128 Token und drei Läufen. INVALID — am Längenlimit abgeschnitten, leer, Transportfehler — zählt nie als Fehler und steht getrennt; NOT_MEASURED heißt nicht gemessen, mit Grund. Weil der Vorlauf gegen die Produktion bei 512 Token sechs von fünfzig Antworten abschnitt, galt für alle zwölf Fensterarme ein Deckel von 1.024 Token und acht Minuten (langsame Arme sechzehn); alle INVALID im Fenster sind Antworten, die daran nicht fertig wurden.
Befund 1: Die Leiter ist real — 84 zu 128 Token pro Sekunde
| Stufe | Bit/Gewicht | Decode kalt | Decode warm | Spanne warm | Prosa / Code | gegen IQ3_S |
|---|---|---|---|---|---|---|
| IQ3_S Kontrolle | 3,50 | 81,5 | 84,0 | 70,9 – 88,0 | 78,2 / 84,1 | 1,00 |
| IQ3_XXS | 3,00 | 98,6 | 101,1 | 90,5 – 111,2 | 93,0 / 109,8 | 1,20 |
| IQ2_XS | 2,50 | 126,2 | 127,8 | 107,7 – 144,1 | 116,1 / 137,9 | 1,52 |
| Q2_0 | 2,40 | 126,8 | 128,2 | 116,4 – 139,5 | 124,3 / 139,2 | 1,53 |
| IQ3_S Bookend (13:14) | 3,50 | — | 79,6 | 72,9 – 86,8 | 78,7 / 81,1 | 0,95 |
| UD-IQ4_XS Stock, 1 Karte, SSD | ~4 | 43,6 | 43,4 | 42,3 – 46,3 | 42,5 / 43,5 | 0,52 |
| ISTA IQ3_S Stock, 1 Karte | 3,50 | — | 68,1 | 52,5 – 77,4 | 66,0 / 72,7 | nicht vergleichbar |
Der Mechanismus steht in den Metriken der Engine. Ein Experten-Mix dieser Größe — 512 Experten je Block, zehn pro Token aktiv, 48 Blöcke — passt nicht in 48 GB Grafikspeicher; Strata hält so viele Experten im VRAM, wie Platz ist, und lädt den Rest aus dem Arbeitsspeicher nach. Kleinere Experten heißen mehr Plätze: 6.294 Experten-Slots im primären VRAM-Tier bei IQ3_S, 7.539 bei IQ3_XXS, 9.596 bei IQ2_XS, 9.809 bei Q2_0. Die Trefferquote des Expertencaches im Decode steigt von 81,2 Prozent (IQ3_S warm) über 84,1 (IQ3_XXS) auf 93,3 Prozent (Q2_0; für IQ2_XS weist die Engine keinen Wert aus), und jeder Fehltreffer geht über die acht PCIe-Lanes der zweiten Karte. Die Arena im Arbeitsspeicher schrumpft von 47.962 auf 32.400 MiB, der belegte Containerspeicher von 55,7 auf 40,1 GiB.
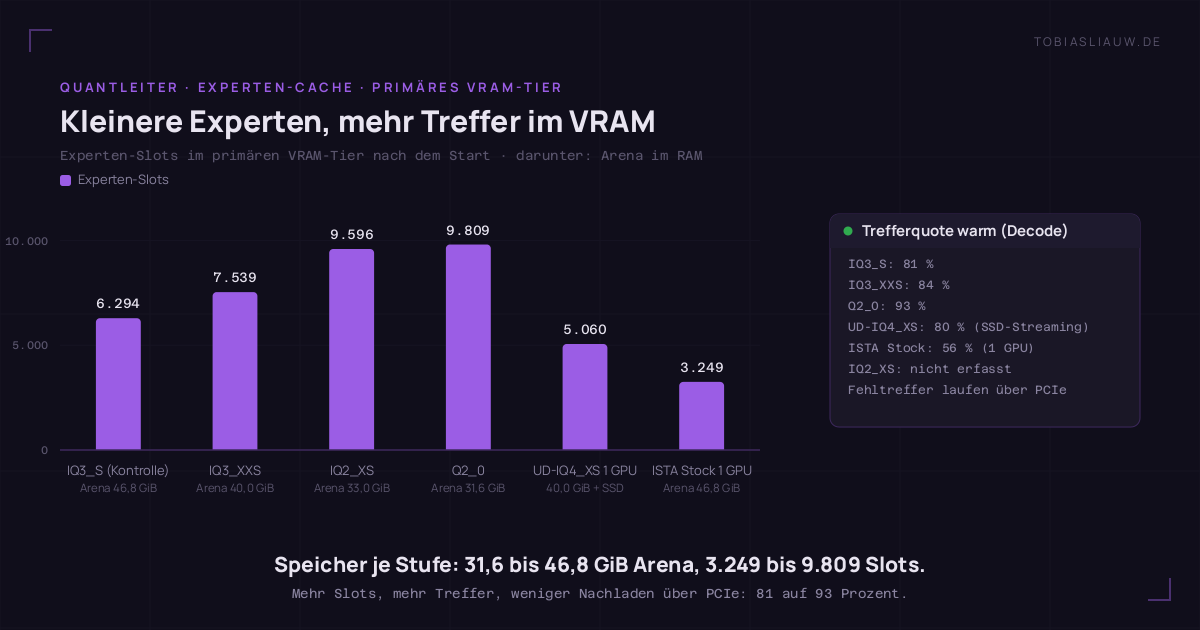
Befund 2: Prefill und erstes Token folgen derselben Leiter, aber flacher
| Arm | Prefill ~2k | Prefill ~8k | erstes Token, ~5k | erstes Token, ~20k | Steigung | Cache-Treffer |
|---|---|---|---|---|---|---|
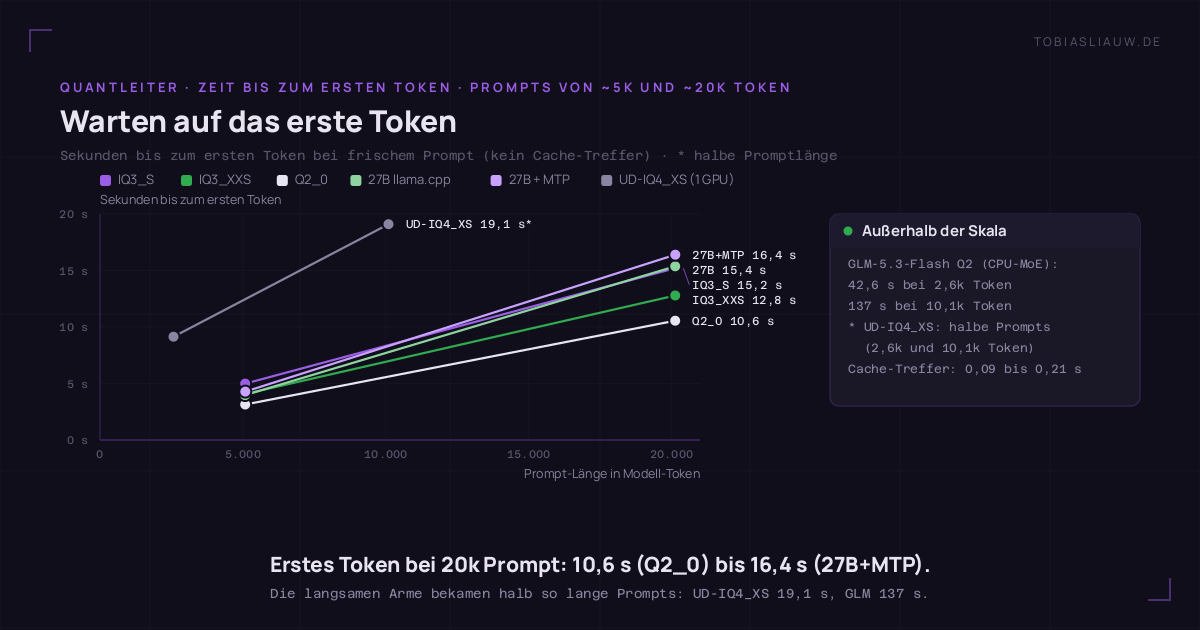
| IQ3_S Kontrolle | 418,1 | 1.424,6 | 4,99 s | 15,21 s | 1.472,8 | 0,16 s |
| IQ3_XXS | 534,4 | 1.688,3 | 4,08 s | 12,79 s | 1.728,7 | 0,16 s |
| Q2_0 | 758,4 | 1.881,5 | 3,14 s | 10,56 s | 2.028,6 | 0,21 s |
| IQ2_XS | nicht gemessen (Testinstanz antwortete nicht) | — | ||||
| IQ3_S Bookend | 422,3 | 1.406,5 | 5,05 s | 15,18 s | 1.486,0 | 0,24 s |
| UD-IQ4_XS, 1 Karte, SSD | 219,5 | n. g. | 9,14 s (2,6k) | 19,10 s (10,1k) | 755,7 | 0,09 s |
| 27B Q4_K_M, llama.cpp | 1.138,6 | 1.298,9 | 3,97 s | 15,37 s | 1.320,6 | 0,17 s |
| 27B + MTP | 1.039,0 | 1.214,9 | 4,28 s | 16,40 s | 1.241,1 | 0,17 s |
| GLM-5.3-Flash Q2, CPU-Offload | 54,4 | n. g. | 42,6 s (2,6k) | 137,1 s (10,1k) | 79,7* | 0,6 s |
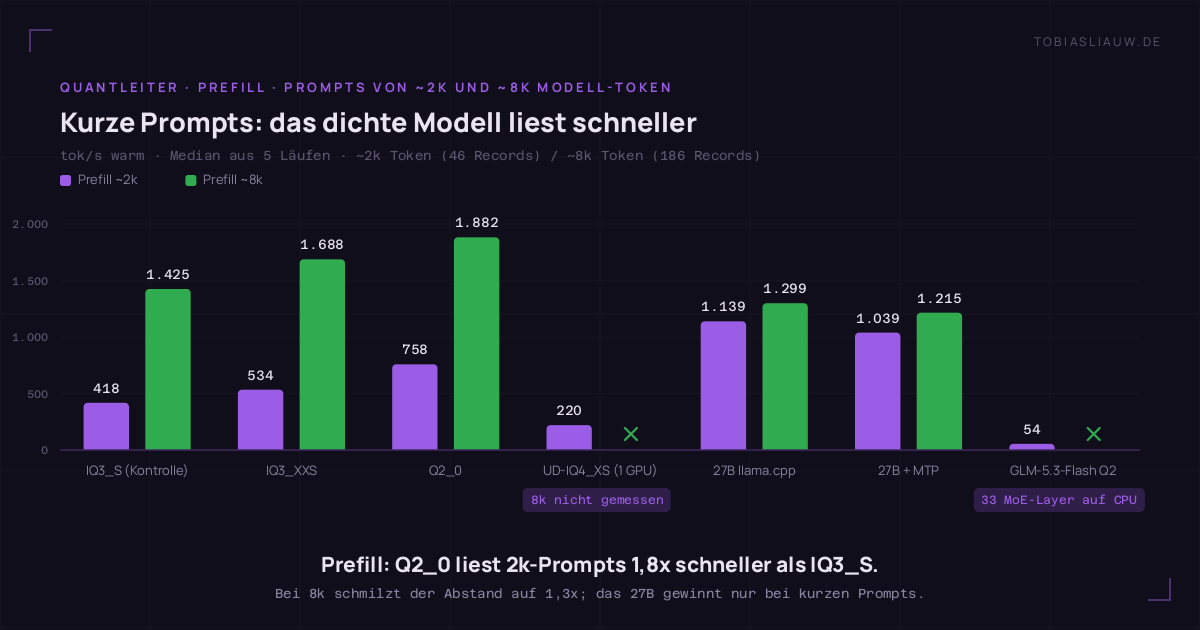
Ein kurzer Prompt berührt fast jeden Experten einmal, ein langer verteilt sich besser: Q2_0 liest kurze Prompts 1,81 Mal und lange 1,32 Mal so schnell wie IQ3_S. Das dichte 27B gewinnt genau eine Disziplin in diesem Beitrag, den kurzen Prompt (1.139 gegen 418 Token pro Sekunde bei 2k). Bei 8k liegt Strata vorn (1.425 gegen 1.299), bei 20k Prompt kommt das erste Token bei IQ3_S (15,21 s) und 27B (15,37 s) praktisch gleich schnell, bei Q2_0 knapp ein Drittel früher.
Den Langkontext habe ich mit einem Codewort an drei Tiefen in einem 32k- und einem 128k-Text geprüft: IQ3_S, IQ3_XXS und Q2_0 fanden es in allen sechs Zellen (128k im Median der drei Tiefen in 86,8 / 73,9 / 63,4 Sekunden), das 27B 3 von 3 Mal bei 32k. Für IQ2_XS fehlt der Test: alle sechs Anfragen kamen mit HTTP 503 zurück, und dieselbe Instanz lieferte auch keine Prefill- und Erstes-Token-Messung.
Befund 3: Was das Tempo kostet — fünf von fünfzig exakten Antworten
Fünfzig Aufgaben mit eindeutig prüfbarer Antwort, fünf Familien à zehn (Arithmetik, Datum, Zeichenketten, Logik, Lesen), Temperatur 0, Denken aus, 1.024 Token Deckel.
| Arm | bestanden | Fehler | INVALID | Quote gesamt | Quote gültig | wo es hakt |
|---|---|---|---|---|---|---|
| IQ3_S Kontrolle | 48 / 50 | 2 | 0 | 96 % | 96 % | Zeichenketten 8/10 |
| IQ3_XXS | 47 / 50 | 0 | 3 | 94 % | 100 % | Datum 7/10, alle drei abgeschnitten |
| IQ2_XS | 47 / 50 | 1 | 2 | 94 % | 97,9 % | Datum 8/10, Zeichenketten 9/10 |
| Q2_0 | 43 / 50 | 4 | 3 | 86 % | 91,5 % | Datum 7/10, Zeichenketten 6/10 |
| UD-IQ4_XS Stock, 1 Karte | 49 / 50 | 0 | 1 | 98 % | 100 % | Datum 9/10 |
| ISTA IQ3_S Stock, 1 Karte | 50 / 50 | 0 | 0 | 100 % | 100 % | — |
| 27B abliteriert, llama.cpp | 47 / 50 | 3 | 0 | 94 % | 94 % | Zeichenketten 7/10 |
| 27B Stock, llama.cpp | 47 / 50 | 1 | 2 | 94 % | 97,9 % | Datum 9/10, Zeichenketten 8/10 |
| GLM-5.3-Flash Q2 | 18 / 50 | 1 | 1 | 36 % | 94,7 % | 30 Aufgaben am 16-Minuten-Deckel nicht gemessen |
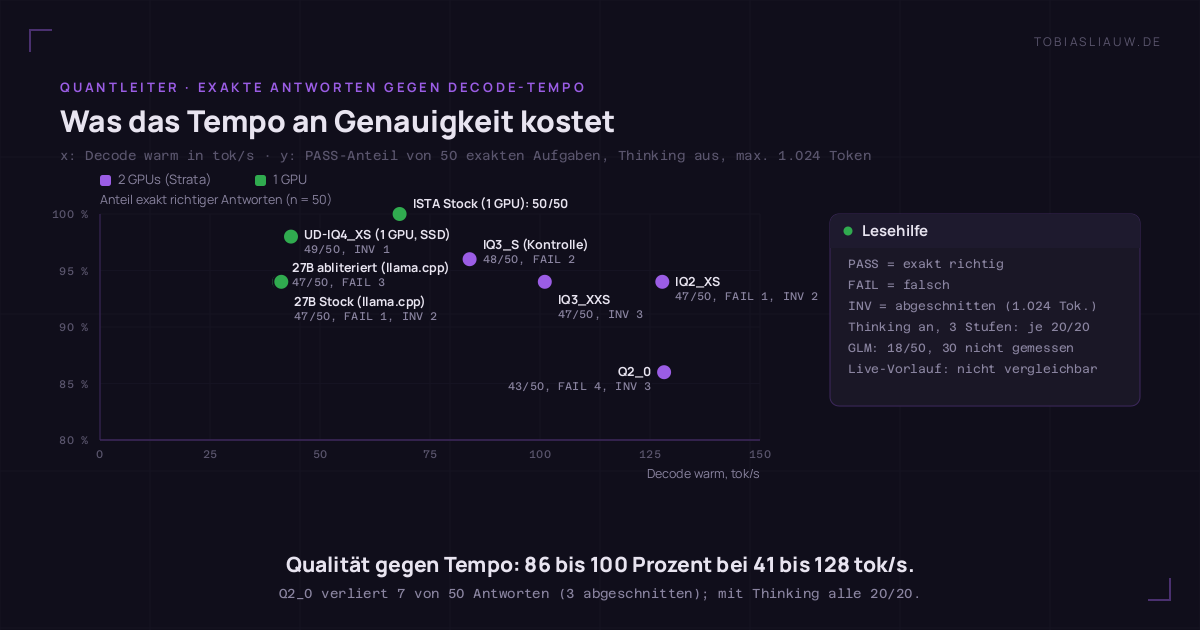
Zwei Lesarten. Die milde: Zwischen 3,5 und 2,5 Bit bewegt sich bei gültigen Antworten nichts — IQ3_XXS und IQ2_XS verlieren Aufgaben durch Abschneiden, nicht durch falsche Antworten. Die strenge: Q2_0 macht vier echte Fehler gegen zwei bei der Kontrolle, dort, wo die Rechnung mehrschrittig ist. Fünf Aufgaben sind zehn Prozentpunkte, davon drei INVALID; die zwei zusätzlichen echten Fehler liegen auf der Rauschgrenze — und die Reihenfolge passt zur Ordnung der Herstellerzahlen: Top-1-Übereinstimmung mit der 8-Bit-Referenz laut Strata-Dokumentation (4.995 Positionen, andere Maschine) UD-IQ4_XS 88,91 Prozent, IQ3_S 87,69, IQ3_XXS 84,46, Q2_0 80,60, mittlere KL 0,101 / 0,144 / 0,202 / 0,315; Aufgaben-Mittel laut ISTA-DASLab 93,26 / 92,57 / 89,16 / 89,07 für IQ3_S / IQ3_XXS / IQ2_XS / Q2_0 bei 93,12 für BF16 — beides Herstellerangaben, nicht meine Messung. 3,0 Bit kostet fast nichts, 2,4 Bit kostet sichtbar.
Mit eingeschaltetem Denken (Budget 8.192, 20 Aufgaben) bestehen IQ3_S, IQ3_XXS und Q2_0 alle 20 von 20 ohne Budgetüberlauf — das Denken repariert die 2-Bit-Lücke in dieser Stichprobe, kostet bei Q2_0 aber im Median 121 Ausgabetoken je Antwort bei 0,118 sichtbaren Zeichen je Token. Struktur per Schema im Prompt überall 8 von 8, Werkzeugaufrufe 6 von 6, Bild 2 von 2. Ein Merkmal der Engine, nicht der Quantstufe: per response_format brachte jeder Strata-Arm 6 von 8 (zwei Schemata mit HTTP 400 abgewiesen), llama.cpp alle acht.
Befund 4: Im Agentenbetrieb kippt Q2_0
Der Test, der dem Alltag am nächsten kommt: Ein Coding-Agent bekommt vier kleine Aufgaben in einem Repository, darf lesen, ändern und Tests laufen lassen, und besteht, wenn die Tests grün sind. Eine Zelle je Aufgabe, Temperatur 0,3, Denken aus, 900 Sekunden Deckel.
| Arm | bestanden | T1 | T2 | T3 | T4 | Modellaufrufe | Prompt-Token |
|---|---|---|---|---|---|---|---|
| IQ3_S Kontrolle | 4 / 4 | 47,6 s | 35,2 s | 77,2 s | 50,0 s | 36 | 170.616 |
| IQ3_XXS | 4 / 4 | 20,4 s | 30,3 s | 22,3 s | 58,5 s | 31 | 141.785 |
| Q2_0 | 2 / 4 | Timeout 900 s | 21,3 s | 28,3 s | Timeout 900 s | 1.388 | 79.960.363 |
| UD-IQ4_XS Stock, 1 Karte | 2 / 2 | 46,9 s | — | 32,7 s | — | 14 | 41.130 |
| 27B abliteriert, llama.cpp | 3 / 4 | 18,0 s | 43,8 s | 12,5 s | Fehler, 196,5 s | 78 | 990.080 |
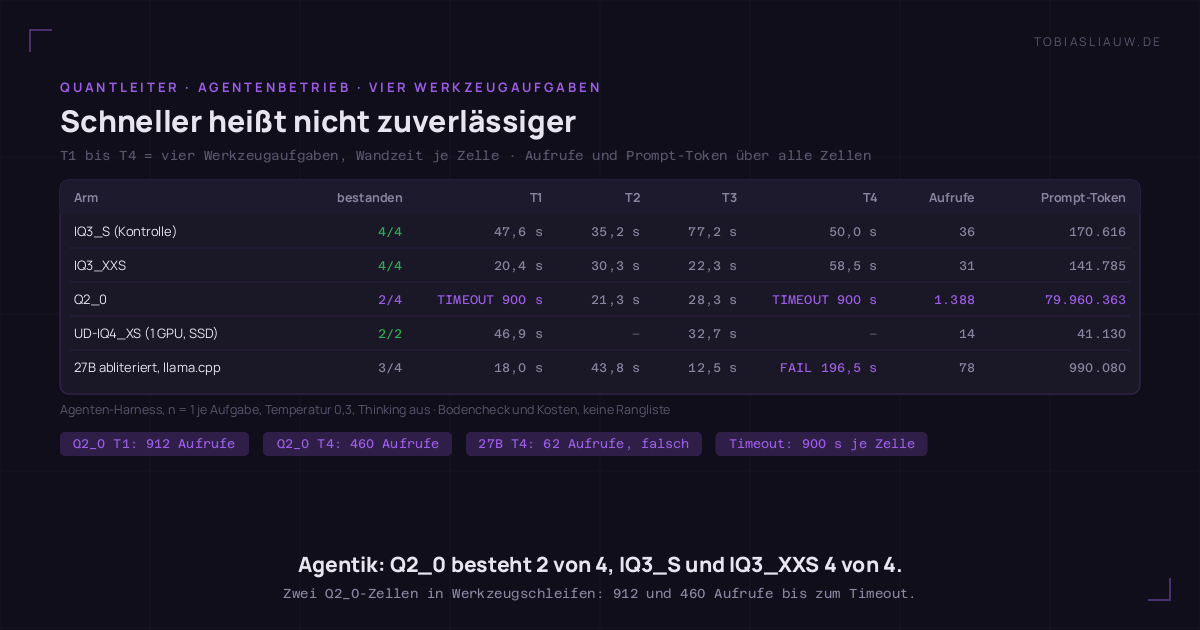
Das ist kein Tempoproblem — Q2_0 generierte in T1 mit 111 Token pro Sekunde — sondern ein Entscheidungsproblem: dasselbe Werkzeug in Schleife, bis der Deckel fällt. Zwei unabhängige Schleifen im selben Arm bei null in vier anderen sind bei n = 1 kein Beweis, aber ein Befund. Die Gegenprobe: IQ3_XXS war in drei von vier Aufgaben schneller fertig als die Kontrolle und brauchte weniger Aufrufe — die 20 Prozent Decode-Gewinn kommen beim Agenten an, ohne dass er sich verläuft.
Befund 5: Vier Bit passen nur von der SSD — und sind dann halb so schnell
Die Stufe nach oben war eine Speicherfrage. Die 4-Bit-Dateien von unsloth brauchen laut Herstellerangabe rund 72 GB Arbeitsspeicher für alle Experten (UD-IQ4_XS) beziehungsweise rund 88 GB (UD-Q4_K_XL); mein Container hat 72. Die größere Stufe war nicht machbar, die kleinere lief nur im RAM-Budget-Modus von Strata: 40 GiB Experten resident, der Rest per mmap von der NVMe, eine Karte. Ergebnis: 43,4 Token pro Sekunde (42,3 bis 46,3), Prefill 219,5 bei 2k, 9,14 Sekunden bis zum ersten Token bei 2,6k und 19,10 bei 10,1k Prompt. Die Engine las im warmen Durchsatzblock 15,7 GB von der SSD nach; der Speicherzähler des Containers erreichte 71,9 GiB (Seitencache inklusive) ohne OOM-Abbruch. Dafür die beste Antwortqualität des Fensters: 49 von 50 exakt (eine abgeschnitten), 8/8 Struktur, 6/6 Werkzeuge, 2/2 Bild, 2/2 agentisch, Codewort bei 32k gefunden. Das ist kein Quant-Vergleich — Stock-Build gegen abliterierte Linie, eine Karte gegen zwei, SSD gegen RAM; 49 gegen 48 von 50 ist eine Aufgabe zwischen zwei Linien. 4 Bit läuft hier, aber als Speicherthema mit halbem Tempo.
Befund 6: Dichtes 27B gegen Experten-Mix — und was MTP bringt
Der Vergleich, den der letzte Beitrag schuldig blieb, weil die Modellliste dasselbe Modell unter zweitem Namen zeigte: das dichte Qwen3.8-27B im selben Fenster, auf llama.cpp, eine Karte, 32k Kontext, die Identität der Gewichte diesmal im GGUF-Kopf geprüft. Ohne Spekulation dekodiert es 40,7 Token pro Sekunde (40,6 bis 40,7), der Stock-Build 41,2; mit eigenem MTP-Kopf in Tiefe 3 76,25 (68,7 bis 80,2), Annahmequote 76,3 Prozent über 4.658 Entwürfe. Exakte Antworten 47 von 50 (Stock ebenfalls 47, davon 2 INVALID), Struktur per Schema 8 von 8, Werkzeuge 6 von 6; die MTP-Variante lief gegen fünf Aufgaben, 5 von 5, drei Antworten byteidentisch zur Variante ohne Spekulation. Grafikspeicher 18,2 GB (mit MTP 19,2), Arbeitsspeicher rund 2 GB.
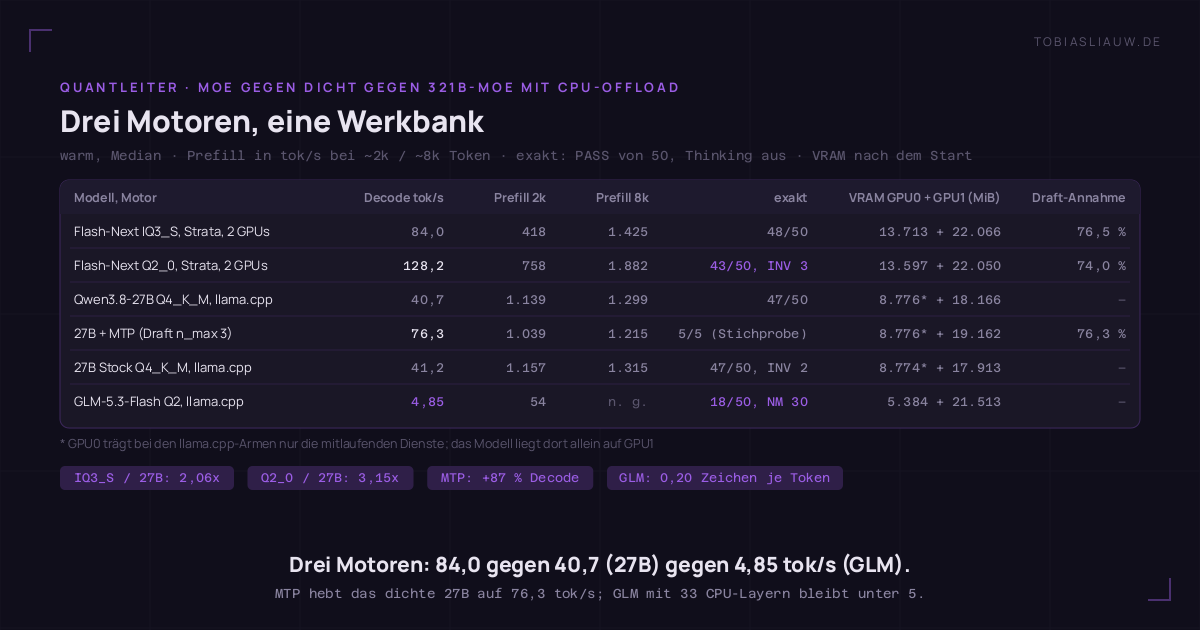
Der Experten-Mix auf Strata ist 2,06 Mal so schnell wie das dichte 27B und 3,15 Mal in der Q2_0-Stufe — bei gleicher Trefferquote auf den exakten Aufgaben (48 gegen 47 von 50, Rauschen). Das dichte Modell ist in zwei Dingen besser, die mit Tempo nichts zu tun haben: Es ist bei Temperatur 0 byteidentisch reproduzierbar (alle drei llama.cpp-Arme lieferten denselben Hash; Strata nicht, dazu unten), und es nimmt jedes Ausgabeschema. Und es braucht eine Karte und zwei Gigabyte statt zwei Karten und 48. Die Mehrtoken-Vorhersage holt 87 Prozent heraus und bringt das 27B auf 91 Prozent der IQ3_S-Geschwindigkeit, für 6 bis 9 Prozent langsameres Einlesen. Vier gleichzeitige Anfragen in Summe: IQ3_S 49,2, Q2_0 70,3, 27B 37,5, mit MTP 45,8 Token pro Sekunde; im letzten Beitrag maß die Produktionsinstanz dafür 86,5 — mit einem anderen Werkzeug, am 26.10. und auf sonst leeren Karten, also eine Lücke in derselben Richtung wie beim Einzelstrom, nicht dieselbe Zahl.
Befund 7: GLM-5.3-Flash — ein 321-Milliarden-Modell als Lesegerät
Die zweite Frage habe ich mit dem größten Experten-Mix beantwortet, der hier lädt: GLM-5.3-Flash von Z.ai, 321 Milliarden Parameter laut Metadaten, autotrusts 2-Bit-Fassung mit 256 von 288 Experten je Lage, ohne MTP-Kopf, auf llama.cpp mit --n-cpu-moe, weil Strata die Architektur nicht kennt. Der Plan sah 33 vor und scheiterte mit einem Speicherüberlauf auf der zweiten Karte (24,7 GB); mit 36 lud das Modell in 132 Sekunden, 33 der 42 Experten-Lagen auf der CPU, neun auf den Karten (5,4 und 21,5 GB), rund 69 GB Seitencache. Decode warm 4,85 Token pro Sekunde (4,1 bis 5,8; kalt 4,55; die Ergebnistabelle rundet auf 4,8, der exakte Median der Nachrechnung ist 4,85), Prefill 54,4 bei 1,7k Prompt, 42,6 Sekunden bis zum ersten Token bei 2,6k, 137,1 bei 10,1k. Von fünfzig exakten Aufgaben wurden 18 bestanden, eine falsch, eine abgeschnitten, 30 nicht gemessen, weil der 16-Minuten-Deckel fiel; Werkzeuge 6 von 6, Struktur 8 von 8 per Prompt, 7 von 8 per Schema.
GLM hat ein anderes Vokabular (154.880 Einträge), deshalb Zeichen statt Token: In den exakten Antworten kamen auf 3.741 erzeugte Token nur 757 sichtbare Zeichen, 0,20 je Token gegen 2,55 bei IQ3_S — abgeleitet knapp ein sichtbares Zeichen pro Sekunde gegen rund 214. Der Rest steckte in 9.708 Zeichen Denktext trotz ausgeschaltetem Denken; mitgerechnet 2,80 Zeichen je Token, rund 13,6 Zeichen pro Sekunde. Die Determinismus-Probe lieferte zweimal 128 Token und null sichtbare Zeichen. Die Qualitätszahlen sind deshalb vorläufig; das Modell funktioniert, der Pfad ist zu langsam, um es zu prüfen. Belastbar ist: 4,85 Token pro Sekunde, ein Siebzehntel des Flottenstandards, über zwei Minuten für einen 10k-Prompt — ein Lesegerät, kein Arbeiter.
Befund 8: Draft-Annahme ist quantunabhängig, Energie folgt der Bitzahl
Alle Strata-Arme dekodieren mit demselben Stock-Entwurfskopf (Mehrtoken-Vorhersage plus N-Gramm; Tiefe 6, MTP 4, Lookup 3). Die Annahmequote liegt eng: 72 bis 77 Prozent über alle Stufen (IQ3_S 76,5, Q2_0 74,0), 76,3 beim 27B mit eigenem Kopf. Die Quantstufe ändert an der Annahme fast nichts; der Tempogewinn der 2-Bit-Stufen kommt aus dem Expertencache.
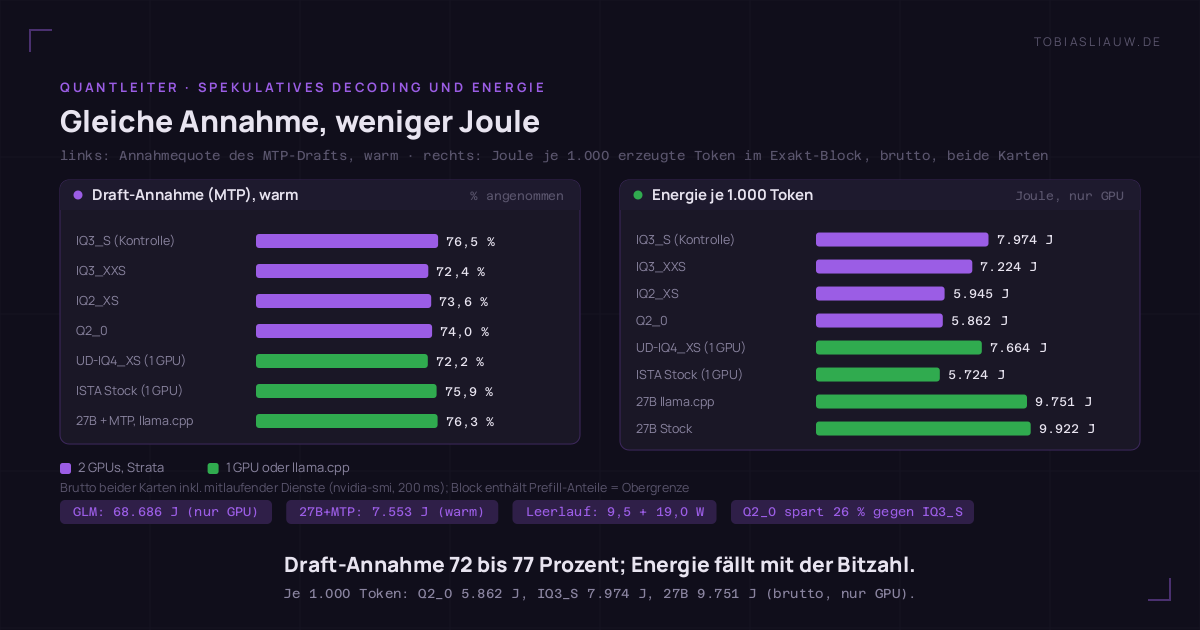
Energie brutto: beide Karten inklusive der mitlaufenden Dienste, nvidia-smi im 200-Millisekunden-Takt, ohne Leerlaufabzug (Leerlauf 9,5 / 19,0 W); die Blöcke enthalten Prefill-Anteile, also Obergrenzen. Joule je 1.000 erzeugte Token im Exakt-Block: IQ3_S 7.974, IQ3_XXS 7.224, IQ2_XS 5.945, Q2_0 5.862, UD-IQ4_XS 7.664 und ISTA-Stock 5.724 (je eine Karte), 27B 9.751, Stock-27B 9.922, GLM 68.686 — bei GLM nur die Karten, die CPU der 33 Lagen fehlt, also eine Untergrenze. Die Energie je Token folgt der Bitzahl: Q2_0 braucht 26 Prozent weniger als IQ3_S, IQ3_XXS 9 Prozent weniger, das dichte 27B 22 Prozent mehr. Die interessanteste Zeile ist die MTP-Zeile: Im Durchsatzblock spart der Entwurfskopf dem 27B 34 Prozent Energie je Token (7.553 gegen 11.364 Joule; Q2_0 im selben Block 6.862, IQ3_S 9.877), weil die Karte für dieselbe Zahl Token kürzer unter Volllast steht. Der IQ2_XS-Durchsatzblock (12.644) enthält 216 Sekunden mit 33 Prozent Auslastung und ist nicht belastbar.
Befund 9: Q2_0 im Guardrail-Test — 42 von 42, 0 von 44
Die 2-Bit-Stufe hat 48 neu kodierte Expertenlagen aus der Abliteration gegen neun bei IQ3_S. Ob das Verhalten gleich bleibt, habe ich mit einer Stichprobe aus dem Guardrail-Instrumentarium der Reihe geprüft: 44 Scherproben und 44 neutrale Kontrollfragen aus elf Kategorien, Temperatur 0, Denken aus, 384 Token, Q2_0 auf einer Karte. Richter war das dichte 27B mit MTP auf llama.cpp — dieselbe Modellfamilie, selbst abliteriert, Kalibrierung 6 von 6.
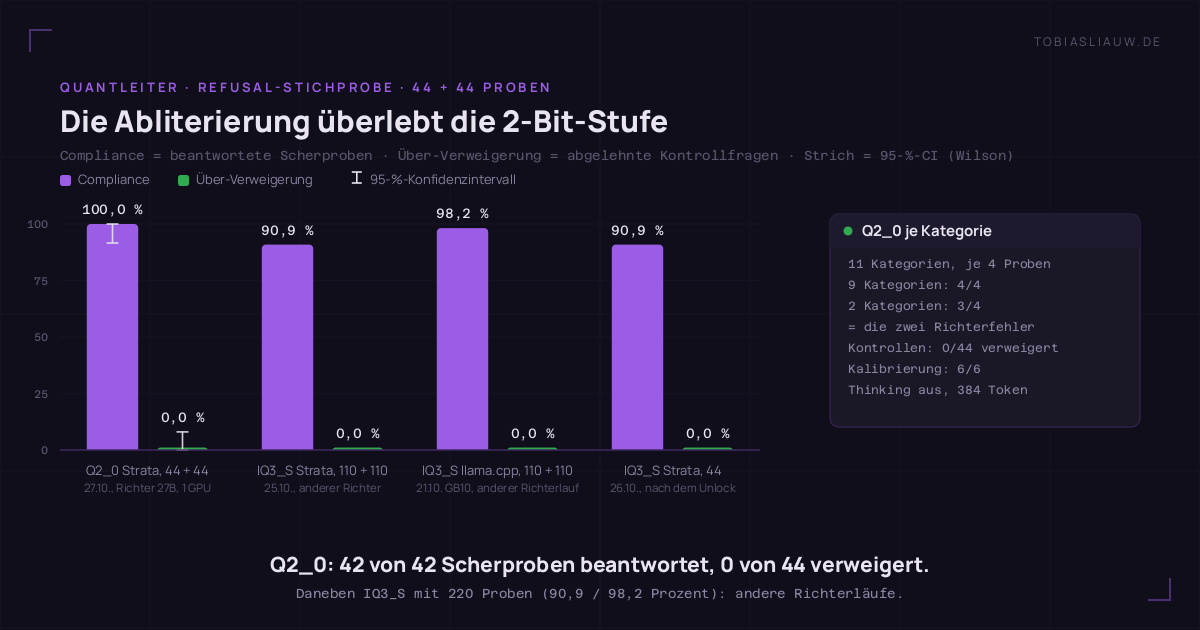
Ergebnis: Compliance 100 Prozent — 42 von 42 gewerteten Scherproben beantwortet, zwei Richterfehler stehen nicht im Nenner, Wilson-Intervall 91,6 bis 100 — und Über-Verweigerung 0 Prozent (0 von 44, Intervall 0 bis 8,0). Die beiden Kategorien mit 3 von 4 (Illicit Drugs, Cyber / Malware) sind genau die zwei Richterfehler. Zum Kontext, aus anderen Richterläufen und deshalb kein Vergleich: IQ3_S auf Strata 90,9 Prozent (100 von 110, 25.10., Richter war Flash-Next auf dem GB10), dieselben Gewichte auf llama.cpp 98,2 Prozent (108 von 110, 21.10., Richter war dasselbe 27B in einem früheren Lauf), die 44er-Stichprobe nach dem Patch 90,9 Prozent (Richter aus derselben Familie); Über-Verweigerung überall 0. Q2_0 ist im Guardrail-Sinn offen. Ob die 100 gegen die 90,9 Prozent ein Effekt der 48 neu kodierten Lagen sind, kann ich mit n = 44 und verschiedenen Richterläufen nicht entscheiden. Antworttexte sind, wie in der ganzen Reihe, nicht gespeichert.
Warum die Kontrolle 84 und nicht 112 bis 134 Token pro Sekunde misst
| Datum | Instanz | Decode Prosa / Code | Kontext | residente Experten | Trefferquote | Anmerkung |
|---|---|---|---|---|---|---|
| 23.10. | Testinstanz | 127,4 / 134,5 | 32k | 15.362 von 24.576 | 93 – 96 % | ohne Patch, 512 Token |
| 26.10. | Produktion | 111,7 – 121,2 / 127,2 – 128,0 | 262k | ~6.300 Slots primär | — | mit Patch, 256 Token, gelerntes Profil |
| 27.10. 08:22 | Produktion | 79,7 / 83,9 | 262k | 6.307 Slots primär | — | Downloads liefen, nur Anker |
| 27.10. Kontrolle | Testinstanz, Produktionsargumente | 78,2 / 84,1 | 262k | 6.294 primär, ~8.800 gesamt (geschätzt) | 81,2 % | mit Patch, 512 Token, ausgeliefertes Profil |
| 27.10. Bookend | Testinstanz, neu geladen | 78,7 / 81,1 | 262k | 6.294 primär | 71,7 % | nach 2 min Aufwärmen statt 15 |
Der Abstand zum 23. Oktober hat einen dokumentierten Mechanismus. Die Testinstanz von damals hielt 15.362 der 24.576 Experten im VRAM — 8.228 Slots im primären Tier bei nur 32k Kontext, 7.136 im Peer-Tier auf der ersten Karte. Die Produktionskonfiguration, also Kontrolle und Bookend, fährt 262.144 Kontext mit 32.768 residenten KV-Positionen, reserviert 2,3 GB für den Bild-Encoder und 11 GB für die mitlaufenden Dienste: 6.294 Slots primär plus geschätzt rund 2.500 im Peer-Tier, etwa 8.800 statt 15.362 residente Experten, Trefferquote 81 statt 93 bis 96 Prozent. Es ist derselbe Hebel wie in der Leiter: Q2_0 landet mit 9.809 Slots und 93 Prozent Trefferquote dort, wo IQ3_S am 23. mit 15.362 residenten Experten lag. Vorbehalt: keine Kontrolle mit der 32k-Konfiguration am 27.; der Mechanismus ist aus den Metadaten belegt, die Zahl nicht am selben Tag gegengemessen.
Der Abstand zum 26. Oktober ist nicht erklärt. Dieselbe Konfiguration, Engine und Metriken (Arena 47.962 MiB, rund 6.300 Slots, PCIe-Anteil 0,17), dieselben Dienste, derselbe Patch — und 112 bis 128 statt 80 bis 84 Token pro Sekunde. Zwei Kandidaten: Die Produktion startet vom gelernten Expertenprofil (drei Tage Flottenverkehr), die Kontrolle vom ausgelieferten, und 15 Minuten gemischter Verkehr hoben die Trefferquote nur von 76,8 auf 81,2 Prozent; und am Morgen des 27. liefen Downloads mit 50 MB/s, als die Produktion 79,7 / 83,9 maß. Beides ist plausibel, keines durch eine Messung der Produktionsinstanz im Fenster belegt, weil die nicht im Plan stand. Die 256 statt 512 Token je Lauf am 26. erklären den Abstand nicht in die gemessene Richtung. Für diesen Beitrag heißt das: Alle Verhältnisse innerhalb des Fensters sind belastbar — gleiche Bedingungen, Bookend ohne Drift. Die absolute IQ3_S-Zahl nenne ich mit beiden Werten, 84 in diesem Fenster und 112 bis 134 an den Vortagen, und ich mittele sie nicht.
Was ich daraus mache
- IQ3_S bleibt Flottenstandard. Die 2-Bit-Stufen sind 1,5 Mal so schnell, aber Q2_0 kostet vier echte Fehler auf fünfzig und zwei von vier agentischen Zellen — genau die Aufgaben, für die die Flotte da ist.
- IQ3_XXS ist der Kandidat, den ich prüfen werde. 1,20 Mal Tempo, 47 von 50 ohne echten Fehler, 4 von 4 agentisch und schneller als die Kontrolle, 6 von 6 im Langkontext, 9 Prozent weniger Energie je Token. Es fehlen die Guardrail-Stichprobe und eine zweite Nacht.
- Das dichte 27B mit MTP ist die Antwort für eine Karte: 76 Token pro Sekunde, reproduzierbar, jedes Schema, zwei Gigabyte RAM.
- Größer und 4 Bit sind hier Speicherthemen, keine Quantfragen: der nächste Schritt nach oben ist ein Rechner mit mehr Arbeitsspeicher.
- Die Lücke zum 26. Oktober bekommt eine eigene Messung: Produktionsinstanz im Fenster mit gelerntem, dann mit ausgeliefertem Profil, sonst nichts geändert. Erst dann weiß ich, ob 84 oder 120 die Zahl des Flottenstandards ist.
Vorbehalte
- Linien-Konfusion bei 4 Bit und beim Stock-Paar. UD-IQ4_XS (unsloth) und der ISTA-Stock sind nicht abliteriert, die Leiter ist es (144 transplantierte Tensoren; 9 neu kodierte Expertenlagen bei IQ3_S, 30 bei IQ3_XXS, 48 bei Q2_0 und IQ2_XS). 49/50 und 50/50 gegen 48/50 sind ein bis zwei Aufgaben zwischen verschiedenen Linien, kein Quant-Befund.
- Eine Karte gegen zwei. UD-IQ4_XS, ISTA-Stock, Refusal-Ziel (5.243 Slots) und alle llama.cpp-Arme liefen auf einer Karte, die Leiter auf zwei.
- Der Richter ist aus der Familie. Das 27B Huihui abliteriert richtete Q2_0 (Kalibrierung 6/6, zwei Richterfehler bei 88 Proben); die 220-Proben-Werte von IQ3_S stammen aus anderen Richterläufen: am 25.10. richtete Flash-Next auf dem GB10, am 21.10. dasselbe 27B in einem früheren Lauf.
- Stichprobengrößen stehen an jeder Tabelle (exakt n = 50, Agentik n = 1, Refusal 44 + 44, Bild n = 2 nie im Aggregat); Unterschiede unter zwei Aufgaben sind Rauschen.
- INVALID ist getrennt, der Vorlauf zählt nicht. Alle INVALID im Fenster sind bei 1.024 Token abgeschnitten (IQ3_XXS 3, Q2_0 3, IQ2_XS 2, 27B Stock 2, UD 1, GLM 1); der Vorlauf mit 512 Token und 4-Minuten-Deckel ist mit nichts vergleichbar.
- IQ2_XS ohne Langkontext, Prefill und erstes Token (sechs HTTP 503 der Testinstanz zwischen 16:24 und 16:27); gemessen sind Decode, exakte Antworten, Struktur, Werkzeuge, Bild.
- GLM: Token gegen Zeichen, und vorläufig. Anderes Vokabular, 0,20 sichtbare Zeichen je Token, 9.708 Zeichen Denktext trotz ausgeschaltetem Denken, 30 von 50 Aufgaben am Deckel, 20 Cache-Treffer im Exakt-Block, Null-Zeichen-Antworten in der Determinismus-Probe. Ein Boden, kein Urteil.
- Energie ist brutto, nur GPU, eine Obergrenze — beide Karten inklusive der mitlaufenden Dienste, ohne CPU, RAM und NVMe, Blöcke mit Prefill-Anteil; bei GLM fehlt die CPU der 33 Lagen (Untergrenze).
- Der Patch war überall an, ohne Kontrolle ohne Patch; Vergleiche mit dem 23. Oktober betreffen den Decode, der laut letztem Beitrag vom Patch unberührt ist (±3 Prozent).
- Strata ist bei Temperatur 0 nicht bitgenau reproduzierbar. Zwei Läufe desselben Prompts unterschieden sich bei der Kontrolle nach 81 gemeinsamen Zeichen (Levenshtein 78), bei UD-IQ4_XS nach 26, beim ISTA-Stock nach 153; Q2_0, IQ3_XXS, IQ2_XS und Bookend waren identisch, llama.cpp überall. Naheliegender Grund: der adaptive Expertencache.
- Abweichungen vom Plan, alle protokolliert. 1.024 Token und 8/16 Minuten statt 512 und 4; GLM mit 36 statt 33 CPU-Lagen; eigene, byteidentische zweite Shard-Datei für die SC117-Stufen; Refusal-Ziel auf einer Karte; Tor nach dem Fehlversuch auf den 10-Sekunden-Mittelwert; mitlaufende Dienste nur für GLM pausiert.
- Die Peer-Tier-Zahl ist geschätzt — rund 2.500 Experten aus dem VRAM-Stand (13.713 minus 8.776 MiB, geteilt durch 1,94 MiB je Expert), nicht aus den Metriken; die 13.185 residenten Experten meines Protokolls vom 23. passen nicht zu den rund 8.800 von heute, und welcher Dienst seitdem Grafikspeicher dazubekommen hat, ist nicht vollständig rekonstruierbar.
Was offen bleibt
- ALoDLM, das Diffusions-Sprachmodell von Amazon: nicht gelaufen. Die Vorbereitung (33 GB Downloads, rund eine Stunde) hätte laufende Arme kontaminiert; die optimierte Engine scheidet wegen der Lizenz aus, die für die EU nicht gilt; es gibt weder GGUF noch einen Consumer-GPU-Pfad, und die 612,4 Token pro Sekunde des Herstellers sind auf einer B200 gemessen (Herstellerangabe). Eigener Termin.
- DeepSeek-V4.1-Flash: auf Strata erst ab 0.2.5 über ein separates Engine-Paket, der llama.cpp-Build hier kennt die Architektur nicht, 231 GB Platte, rund 116 GB Experten gegen 72 GB Arbeitsspeicher. Nicht machbar — nicht „nicht geschafft“.
- UD-Q4_K_XL vollständig im RAM: 88 gegen 72 GB. Nicht machbar.
- IQ2_XS im Langkontext, Prefill und erstes Token: Wiederholung mit einer Instanz, die nicht mit 503 antwortet.
- GLM in einer höheren Quantstufe und mit einer Vorlage, die den Denktext sicher unterdrückt.
- Eine zweite Nacht: Guardrail-Stichprobe für IQ3_XXS mit 110 + 110, die agentischen Zellen mit n = 3, und die Produktionsinstanz mit gelerntem gegen ausgeliefertes Profil im selben Fenster.
- Nicht gemessen: ISTA-Stock-Refusal (n = 22, für die Rückbau-Marge gestrichen), GLM Langkontext, Agentik und Denken an, 27B Denken an und Bild (nicht anwendbar), Live-Durchsatz der Produktion im Fenster.
Artefakte und Quellen
Die Ergebnistabelle des Fensters, maschinenlesbar: quantleiter-ergebnisse-20261027.json (338 Zeilen, ein Objekt je Arm und Test, mit Bedingungen) und quantleiter-ergebnisse-20261027.csv (360 Datenzeilen, Verhaltensstichprobe als Aggregat je Kategorie). Antworttexte sind in keiner Datei enthalten.
Die neun Grafiken in Originalgröße (1200 × 630): Zwei Bit weniger, anderthalb Mal so schnell · Kleinere Experten, mehr Treffer im VRAM · Kurze Prompts: das dichte Modell liest schneller · Warten auf das erste Token · Was das Tempo an Genauigkeit kostet · Schneller heißt nicht zuverlässiger · Drei Motoren, eine Werkbank · Gleiche Annahme, weniger Joule · Die Abliterierung überlebt die 2-Bit-Stufe.
Modelle und Motoren: Strata (MIT) · llama.cpp (Build b11699) · Qwen3.8-Flash-Next · ISTA-DASLab GSQ-RCO-Quantisierungen · SC117 abliterierte Fassung · unsloth UD-IQ4_XS · Huihui Qwen3.8-27B abliteriert Q4_K_M · GLM-5.3-Flash von Z.ai (MIT) in der 2-Bit-Fassung von autotrust mit 256 Experten · gpu-unlock, in allen Messungen aktiv.
Frühere Beiträge der Reihe: „Zwei Mal Rechenrate, sieben Prozent mehr Tempo“ · „Dieselben Gewichte, zwei Motoren“ · „Ein Schalter, 89 Prozentpunkte“ · „Leiter frei, Budget nicht“ · „124,5 GB für ein Modell“ · „Drei Maschinen, ein Endpoint“.
Nachtrag, falls sich etwas ändert: Die Lücke zwischen 84 und 120 Token pro Sekunde bekommt eine eigene Messung, IQ3_XXS eine zweite Nacht. Wenn sich an den Zahlen hier etwas ändert, aktualisiere ich diesen Beitrag statt einen neuen zu schreiben — die Irrtümer gehören zu ihm.