Am 10. Oktober hatte ich eine GB10 mit einem einzigen Modell und einer einzigen Frage beladen: Was kostet das Kontextfenster auf 124,5 GB, und reicht ein 32.768-Token-Budget, damit ein denkendes Modell am Ende ein Tetris abgibt? Das Fenster war fast umsonst, das Budget reichte nicht. Die Folgefrage, die jetzt beantwortet ist: Drei Builds derselben 78-Milliarden-Parameter-Architektur (Qwen3.8-Flash-Next) laufen dasselbe Fenster auf derselben Maschine — wer liefert, wer denkt sich in die Lünge, und wer schlägt die Produktion?
Das hier ist also der Teil 2: drei Quantisierungen derselben 78-Milliarden-Parameter-Architektur, einmal ohne Denkkette, zweimal mit, vier Kontextstufen von 32.768 auf 262.144, zwölf gültige Läufe in zwei Tagen, dazu die Produktionsreferenz vom 9. Oktober. Die Aufgabe hat sich nicht geändert: ein vollständiges, lauffähiges Tetris als eine HTML-Datei, 16 Checks, ausgeführt und nicht nur gelesen.
Der Aufbau
- Ein Server, drei Modelle:
HuiHui IQ4_XS(97 GB),SC117 IQ3_S(79 GB) undQ4Mix(110 GB). Alle liegen im gemeinsamen Speicher mit den 124,5 GB der GB10, der KV-Cache bei 262.144 Token kostet noch einmal rund 6,4 GB, das Betriebsystem seinen Rest. Alles passt unter eine Decke, nichts wird ausgelagert. - Dasselbe Laufwerk wie am 10. Oktober:
llama-server, Flash-Attention an, KV-Cache f16, ein Modell pro Prozess, identische Sampling-Parameter, ein eigenes Seed je Lauf, jede Zelle zält erst ab drei Wiederholungen, Mediane mit Standardabweichung, abgeworfene Proben fließen nie in die Mediane ein. - Der Tetris-Prüfstand bleibt, aber er bekommt ein Budget statt einer Zeit: 32.768 Tokens. Die Denkkette ist bei den zwei größeren Builds Modell-Default — weder ich noch das Laufwerk haben sie an- oder ausgeschaltet.
HuiHuischreibt in keinem einzigen Lauf, nicht einer, einen einzigen Denkkettentoken. Das ist eine Eigenschaft dieses Builds, und es zählt mit. - Die Produktionsinstanz (Flash-Next, seit 9. Oktober auf Port 8080) wurde um jeden Lauf gestoppt und danach wiederhergestellt; die Wiederherstellung war am Ende jedes Abschnitts verifiziert. Das ist die einzige Harte-Regel der ganzen Reihe und sie hat gehalten.
Befund 1: Die Leiter ist flach
Zwölf Läufe, vier Kontextstufen, drei Modelle. Die Generierungsgeschwindigkeit pro Stufe, Öber je Stufe:
| Modell | 32k (Rep) | 64k (Rep) | 128k (Rep) | 256k (Rep) |
|---|---|---|---|---|
| HuiHui IQ4_XS | 33,56 (OK×2) | 33,61 (OK×3) | 33,86 (OK×2) | 33,57 (OK×1) |
| SC117 IQ3_S | 26,45 (OK×2) | 26,29 (GEKAPPT) | 26,32 (GEKAPPT) | 26,30 (GEKAPPT) |
| Q4Mix | 24,30 (OK×2) | 24,26 (1× Timeout) | 24,20 (GEKAPPT) | 24,20 (GEKAPPT) |
| Produktion (9. 10.) | – | – | – | 22,42 (GEKAPPT) |
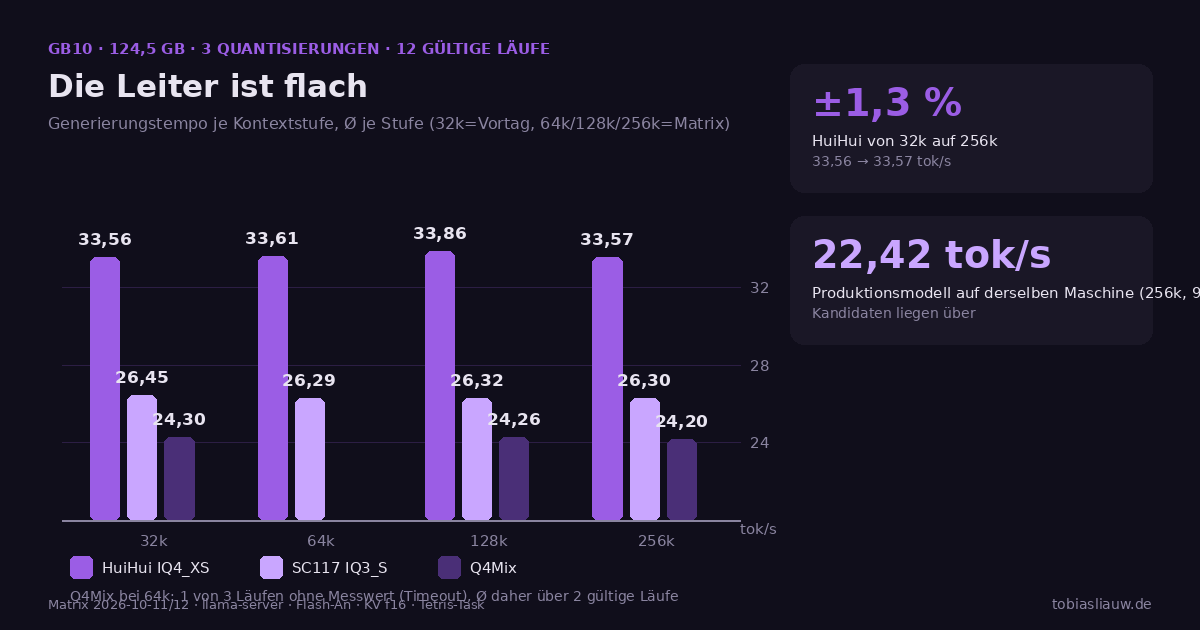
- Das Kontextfenster kostet fast nichts. HuiHui verliert von 32.768 auf 262.144 genau 0,2 %. SC117 und Q4Mix bleiben innerhalb von 1,5 %. Die 124 GB sind kein Speed-Hack, aber auch kein Speed-Handicap — der Faktor ist die Quantisierung.
- Die Quantisierung entscheidet, nicht die Kontexttiefe. 33,6 gegen 26,3 gegen 24,2 tok/s — das ist der Abstand zwischen IQ4_XS und IQ3_S und Q4Mix, und er ändert sich von Stufe zu Stufe um weniger als ein Prozentpunkt.
- Der Preis des Kontexts sitzt im Einlesen. Prefill 580–710 tok/s, erstes Zeichen 3,3–4,0 s. Der KV-Cache wird virtuell belegt und nicht vorgelesen — sonst wäre die Kurve eine andere.
Befund 2: Wer denkt, geht über Limit
Die Tetris-Aufgabe, 32.768 Token Budget. Dieselbe Aufgabe, dasselbe Laufwerk, derselbe Server — nur das Modell wechselt:
| Modell | Denkzeichen | Inhaltszeichen | Anteil | Status |
|---|---|---|---|---|
| HuiHui IQ4_XS | 0 | 97.722 | 100 % | 8/8 abgeschlossen |
| SC117 IQ3_S | 817.622 | 31.809 | 3,8 % | 6/8 am Làngenlimit |
| Q4Mix | 691.694 | 0 | 0 % | alle Läufe am Längenlimit |
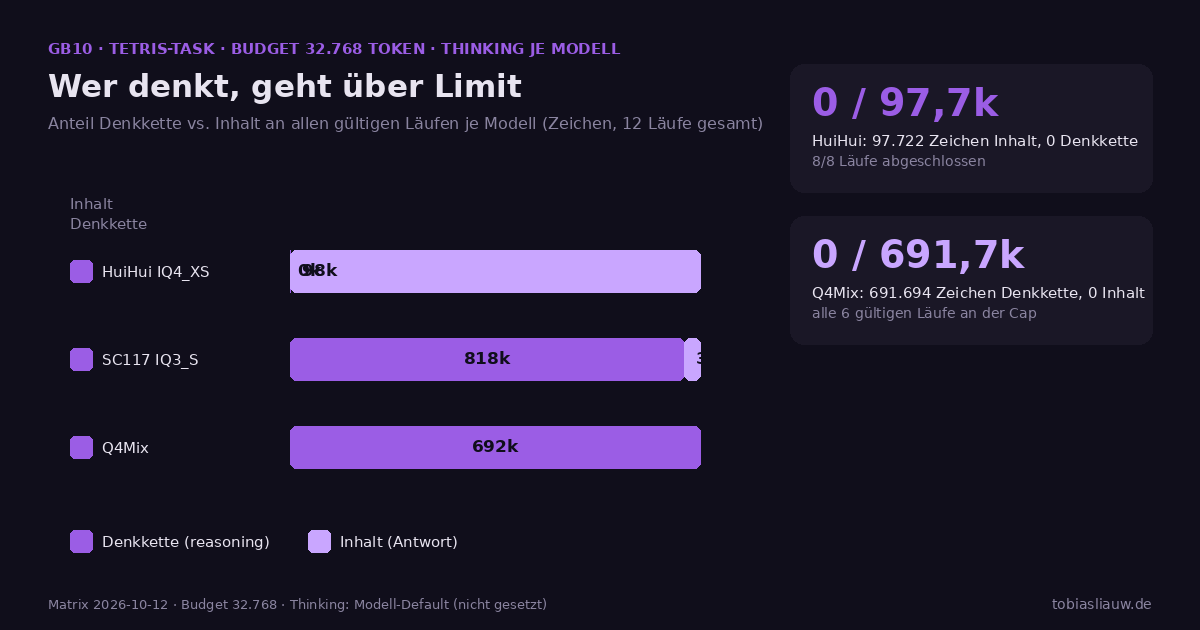
- HuiHui ist der einzige, der fertig wird. In einem Lauf nach dem anderen, bei jeder Kontextstufe, ohne über das Budget zu gehen. Nicht, weil ich seine Denkkette abgeschaltet hätte — er schreibt schlicht keine. Es ist ein eigenständiges Modell, und es liefert.
- SC117 fällt aus, aber langsam. 817.622 Zeichen Denkkette, 31.809 Zeichen Inhalt — durchschnittlich ein paar Sätze je Lauf, bevor die Cap kommt. Das ist kein Absturz und kein Fehler, es ist ein zu kleines Budget für ein denkendes Modell.
- Q4Mix erreicht nie den Inhalt. In seinen sechs gültigen Läufen (der siebte endete im Timeout) schreibt er 691.694 Zeichen, bevor er an die Cap stößt. Null Zeichen Inhalt. Das ist die schwerste Form derselben Regel: Der Denkanfang ist schneller als das Ende des Denks, und der Rest bleibt aus.
Befund 3: Alle drei liegen über der Produktion
Das Produktionsmodell (Flash-Next, seit 9. Oktober auf Port 8080) hat am 9. Oktober 22,42 tok/s auf 262k Kontext erreicht, mit einer 24-Minuten-Zeit bis zur Length-Cap. Die drei Kandidaten:
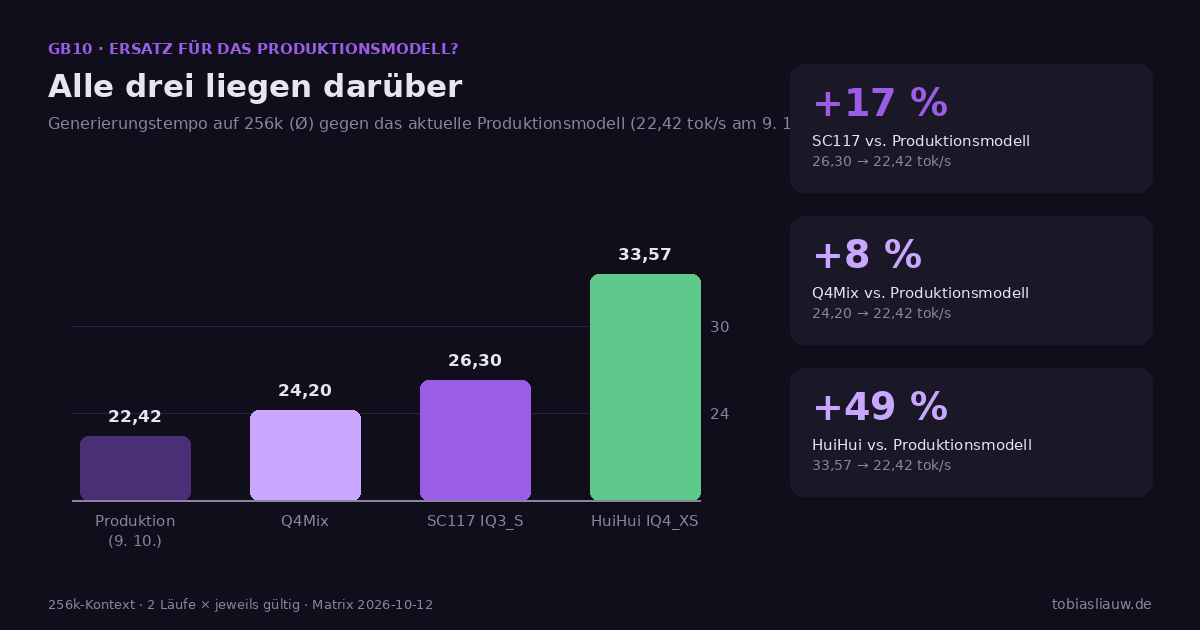
- SC117 ist dasselbe Modell wie die Produktion. 26,30 tok/s auf derselben Maschine, 17 % schneller als die Messung vom 9. Oktober. Innerhalb der Variationsstreue — die Produktionsinstanz ist nicht langsam, sie arbeitet im Rahmen dessen, was ihre Quantisierung hergibt.
- HuiHui führt um 50 %. 33,57 gegen 22,42. Und er ist der einzige, der die Tetris-Aufgabe ohne Längenlimit beendet. Für die Frage “wer kommt nächst auf den 8080er“ ist das die relevante Kombination: schneller und fertig.
- Q4Mix bleibt im Mittelfeld. 24,20 tok/s, 8 % über der Produktion, aber in keinem seiner sechs gültigen Läufe erreicht er den Inhalt. Für ein Produktionsmodell ist das ein Ausschluss, nicht eine Rangfolge.
Meine eigenen Messfehler
- Q4Mix bei 64k: zwei der drei Läufe waren ohne Messwert (Timeout). Der Stufendurchschnitt steht auf einem gültigen Lauf, nicht auf drei. Ich habe nichts geglättet.
- HuiHui bei 256k: ein gültiger Lauf, wie geplant ein Lauf. Die Stufe ist damit dünner belegt als die übrigen — der Median steht auf einer Probe.
- Die Produktionsreferenz ist vom 9. Oktober, nicht vom 11./12. Oktober. Gleiche Maschine, gleiche Quantisierung, aber ein anderer Tag — die 17 % bei SC117 sind Variationsstreue, kein Messfehler, aber auch kein Beweis für eine Trend-Verbesserung.
- HuiHui, SC117 und Q4Mix sind nicht identische Modelle, sondern drei Varianten derselben Architektur. Die Denkkette ist bei zwei an, bei einem nicht. Das ist die größte Variable in der ganzen Matrix, und ich habe sie nicht herausgenommen — sie war Teil der Frage.
Was ich daraus mache
- Die Produktionsentscheidung steht offen. HuiHui IQ4_XS ist der einzige Kandidat, der schneller ist und die Task beendete. Ob die 8080er-Instanz wechselt, entscheidet der Betreiber — nicht der Benchmark. Das Board trägt es.
- Der nächste Lauf ist Kolibri. 78B-Parameter, 3,5 Milliarden aktive je Token, Q6-K-Quantisierung (64 GB), Apache-2.0-Lizenz. Er steht auf der GB10 und wartet auf den nächsten Nachtlauf. Wenn er schneller als 33,57 ist und die Task beendete, ist er der neue Kandidat. Wenn er langsamer ist, bleibt HuiHui dran.
- Kein 128k-Budget-Test wurde gemacht. Rechnerisch hätte es gepasst (124,5 GB – 6,4 GB KV – 64 GB Gewicht = noch 40 GB Rest), aber die Läufer hatten ihre Deadlines, und ein viertes Budget hätte die Matrix verdoppelt. Es steht für den nächsten Laüf.
- Alle 13 Läufe sind öffentlich dokumentiert – vier davon sind spielbare Tetris, die vier gültigen HuiHui-Läufe (32k, 64k, 128k, 256k). Die neun übrigen Läufe – jede SC117- und Q4Mix-Stufe sowie die Produktionsreferenz – sind an der Länge-Cap von 32.768 Token geblieben, ohne je eine vollständige Datei abzuliefern; ihre Indexseiten sagen das offen und verlinken anfrage.json, antwort.txt, denkkette.txt und meta.json. Der Index listet jeden Lauf; das Scoreboard liegt daneben in JSON und in Markdown.