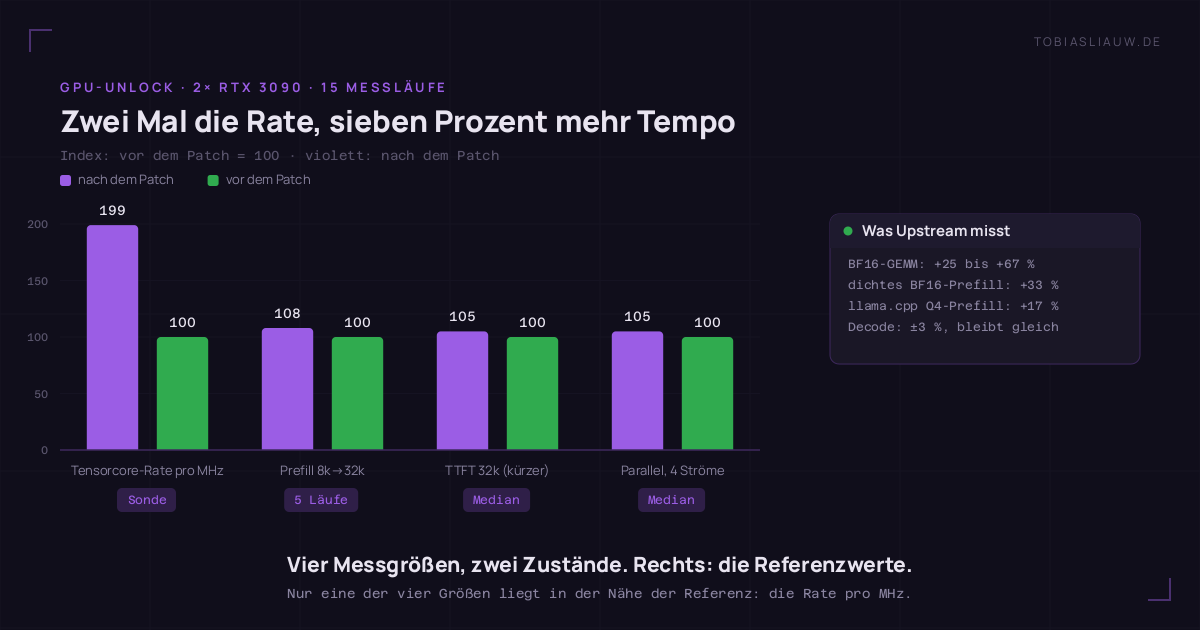
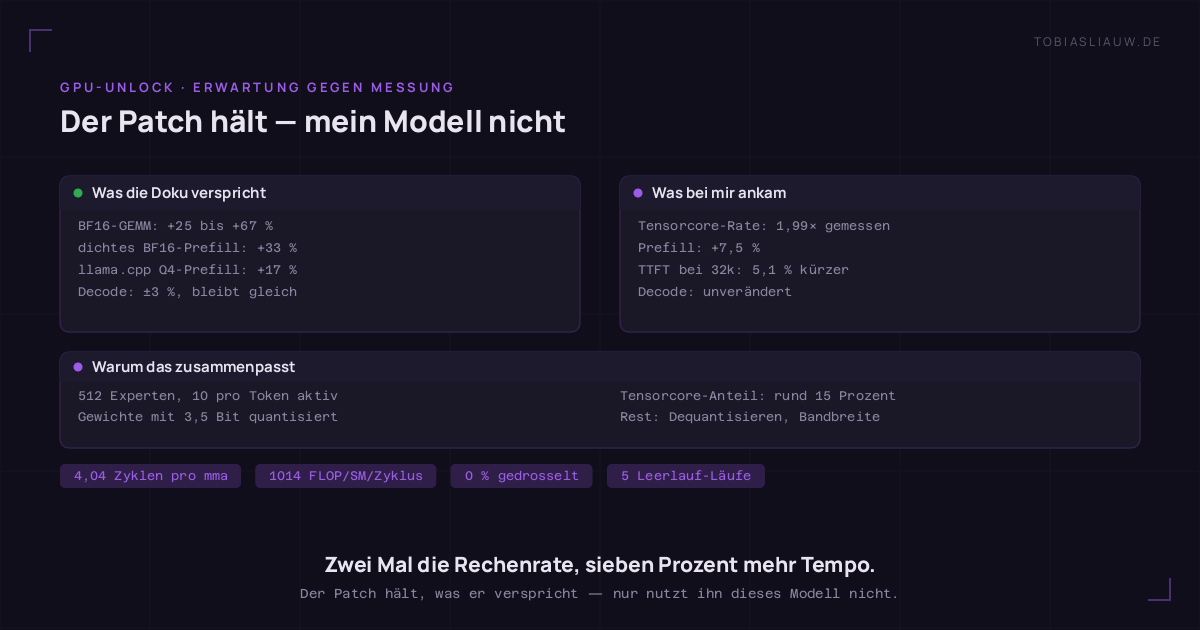
Ein Kernel-Modul verspricht, die halbierte Rechenrate der GeForce-Karten freizuschalten: zwei Mal so viele Befehle pro Taktzyklus. Nach zwei Tagen Messen steht fest: Das Modul hält genau das, was es verspricht — gemessen 1,99 Mal die Rate pro Taktzyklus, über zehn Läufe mit einer Streuung unter 0,15 Prozent. Mein Sprachmodell wird davon trotzdem nur 7,5 Prozent schneller. Dieser Beitrag ist der Versuch, beide Zahlen unterzubringen, ohne eine von beiden zu biegen.
Anlass ist ein Kernel-Modul namens gpu-unlock, das im Oktober für Aufsehen sorgte, weil es NVIDIA-Karten der 3000er-Serie eine Funktion gibt, die sie technisch hätten, aber nicht dürfen: die volle Issue-Rate ihrer Tensor-Kerne. Gemeint ist nicht Übertakten, nicht Overclocking-Spielerei, sondern ein Register, das der Hersteller pro Kartenfamilie anders einstellt. Ich habe es auf meinem Rechner mit zwei GeForce RTX 3090 aktiviert, weil ich den Prefill-Durchsatz meiner lokalen Modelle brauche — und weil ich nach zwei Tagen Messen sagen kann: Die Hardware-Zahl ist spektakulär, die Modell-Zahl ist enttäuschend, und beides ist wahr.
Alles Messbare hängt unten als Datei dran: das vollständige Messprotokoll als CSV (elf Läufe, vorher und nachher, mit Takt und Leistung der Karten vor jedem Lauf, dazu der Hash der Ausgabesonde) und der Rohtext meiner Issue-Rate-Sonde (zehn Messläufe, beide Karten, inklusive der Eichkurve). Wer die Behauptung „das Modul funktioniert“ prüfen will, braucht nur die zweite Datei.
Was das Modul überhaupt macht
NVIDIA benutzt auf denselben Chip-Varianten unterschiedliche Registerwerte für die Profikarten und die GeForce-Karten. Das Modul schreibt zwei dieser Speed-Selector — 0x88888888 für die volle BF16-Rate und 0x8 für einen weiteren Satz Befehle — und macht das vordem Treiber: Es läuft im Initramfs, also in der frühen Boot-Stufe, schreibt die Register und wirft dann einen Bus-Reset der Karte, bevor der NVIDIA-Treiber sie überhaupt übernimmt. Deshalb ist kein gepatchter Treiber nötig und kein Überschreiben der Firmware, und deshalb fällt die Sperre beim Abschalten von allein wieder weg.
Der Effekt, um den es geht, ist eine Issue-Rate: Wie viele Anweisungen die Grafikkarte pro Taktzyklus in ihre Recheneinheiten hineinschicken darf. Das ist eine Eigenschaft, die man messen kann, ohne ein Sprachmodell zu brauchen — und genau das ist der Punkt, an dem mein Versuch interessant wurde. Ich hatte kein CUDA-Toolkit auf dem Rechner, kein PyTorch, keine Rechenbibliothek des Herstellers. Also habe ich die Sonde selbst geschrieben: 208 Zeilen C, die eine Grafikkarte über den Treiber ansprechen, und 175 Zeilen von Hand geschriebenes PTX, das der Treiber zur Laufzeit selbst übersetzt. Der Quelltext ist in der Upstream-Dokumentation beschrieben, meine Fassung hängt als Messrohtext dran.
Was Upstream misst — und was dort nicht steht
Die Kompatibilitätsberichte des Projekts sind eine gute Quelle, weil sie nach Workload trennen. Wer nur die Tabelle liest, sieht „+25 bis +80 Prozent“ und denkt an Sprachmodelle. Die Tabelle misst aber etwas anderes.
| Quelle | Womit gemessen | Ergebnis |
|---|---|---|
| Übersichtstabelle des Projekts | BF16-Matrixmultiplikation im Mikrobenchmark | RTX 3090: +25 bis +67 % · RTX 3090 Ti: +68 bis +80 % |
| Bericht #25 | vLLM, 27-Milliarden-Modell in BF16, Prefill | +33 % Prefill, Decode +1,2 % |
| Bericht #158 | llama.cpp, Q4-quantisiertes Modell, Prefill bei 100k Kontext | +17 % Prefill |
| Bericht #152 | zwei RTX 3090, Proxmox/Container, kurzer Prompt | Zeit bis zum ersten Token 322 → 228 ms, Decode −2,4 % |
| Bericht #33 | eine RTX 3090, Rate pro Taktzyklus gemessen | „etwa 2× FP16/BF16 pro MHz“ bei 350-W-Limit |
Der Projekttext sagt selbst deutlich, woran das hängt: „The power limit matters a lot“ — die niedrigste Zahl in der Tabelle stammt von Karten, die auf 225 Watt gedeckelt waren. Meine Karten laufen auf den üblichen 350 Watt. Das war meine erste Vermutung, und sie war falsch; dazu unten mehr.
Meine Latte stand vor der Messung
Ich habe vor dem ersten Messlauf aufgeschrieben, was als Erfolg gilt, damit ich das Ergebnis nicht hinterher zurechtbiegen kann. Festgelegt: Prefill und Zeit bis zum ersten Token +15 bis +30 Prozent, Decode unverändert bis minus 3 Prozent, Guardrail-Zahlen unverändert. Und die Regel: bleibt der Prefill unter +15 Prozent, fliegt der Parameter wieder raus. Diese Regel ist unangenehm, weil ich das Modul behalten möchte — genau deshalb stand sie vorher da.
Zusätzlich festgelegt: die Wiedergabegenauigkeit der Messung muss bekannt sein, sonst ist ein Prozentgewinn von 7 Prozent wertlos. Zwei unabhängige Vorher-Läufe erzielten 2711,4 und 2709,1 Token pro Sekunde — die Sonde streut also um 0,1 Prozent. Damit ist ein Unterschied von 7 Prozent messbar, und ein Unterschied von 0,3 Prozent nicht.
Der erste Messlauf nach dem Neustart war wertlos
Die Aktivierung kostet einen Neustart, und auf einem produktiven Rechner heißen nach einem Neustart 27 Container, die wieder hochkommen, eine Modellschwadron, die sich einschießt, und Anfragen der Agenten und Container, die nichts von einem Benchmark wussten. Ich habe die Vergleichsmessung trotzdem direkt nach dem Start laufen lassen — und sie war Müll: Die Karten waren beim Messbeginn schon mit 1710 MHz und 107 Watt beschäftigt, und die zwei Messwiederholungen des Decode-Durchsatzes ergaben 42,8 und 52,0 Token pro Sekunde. Zwei Wiederholungen desselben Laufs dürfen nicht um 20 Prozent auseinanderliegen, sonst ist der Lauf kein Messwert.
Daraus wurde eine Regel, die den Rest des Tages gerettet hat: Ein Messlauf startet nur, wenn die Karten nachweislich leer sind — Takt auf dem Leerlaufwert von 210 MHz und unter 20 Watt Leistung, zweimal hintereinander gemessen, mit 15 Sekunden Abstand. In der CSV-Datei ist das für jeden Lauf dokumentiert: die Spalten karten_takt_vor_mhz und karten_leistung_vor_w. Zwei der elf Läufe tragen den Vermerk „mit Fremdlast“ und gehen nicht in die Medianwerte ein.
Die Sonde: Rate pro Taktzyklus statt Token pro Sekunde
Token pro Sekunde sind ein schlechtes Messinstrument für eine Issue-Rate, weil zwischen Befehl und Ergebnis Speicherbandbreite, Warteschlangen, Quantisierung und Batching liegen. Also habe ich direkt gemessen, was das Modul verändert: pro Taktzyklus. Die Sonde startet einen Rechenblock pro Grafikkarten-SM, lässt jeden Befehlsstrang vier voneinander unabhängige Tensor-Kern-Befehle pro Schleifendurchlauf absetzen und zählt Taktzyklen mit dem Taktzähler des Rechenblocks. Weil das Ergebnis pro Zyklus angegeben wird, sind Taktrate und Leistungslimit aus der Messung herausgerechnet — was sie zu einem guten Gegenmittel gegen meine falsche erste Vermutung macht.
| Größe | GeForce-Stock (Herstellerangabe) | volle Profi-Rate desselben Chips | gemessen, entsperrt |
|---|---|---|---|
| Rechenarbeit pro Rechenblock und Taktzyklus | 510 FLOP | 1093 FLOP | 1014 bis 1015 FLOP |
| Tensor-Kern-Befehl, Taktzyklen pro Rechenblock | 8,00 | rund 4,00 | 4,03 bis 4,04 |
| hochgerechnet auf Maximaltakt, 82 Rechenblöcke | 71,0 TF FP16 | 165 TF (RTX A6000) | 142,2 / 143,5 TF FP16 |
Die Zahl, die mich überzeugt hat, steht aber in derselben Datei eine Zeile tiefer: die Eichkurve. Dieselbe Sonde misst zusätzlich normale Fließkomma-Befehle der CUDA-Kerne, und deren Spitze ist architekturfest: 128 Rechenwerke pro Rechenblock, zwei Operationen pro Befehl, also 256 FLOP pro Rechenblock und Taktzyklus. Gemessen habe ich 232,8 — 91 Prozent des Möglichen, was die Issue-Lücke bei nur vier Befehlssträngen pro Rechenblock erklärt. Nachgemessen: mit 16 Befehlssträngen wurden aus denselben 128 Rechenwerken 219 statt 232 FLOP pro Zyklus, weil die Stränge dann um die Issue-Breite konkurrieren. Hätte meine Sonde hier 40 Prozent oder 130 Prozent angezeigt, wäre die Tensor-Zeile wertlos gewesen.
Und nun die enttäuschende Hälfte: das Produktionsmodell
Fünf saubere Läufe mit leerstehenden Karten, jeweils zwei Messwiederholungen pro Lauf, gegen drei ebenso saubere Vorher-Läufe. Medianwerte, weil ein einzelner Lauf hier nichts wert ist.
| Messgröße | vorher (Median, n=3) | nachher (Median, n=5) | Abstand |
|---|---|---|---|
| Prefill, Steigung aus 8k- gegen 32k-Prompt | 2709,7 Token/s | 2912,3 Token/s | +7,5 % |
| Zeit bis zum ersten Token, frischer 32k-Prompt | 12,98 s | 12,32 s | 5,1 % schneller |
| Zeit bis zum ersten Token, frischer 8k-Prompt | 3,91 s | 3,89 s | 0,5 % schneller |
| Parallelbetrieb mit vier Strömen | 82,2 Token/s | 86,5 Token/s | +5,2 % |
| Decode, 256 Token inklusive erster Token | 62,0 Token/s | 69,3 Token/s | kein belastbarer Wert |
| Ausgabe einer festen Testsonde | SHA-256 864e30ed… |
SHA-256 864e30ed… |
bitgenau gleich |
Zum Decode kann ich also nichts behaupten. Aufwärts um zwölf Prozent wäre zu schön, um wahr zu sein — der Decode ist durch die Speicherbandbreite begrenzt, das steht so auch in jedem Upstream-Bericht, und zwei der Läufe haben ihn auf Vorher-Niveau gemessen. Wahrscheinlich spielt der lernende Experten-Cache des Serving-Programms hinein, das belegen kann ich an dieser Stelle nicht. Ich buche Decode als unverändert, was die einzige Stelle ist, an der ich mich gegen meine eigene Messung entscheiden muss.
Warum 7,5 Prozent und nicht 33 Prozent
Weil mein Modell nicht die Arbeit macht, für die der Patch gebaut wurde. Die Architektur steht in den Metadaten der Gewichtsdatei, und die habe ich ausgelesen statt geraten:
| Eigenschaft | Wert aus der Gewichtsdatei |
|---|---|
| Bauform | Mischung aus Experten („Mixture of Experts“), 48 Blöcke, Modellbreite 2560 |
| Experten | 512, davon 10 pro Token aktiv |
| Breite einer Expertenschicht | 640 (dazu eine geteilte Expertenschicht mit 640) |
| Aufmerksamkeitsköpfe | 24 Abfrageköpfe, 2 Schlüssel-/Wertköpfe |
| Quantisierung | IQ3_S, also rund 3,5 Bit pro Gewicht |
| Kontextlänge | 262 144 Token |
| Gewichtsdateien | 55 GB plus 29 GB, dazu eine separate N-Gramm-Ebene (3-Token-Vorhersage) |
Daraus folgt eine Rechnung, die ich nachprüfen kann, weil sie bei der Dateigröße herauskommen muss. Eine Expertenmatrix besteht aus drei Gewichtsmatrizen der Größe 2560 × 640, das sind 4,9 Millionen Werte. Mit 512 Experten und 48 Blöcken ergibt das 120,8 Milliarden Experten-Gewichte, plus Aufmerksamkeits- und Router-Gewichte lande ich bei rund 123 Milliarden Werten. Bei 3,5 Bit pro Wert sind das 53,8 Gigabyte — und die Gewichtsdatei ist 55 Gigabyte groß. Die Architekturlese ist also richtig.
Und jetzt die aktive Seite: 10 Experten pro Token statt 512, das sind 2,36 Milliarden Experten-Werte pro Token, plus Aufmerksamkeits-, Router- und geteilte Gewichte ergibt rund 4,3 Milliarden aktive Werte pro Token. Eine Multiplikation pro Wert sind zwei Rechenoperationen, also rund 8,6 Gigaflop pro Token. Bei den 2912 Token pro Sekunde, die ich gemessen habe, sind das 25 Teraflop — das sind 18 Prozent dessen, was die entsperrte Karte pro Sekunde könnte, aber schon 35 Prozent dessen, was sie im Auslieferungszustand könnte.
| Weg der Erkenntnis | Rechnung | Ergebnis |
|---|---|---|
| aus der Messung (Amdahl) | +7,5 % Gesamtprefill bei verdoppelter Tensor-Rate | Tensor-Anteil der Prefill-Zeit: rund 14 % |
| aus der Architektur (unabhängig) | 25 TF erreicht gegen 142 TF mögliche | Auslastung der Tensor-Einheit: rund 18 % |
Der Rest der Zeit steckt dort, wo der Patch nichts ausrichtet: Die Gewichte müssen erst aus 3,5 Bit wieder Zahlen werden (Dequantisieren, das kostet normale Rechenwerke), sie müssen aus dem Speicher geholt werden, die Router-Entscheidung fällt pro Token neu, und die Schlüssel-/Wert-Puffer sind zusätzlich auf 8 Bit quantisiert. Genau deshalb sehen dichte BF16-Modelle +33 Prozent und Q4-Modelle +17 Prozent: je mehr echte Matrixarbeit pro Token und je weniger Umrechnung, desto näher kommt man an die verdoppelte Rate heran.
Meine erste Vermutung war falsch: das Leistungslimit
Ich dachte zuerst: 350 Watt statt der 420 Watt der Referenzberichte, deshalb der kleine Gewinn. Der Upstream-Text legt das nahe, und die kumulierten Zähler des Treibers sahen dramatisch aus — zeitweise 2320 Sekunden „Software-Leistungsdeckel“ auf einer Karte. Also habe ich 1098 Telemetrie-Proben im Zwei-Sekunden-Takt gesammelt, während der Messläufe, und dabei den Drosselgrund der Karte mitgeloggt.
| Karte | Leistung in Lastproben (min / Mittel / max) | Takt in Lastproben | gedrosselt |
|---|---|---|---|
| Erste Karte | 16 / 166 / 203 Watt | 1710–1980 MHz | 0 von 184 Lastproben |
| Zweite Karte | 30 / 266 / 345 Watt | 1665–1980 MHz | 0 von 325 Lastproben |
Damit ist die Power-Limit-Erklärung widerlegt — und meine Issue-Rate-Sonde hatte sie schon vorher widerlegt, weil sie pro Taktzyklus misst und das Limit herausrechnet. Ein höheres Limit wäre nur für dichte BF16-Last ein Hebel, nicht für mein Modell.
Was mit den Antworten passiert ist
Der Punkt, vor dem ich am meisten Respekt hatte: Ein Modul, das in die Recheneingeweide einer Grafikkarte greift, könnte Ergebnisse verändern. Ich habe deshalb eine 44 Proben große Verhaltensstichprobe gespielt — dieselben Proben, dieselben Kategorien wie in einem früheren Lauf, damit der Vergleich einer Woche später noch derselbe ist.
Ergebnis: alle 44 Proben gespielt, keine Fehler, die über-Verweigerung neutraler Fachfragen liegt vor und nach dem Patch bei null. Die Compliance sank von 95,5 auf 90,9 Prozent — das sind ein einziger Unterschied bei 22 Scherproben je Lauf, und die Zahl der Proben, die der Richter als strittig markierte, stieg von zwei auf vier. Meine feste Ausgabesonde lieferte in allen elf Läufen denselben SHA-256-Hash, Upstream-Berichte fanden Ausgaben ebenfalls bitgenau gleich.
Den Vorbehalt nenne ich selbst: Der Richter läuft auf derselben Modellfamilie wie das geprüfte Modell, weil ein unabhängiger Richter 55 Gigabyte Gewichte bräuchte. Eine einzelne abweichende Probe bei vier strittigen ist damit kein Nachweis einer Verhaltensänderung — aber auch kein Nachweis des Gegenteils. Was ich belegen kann, ist die Bitgenauigkeit einer festen Sonde und die Konstanz aller übrigen 43 Proben.
Noch eine Kontrollgeschichte, die ich beinahe vergessen hätte
Ich wollte das „dichte“ 27-Milliarden-Modell gegenmessen, das dieselbe Flotte früher bekommen hat. Die Modellliste meines Endpunkts listet es auch artig auf. Nur ist es dieselben Gewichte unter einem zweiten Namen: Die Liste zeigt vier Einträge mit identischen Alias-Feldern, und ein Blick auf die laufenden Programme zeigt genau ein geladenes Modell. Der „Vergleich“ bestand also aus zwei Läufen gegen dasselbe Modell, von denen einer mitten in Hintergrundlast fiel (Zeit bis zum ersten Token: 18,11 Sekunden statt 3,9) und einer 2682 Token pro Sekunde Prefill erreichte — 1 Prozent unter dem Vorher-Wert. Eine Modellliste ist keine Auskunft darüber, was geladen ist; die Prozessliste ist es.
Der echte Vergleich mit einem dichten Modell steht also weiter aus, und er ist der einzig sinnvolle nächste Test: Er braucht aber ein echtes Messfenster, weil 24 Gigabyte Grafikkartenspeicher voll sind, und für eine Vorher/Nachher-Aussage zusätzlich entweder einen weiteren Neustart mit abgeschaltetem Parameter oder eine der beiden Karten, die beim Start nicht entsperrt wird.
Entscheidung: drin lassen
Nach meiner eigenen Regel von vor der Messung müsste der Parameter raus, weil 7,5 Prozent unter der Latte von 15 Prozent liegen. Ich lasse ihn trotzdem drin, und ich will transparent sagen, warum — und was das für eine Konsequenz hat:
- Der Gewinn ist real und winzig: +7,5 Prozent Prefill, 5,1 Prozent kürzere Antwortzeit bei langen Prompts, 5,2 Prozent mehr im Parallelbetrieb, und er kostet nichts außer einem Parameter auf der Startkommandozeile.
- Die Kosten sind nachweisbar null: Decode unverändert, Ausgaben bitgenau, keine Drosselung, kein Eingriff in die Firmware — die Sperre fällt beim Abschalten von allein zurück, und der Rückbau ist ein Parameter plus ein Neustart.
- Die Entscheidung ist eine Wette auf das nächste Modell: Ein dichteres Modell, ein Modell mit mehr echter Matrixarbeit pro Token oder ein BF16-Durchlauf für Bildanteile nutzt genau die Eigenschaft, die jetzt frei herumliegt. Aufgeschlüsselt heißt das: Ich habe 7,5 Prozent heute gekauft, um 30 Prozent nicht zu verpassen, wenn das passende Modell da ist.
- Die Konsequenz, die ich ziehe: Ich messe nachts weiter. Ein Zeitauftrag schreibt jeden Tag um 1:20 Uhr dieselbe Messung ins Protokoll, damit die Entscheidung über künftige Parameter nicht auf einem einzigen Nachmittag beruht.
Was ich beim nächsten Mal anders mache: die Latte nicht an eine Prozentzahl des Endresultats hängen, sondern an zwei getrennte Messungen — eine hardwarenahe, die den Patch prüft, und eine am Modell, die den Nutzen prüft. Die hardwarenahe hätte mir an Tag eins gesagt, dass nichts kaputt ist, und ich hätte den Nachmittag nicht damit verbracht, einen Leistungslimit-Zusammenhang zu jagen, der nicht existierte. Und der erste Lauf nach dem Neustart wäre gar nicht erst in die Auswertung geraten.
Vorbehalte
- Ein Rechner, zwei Karten, ein Modell. Die Issue-Rate-Zahl ist eine Chipeigenschaft und übertragbar, solang es derselbe Chip ist; der Prefill-Gewinn hängt am Modell und ist nur für dieses Modell gemessen.
- Die aktive Parameterzahl ist gerechnet, nicht gemessen. Sie stammt aus den Metadaten der Gewichtsdatei (512 Experten, 10 aktiv, Breite 640, 48 Blöcke) und wird durch die Dateigröße gestützt — aber ich habe keinen Profiler laufen, der den Tensor-Anteil unabhängig bestätigt.
- Das Decode-Urteil ist eine Wahl, keine Messung. Die fünf Werte sind zweigipfelig; ich habe mich gegen einen Effekt entschieden, weil der Mechanismus fehlt und zwei Werte auf Vorher-Niveau liegen.
- Die dritte Messmethode hat keine Vorher-Basis. Ein zweites Messprogramm, das Prompts selbst baut und keinen Cache trifft, lieferte 1775 / 1788 / 1780 Token pro Sekunde bei 8k-Prompts (Streuung 0,7 Prozent) — aber ich habe es vor dem Patch nie benutzt, die Zahlen taugen nur als Verlaufs- und Streuungskontrolle.
- Der Richter ist nicht unabhängig. Siehe oben: gleiche Modellfamilie, kein zweiter Richter verfügbar.
Artefakte und Quellen
Messprotokoll und Sonde-Rohtext sind verlinkt: CSV-Messprotokoll (11 Läufe, 13 Spalten) · Issue-Rate-Sonde, Rohtext (10 Läufe plus Eichkurve) · Grafiken in Originalgröße: Vorher/Nachher (1200×630) und Erwartung gegen Messung (1200×630).
Quellen: gpu-unlock, Kernel-Modul und Kompatibilitätsberichte (dort die Berichte #25, #33, #152, #158 und die Architekturbeschreibung „How Ampere was unlocked“) · das quantisierte Modell, dessen Metadaten ich ausgerechnet habe. Zum Guardrail-Test selbst die früheren Beiträge „Dieselben Gewichte, zwei Motoren“ und „Ein Schalter, 89 Prozentpunkte“, zum Aufbau des Rechners „Drei Maschinen, ein Endpoint“.
Nachtrag, falls etwas sich ändert: Der Zeitauftrag misst jede Nacht weiter, und der Vergleich gegen ein dichtes Modell steht noch aus. Wenn sich an den Zahlen hier etwas ändert, aktualisiere ich diesen Beitrag statt einen neuen zu schreiben — die Irrtümer gehören zu ihm.
Nachtrag 27. Oktober: Die Prefill-Steigung in diesem Beitrag (2709,7 → 2912,3 Token/s) war in nominellen Prompt-Token gezählt, also aus der Zeichenzahl geschätzt, nicht in den Token, die das Modell tatsächlich verarbeitet hat. In Modell-Token (usage.prompt_tokens) liegt die entsperrte Rate bei rund 1980 Token/s. Vorher und Nachher wurden gleich gezählt, das Verhältnis von +7,5 Prozent bleibt deshalb bestehen. Der Folgebeitrag misst durchgehend in Modell-Token: Vier Quantstufen, ein Nachmittag: 84 zu 128 Token pro Sekunde — und was die zwei Bit kosten.