Mein Coding-Agent brach immer wieder mit Error: Context size has been exceeded ab. Seine Statuszeile zeigte 16,7 % von 262k, also rund 44.000 Token. Die automatische Verdichtung war eingeschaltet. Nach allem, was der Agent sehen konnte, war reichlich Platz.
Mit seiner eigenen Sitzung lag der Agent auch richtig. Nur meinte der Server mit „262k“ etwas anderes. Dieser Beitrag zeigt den Aufbau, wie ich die Ursache im Serverlog gefunden habe, die Lösung und die zwei Fehler, die mir beim Umsetzen passiert sind.
Der Aufbau
Ein Rechner mit NVIDIA GB10 und 128 GB gemeinsamem Speicher betreibt llama-server aus llama.cpp mit Qwen3.8-Flash-Next (IQ3_S). Das Modell kann von Haus aus 262.144 Token Kontext. Mehrere Clients nutzen es gleichzeitig: Coding-Agent-Sitzungen auf anderen Rechnern und ein Werkzeug, das Agenten orchestriert.
Gestartet war der Server mit diesen Kontext-Optionen:
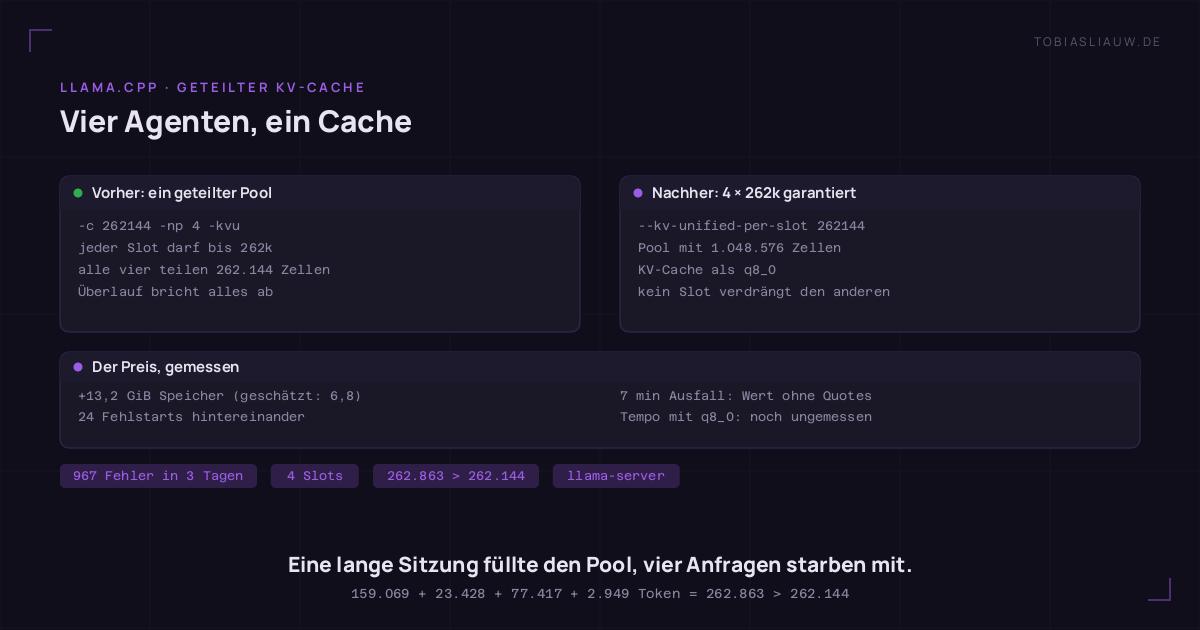
llama-server … -c 262144 -np 4 -kvu-np 4 ergibt vier parallele Slots, also vier gleichzeitige Anfragen. -kvu (einheitlicher KV-Cache) legt alle vier Slots in einen gemeinsamen KV-Puffer. Ohne -kvu teilt llama.cpp -c gleichmäßig auf: vier Slots zu je 65.536. Mit -kvu darf jeder Slot bis zu den vollen 262.144 nutzen, aber die Summe aller Slots muss in dieselben 262.144 Zellen passen.
Genau das steht in der Startzeile, wenn man sie als Satz liest:
load_model: initializing, n_slots = 4, n_ctx_slot = 262144, kv_unified = 'true'Vier Slots, jedem sind 262.144 versprochen, und dahinter ein einziger Pool von 262.144. Dieses Versprechen kann der Server nur halten, solange niemand es einlöst.
Was das Log zeigte
In drei Tagen stand der Fehler 967-mal im Serverlog. Ein einziger Abbruch mit den vier Freigabezeilen direkt danach erzählt die ganze Geschichte (gekürzt: ohne Zeitstempel und Task-Nummern):
decode: failed to find free space in the KV cache, retrying with smaller batch size, off = 1329, n_batch = 1024
decode: failed to find a memory slot for batch of size 719
… (halbiert bis n_batch = 1)
slot release: id 0 | stop processing: n_tokens = 159069
slot release: id 1 | stop processing: n_tokens = 23428
slot release: id 2 | stop processing: n_tokens = 77417
slot release: id 3 | stop processing: n_tokens = 2949
update_slots: decode() failed: Context size has been exceeded.| Slot | Token beim Abbruch | Anteil am Pool |
|---|---|---|
| 0 | 159.069 | 60,7 % |
| 1 | 23.428 | 8,9 % |
| 2 | 77.417 | 29,5 % |
| 3 | 2.949 | 1,1 % |
| Summe | 262.863 | 100,3 % |
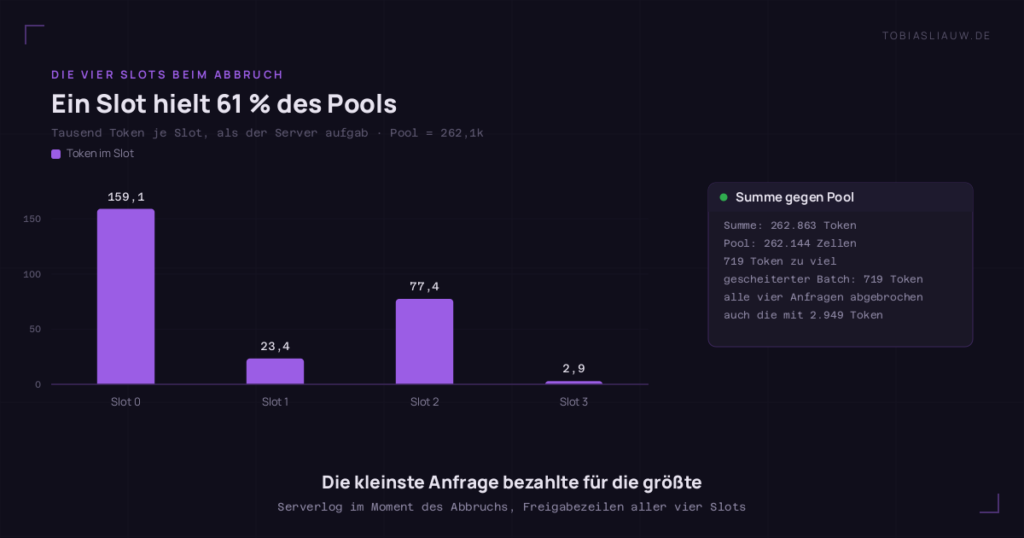
Die Summe ist 262.863. Der Pool fasst 262.144. Die Differenz beträgt 719 Token, genau die Größe des Batches, der keinen Platz mehr fand. Der Server versuchte es mit immer kleineren Batches, gab auf und beendete dann alle vier Anfragen. Die Anfrage in Slot 3 hatte keine 3.000 Token und starb trotzdem mit.
Warum die automatische Verdichtung nicht helfen konnte
Der Coding-Agent verdichtet seinen Verlauf, wenn seine eigene Sitzung an das Kontextfenster heranreicht, das man ihm genannt hat (262.144). Die anderen Clients sieht er nicht. Aus seiner Sicht sind 44.000 von 262.144 entspannte 16,7 %. Den Pool hat jemand anderes gefüllt, der Agent war Kollateralschaden.
Das ist die eigentliche Lehre: Bei einem geteilten KV-Pool ist das Kontextfenster, das ein Client genannt bekommt, keine Garantie. Es ist eine Obergrenze, die nur gilt, solange die anderen Slots klein bleiben.
Die Möglichkeiten
| Variante | Optionen | Fenster je Slot | Preis |
|---|---|---|---|
| A | --kv-unified-per-slot 131072 | 131.072, garantiert | Pool verdoppelt; Clients müssen auf 128k umgestellt werden |
| B | --kv-unified-per-slot 262144 -ctk q8_0 -ctv q8_0 | 262.144, garantiert | Pool ×4, in 8 Bit gespeichert |
| C | --kv-unified-per-slot 262144 (f16) | 262.144, garantiert | Pool ×4 in 16 Bit, etwa doppelter Speicher wie B |
ohne -kvu | -c 262144 -np 4 | je 65.536 | nichts; lange Sitzungen scheitern früh und sauber |
--kv-unified-per-slot N behält den gemeinsamen Puffer, deckelt aber jeden Slot bei N und bemisst den Pool, wenn man kein -c angibt, auf Slots × N. Damit kann die Summe den Pool nie mehr überschreiten. Eine einzelne Sitzung über N scheitert weiterhin, aber nur noch für sich allein.
Ich habe B gewählt: Jeder Client behält seine vollen 262k, und der 8-Bit-Cache braucht etwa halb so viel Speicher wie C. Bei gemeinsamem Speicher wiegt das schwerer, als es aussieht. Das Modell liest Teile seiner Gewichte bei Bedarf aus Dateien über den Seitencache, und jedes Gigabyte KV-Cache geht von genau diesem Speicher ab. Variante C hätte Modelldaten aus dem Cache gedrängt und die Generierung gebremst.
Die Lösung
llama-server … -c 1048576 -np 4 -kvu --kv-unified-per-slot 262144 -ctk q8_0 -ctv q8_0(Das Startskript übergibt immer ein -c, deshalb steht dort die Poolgröße, 4 × 262.144.) Die neue Startzeile:
llama_context: n_ctx_seq (1048576) > n_ctx_train (262144) -- possible training context overflow
load_model: initializing, n_slots = 4, n_ctx_slot = 262144, kv_unified = 'true'
Die Warnung bezieht sich auf die Größe des gemeinsamen Pools. Die Grenze je Slot bleibt bei den nativen 262.144 des Modells, und genau das macht sie harmlos. Nach dem Neustart kam auf eine echte Chat-Anfrage (nicht nur auf den Health-Endpunkt) eine Antwort zurück.
Zwei Fehler, gemessen
Die Speicherschätzung lag um den Faktor zwei daneben. Aus der Angabe der Modellkarte von etwa 24 KB KV-Cache je Token hatte ich für den größeren q8_0-Pool rund 6,8 GiB mehr geschätzt. Gemessen: Der Serverprozess wuchs von 62.232 auf 75.720 MiB, also um 13,2 GiB. Es passt trotzdem, aber hätte ich mich auf diese Schätzung hin für C entschieden, wäre es eng geworden. Vorher und nachher messen; einen Produktionsrechner nicht nach einer Angabe je Token bemessen.
Ein Wert ohne Anführungszeichen kostete sieben Minuten Ausfall. Das Startskript liest seine Einstellungen aus einer Umgebungsdatei, die bash per source einliest. Ich schrieb:
EXTRA_ARGS=--kv-unified-per-slot 262144 -ctk q8_0 -ctv q8_0Bash liest das als „setze EXTRA_ARGS für den folgenden Befehl“ und versucht dann, einen Befehl namens 262144 auszuführen. Der Dienst endete mit Status 127, systemd startete ihn 24-mal neu, und alle Clients hatten rund sieben Minuten kein Modell, bis ich ins Journal sah. Richtig ist die Zeile mit Anführungszeichen:
EXTRA_ARGS="--kv-unified-per-slot 262144 -ctk q8_0 -ctv q8_0"Fehlersuche, Schritt für Schritt
- Den Fehler zählen.
journalctl -u <deine llama-server-Unit> | grep -c "Context size has been exceeded". Eine Handvoll heißt: eine zu große Sitzung. Hunderte heißen: geteilter Pool. - Die Startzeile lesen. Nach
n_slotssuchen. Steht dortkv_unified = 'true'und istn_ctx_slotgleich deinem-c, teilen sich die Slots einen Pool. - Nach der Kaskade suchen.
failed to find free space in the KV cache, retrying with smaller batch size, halbiert bis 1, heißt: Der Pool ist voll, nicht ein einzelner langer Prompt. - Die Freigabezeilen addieren. Die Zeilen
slot release … n_tokensdirekt nach dem Fehler nennen die Größe jedes Slots. Liegt ihre Summe knapp über dem Pool, ist die Sache klar. - Nachsehen, wer verbunden ist. Ein schwerer Client (ein Orchestrator, der lange Verläufe wieder einspielt, ein Agent mit einem großen Repository im Kontext) reicht meist, um den Pool für alle zu füllen.
Was man tun sollte, was man lassen sollte
Tun
- Den Pool als Slots × dem Fenster, das man jedem Client verspricht bemessen, mit
--kv-unified-per-slot. - Den Clients das Fenster je Slot nennen, damit ihre Verdichtung gegen eine Grenze greift, die wirklich garantiert ist.
- Nach jeder Änderung die Startzeile lesen, nicht nur den Health-Endpunkt.
- Den Prozessspeicher vorher und nachher messen; Schätzungen je Token können um den Faktor zwei danebenliegen.
- In einer per
sourcegelesenen Umgebungsdatei jeden Wert mit Leerzeichen in Anführungszeichen setzen und vor dem Neustart prüfen:bash -n datei.env && (source ./datei.env; echo "[$EXTRA_ARGS]"). - Mit einer echten Anfrage prüfen und die alte Konfiguration für ein sofortiges Zurück aufheben.
Lassen
-cnicht als „je Slot“ lesen, wenn-kvuaktiv ist. Es ist die Gesamtgröße.- Sich nicht darauf verlassen, dass die Verdichtung im Client einen geteilten Pool schützt; der Client sieht die anderen Slots nicht.
-npnicht als kostenlose Parallelität behandeln. Der schlimmste Fall jedes Slots muss gleichzeitig passen.- Gemeinsamen Speicher nicht für einen 16-Bit-Cache ausgeben, wenn das Modell seine eigenen Gewichte über den Seitencache streamt; 8 Bit kosten die Hälfte und meist keine messbare Qualität.
- Einen geteilten Inferenzserver nicht ohne Probeanfrage und vorbereitetes Zurück neu starten.
Was noch offen ist
Zwei Dinge habe ich noch nicht gemessen. Erstens, ob die Fehlerzahl wirklich bei null bleibt: Die Lösung ist ein paar Stunden alt, erst einige Tage Log werden das zeigen. Zweitens, ob der q8_0-Cache die Generierungsgeschwindigkeit bei diesem Modell verändert. Beides trage ich hier nach, sobald ich die Zahlen habe.