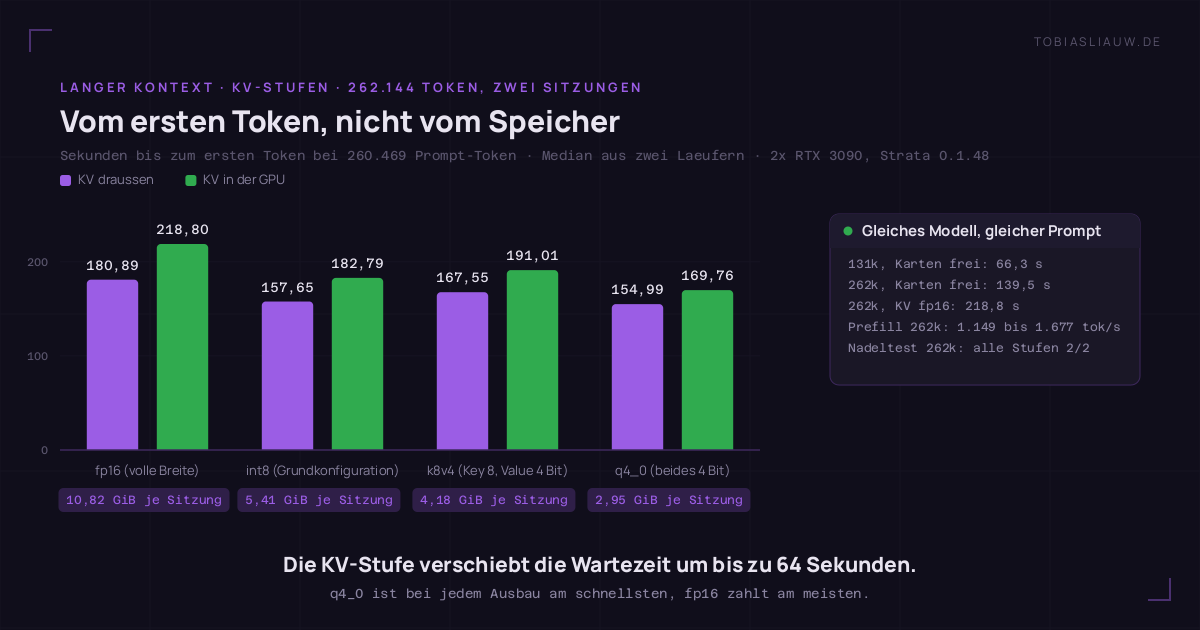
Zwei Nächte Messreihe auf zwei GeForce RTX 3090, 112 Messzellen, nach jeder Konfiguration ein Neustart der Produktions-Engine. Die Frage, die ich seit dem Herbst-Umbau vor mir herschiebe: Wo hört bei meinem 30-Milliarden-Experten-Mix nutzbbarer Langzeitkontext auf — und woran liegt es, wenn er umkippt? Die Antwort passt in einen Satz: Der Flaschenhals ist die Zeit bis zum ersten Token, nicht der Grafikspeicher — 262.144 Token kosten 139 bis 219 Sekunden Wartezeit, 131.072 Token 66 Sekunden, und die KV-Stufe verschiebt diese Wartzeit um bis zu 64 Sekunden, ohne einen einzigen Nadeltest zu verschlechtern (vier von vier Stufen finden die Sonde bei vollem Kontext). Der Rest ist der Beleg — und die Liste dessen, was ich nicht gemessen habe.
Der Beitrag setzt die Reihe über denselben Rechner fort: der Aufbau der Flotte, der Grafikkarten-Patch, der in allen Messungen hier aktiv war, und die Quantleiter desselben Modells. Der zweite Teil der Serie misst, was jenseits der 262.144 Token passiert — Rope-Stretching auf 512k und 1 Mio Token.
Vier Fragen, eine Maschine, kein Nebenprodukt
Erstens: Wie weit steigt die Zeit bis zum ersten Token mit der Promptlänge, und bricht sie irgendwo ein? Zweitens: Was kostet welche Quantisierung des Schlüsselspeicher-Caches (KV-Cache) an Wartezeit — und kostet sie Qualität? Drittens: Hilft es, mehr KV-Cache in den Grafikspeicher zu zwingen, und was passiert, wenn andere Modelle auf den Karten stehen? Viertens: Wie viele Sitzungen bei welcher Kontextlänge trage ich gleichzeitig, ohne dass die Wartzeit explodiert?
Der Rechner: zwei RTX 3090 mit je 24 GB, die zweite an PCIe 3.0 mit acht Lanes, ein Container mit 72 GB Arbeitsspeicher, ZFS-Freigabe für die Modelldateien, Treiber 595.84, Strata-Engine 0.1.48. Das Modell: qwen3.8-flash-next-abliterated in der IQ3_S-Fassung (3,5 Bit je Gewicht, 512 Experten je Block, zehn aktive pro Token), nativer Kontextrahmen 262.144 Token, ein Sitzungsplatz plus Warteschlange, Endpunkte auf 8080 und 11434. Die Grundkonfiguration der Flotte, die auch während der Messungen produktiv war, fährt den KV-Cache als q4_0 mit 32 GiB KV-Anteil im Grafikspeicher.
Gebaut habe ich die Matrix als Phasen: a0 die Kontextleiter von 8.192 bis 262.144 Token in der Mittelstufe int8, 27 Zellen zwischen 22:30 und 07:00 Uhr; a1 die KV-Achse — fp16, int8, k8v4, q4_0, jeweils mit 0, 20 und 32 GiB KV-Anteil, bei 65.536, 131.072 und 262.144 Token, 53 Zellen; a2 das Rope-Stretching auf 512k und 1 Mio Token (zweiter Beitragsteil); a4 dasselbe auf der GB10-Maschine; a5 das Grundraster erneut, nachdem zwei kleine Modelle von den Karten waren; und ein Qualitätsnachtrag, der die Nadelteste für jede KV-Stufe nachlieferte. Zwischen allen Gruppen lag ein Engine-Neustart, weil der KV-Cache und der Kontextrahmen beim Start festgelegt werden.
Messhygiene: was hier als Zahl zählt
Vor jeder Zelle ein Leerlauf-Tor: Endpunkt untätig, keine Fremdprozesse, drei Latenzproben mit Zufallswort. Nach dem Neustart wartete der Läufer auf die Bereitschaftsmeldung und prüfte, dass der Server den bestellten Kontextrahmen wirklich meldet; wurde eine Gruppe nicht herstellbar, übersprang der Lauf die Zelle und stellte die Ausgangskonfiguration wieder her. Ein Watchdog brach die Nacht ab, wenn eine Zelle ihr Zeitbudget überschritt, und beim ersten Fehler einer Gruppe ging es mit der nächsten Konfiguration weiter statt die ganze Nacht zu blockieren.
Die Kennzahlen kommen aus einem Messer, das ich für den Patch-Vergleich gebaut hatte, mit drei Korrekturen auf dem Weg. Erstens zählt jetzt der Server, nicht mein Skript: Die Promptgröße wird aus der Antwort des Servers gelesen (prompt_tokens), weil die eigene Zeichenzahl-Promptschätzung bei einem Modell mit 0,18 Wörtern je Token daneben lag. Zweitens ist Decode die Zahl der erzeugten Token geteilt durch die gesamte Streamingzeit, die Wartezeit auf das erste Token inklusive — eine bewusst zu niedrige Zahl, denn sie ist das, was am Schreibtisch ankommt. Drittens ist Prefill eine Differenzgrößen: zwei Prompts unterschiedlicher Länge, (lang − mittel) geteilt durch die Differenz der Wartezeiten; damit fällt der fixe request-Aufwand heraus. Erstes Token ist der Median aus zwei Läufen mit frischem, zufälligem Prompt und acht erzeugten Token.
Der Restdurchsatz schließlich ist kein Langkontextwert: Acht (bei der Matrix: zwei bis acht) kurze Anfragen mit 256 Token gehen gleichzeitig in dieselbe Warteschlange, gerechnet wird erzeugte Token gesamt durch Wandzeit. Er sagt, wie viel Kurzabfragen noch durchkommen, während der lange Kontext arbeitet. Jede Zelle brachte dazu eine Telemetrie-CSV mit: Auslastung, Leistung, Takt und Speicherbelegung beider Karten im Fünf-Sekunden-Takt, plus Drosselungsgründe.
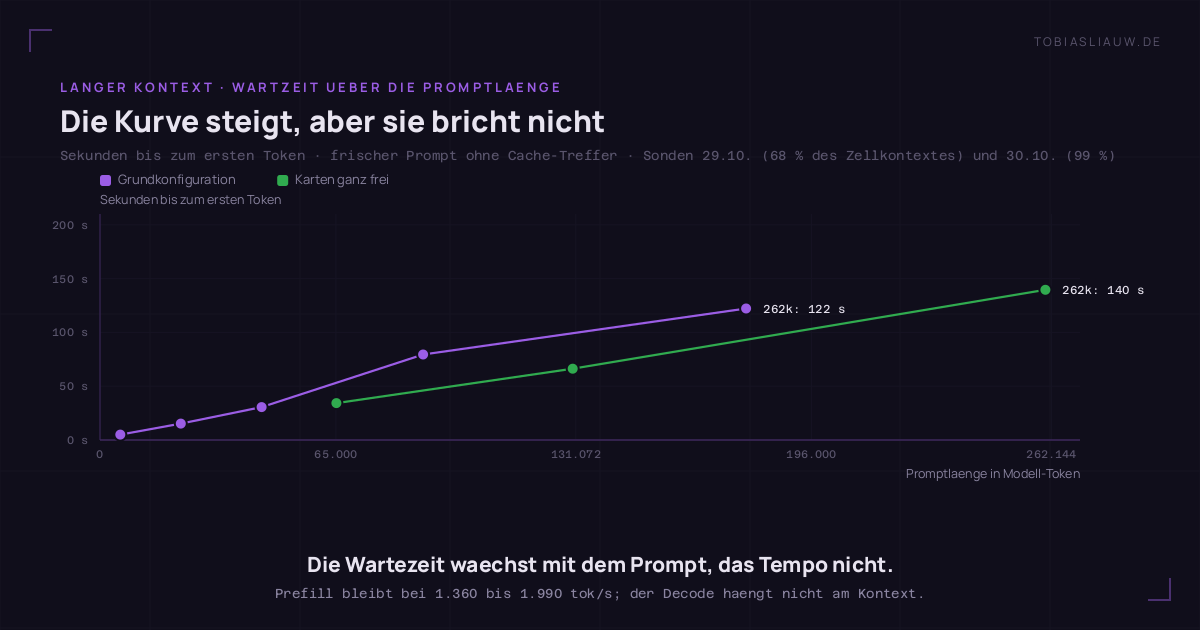
Befund 1: Die Wartzeit wächst mit dem Prompt, das Tempo nicht
| Ausbau | Kontext | Prompt (Server) | erstes Token | Prefill tok/s | Decode tok/s | Nadeltest |
|---|---|---|---|---|---|---|
| int8, 32 GiB | 8.192 | 5.583 | 5,04 s | – | 17,7 | – |
| int8, 32 GiB | 32.768 | 22.267 | 15,28 s | 1.626 | 43,9 | – |
| int8, 32 GiB | 65.536 | 44.516 | 30,56 s | 1.613 | 42,3 | 3/3 |
| int8, 32 GiB | 131.072 | 89.012 | 79,44 s | 1.358 | 43,1 | 3/3 |
| int8, 32 GiB | 262.144 | 178.001 | 122,19 s | 1.812 | 42,1 | 2/3 |
| int8, 64 GiB, Karten frei | 65.536 | 65.131 | 34,27 s | 1.909 | 57,3 | übertr. |
| int8, 64 GiB, Karten frei | 131.072 | 130.242 | 66,25 s | 1.990 | 61,1 | übertr. |
| int8, 64 GiB, Karten frei | 262.144 | 260.469 | 139,52 s | 1.857 | 59,8 | übertr. |
Zwischen 5.583 und 178.001 Prompt-Token steigt die Wartezeit von 5,0 auf 122,2 Sekunden — das ist die erwartbare Gerade, kein Knick. Der Prefill liegt über die ganze Leiter bei 1.360 bis 1.990 Token pro Sekunde, der Decode bei 42 bis 44 Token pro Sekunde und hängt damit sichtbar nicht an der Kontextlänge: Wer 200 Token Antwort braucht, wartet bei 262.144 Kontext nicht länger auf die Antwort als bei 8.192 — nur auf das erste Zeichen. Der Flaschenhals ist der Rand, nicht der Fluss.
Ein einziger Wert fällt aus der Reihe: 17,7 Token pro Sekunde Decode bei 8.192 Kontext. Das ist der erste Lauf des Nachts, als die Engine kalt war und die Expertenprofile noch lernten; die vier folgenden Zellen derselben Nacht liegen bei 43 bis 44. Ich lasse die Zeile stehen und markiere sie, statt sie zu streichen.
Befund 2: Die KV-Stufe verschiebt die Wartzeit um bis zu 64 Sekunden
| KV-Stufe | KV-Anteil | GiB je Sitzung (bei 262.144) |
erstes Token | Prefill tok/s | Decode tok/s | Restdurchsatz |
|---|---|---|---|---|---|---|
| fp16 (volle Breite) | 0 GiB | 10,82 | 180,9 s | 1.432 | 30,0 | 9,2 |
| fp16 | 20 GiB | 10,82 | 217,7 s | 1.149 | 41,5 | 47,5 |
| fp16 | 32 GiB | 10,82 | 218,8 s | 1.150 | 40,7 | 11,4 |
| int8 (Mittelstufe) | 0 GiB | 5,41 | 157,7 s | 1.660 | 36,0 | 49,5 |
| int8 | 20 GiB | 5,41 | 183,0 s | 1.381 | 41,9 | 19,8 |
| int8 | 32 GiB | 5,41 | 182,8 s | 1.384 | 42,0 | 2,9 |
| k8v4 (Key 8, Value 4 Bit) | 0 GiB | 4,18 | 167,6 s | 1.524 | 25,9 | 22,3 |
| k8v4 | 20 GiB | 4,18 | 191,0 s | 1.325 | 40,8 | 27,5 |
| k8v4 | 32 GiB | 4,18 | 191,0 s | 1.350 | 41,0 | 0,7 |
| q4_0 (beides 4 Bit) | 0 GiB | 2,95 | 155,0 s | 1.677 | 36,9 | 14,8 |
| q4_0 | 20 GiB | 2,95 | nicht gemessen | — | — | — |
| q4_0 | 32 GiB | 2,95 | 169,8 s | 1.540 | 24,0 | 10,5 |
Die Reihenfolge ist über alle drei Ausbaustufen dieselbe: q4_0 ist am schnellsten, fp16 am langsamsten. Bei KV-Anteil 0 trennen q4_0 (155,0 s) und fp16 (180,9 s) 26 Sekunden, bei 32 GiB Anteil 49 Sekunden (169,8 zu 218,8) — über alle Konfigurationen der größte Abstand, den eine KV-Entscheidung hier erzeugt. Der Prefill folgt derselben Ordnung: 1.677 gegen 1.150 Token pro Sekunde, ein Faktor von 1,46. Was die Wahl nicht kostet, steht im nächsten Abschnitt.
Erwartet hatte ich das Gegenteil beim KV-Anteil: mehr Cache im Grafikspeicher sollte schneller sein. Gemessen ist er bei int8 und k8v4 langsamer — 157,7 zu 182,8 Sekunden, 167,6 zu 191,0. Der plausible Grund steht in der Konfigurationsdatei: Der KV-Anteil wird neben Gewichten, Experten-Cache und Vision-Zweig in denselben Speicher gedrängt, und was dort fehlt, holt sich die Engine über den Peer-Reserve von der zweiten Karte. Weniger KV im VRAM heißt in dieser Maschine also mehr Platz für Experten — und Experten-Treffer zählen mehr als KV-Residenz. Bei q4_0 mit seinem kleinen Fußabdruck ist der Effekt kleiner (155,0 zu 169,8).
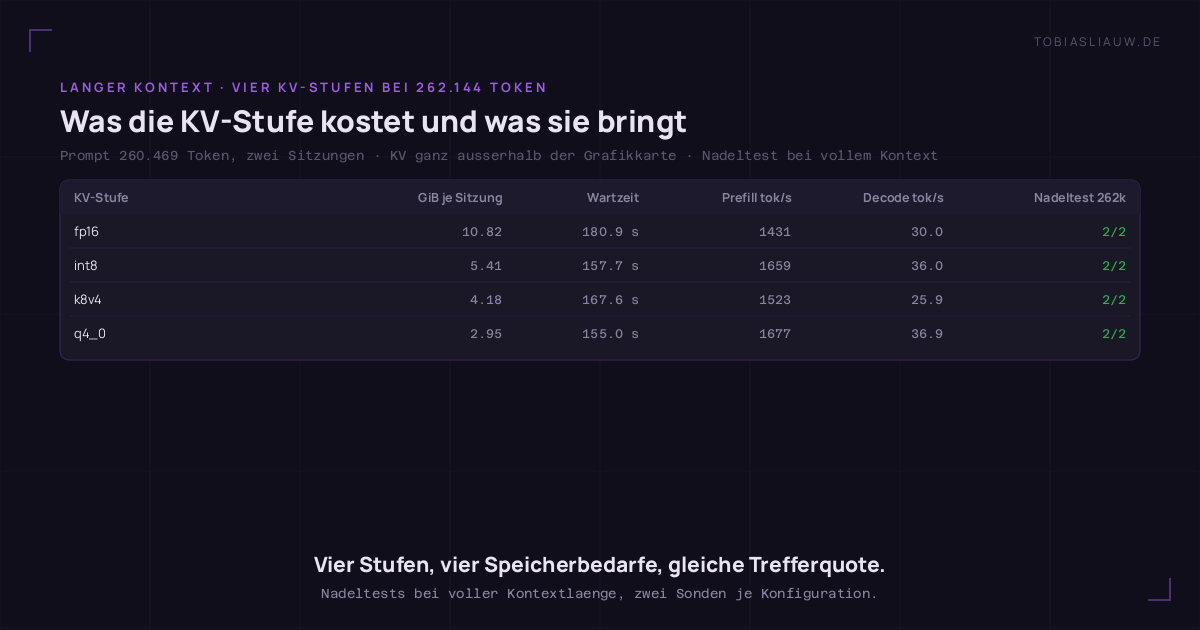
Befund 3: Vier KV-Stufen, vier Speicherbedarfe, dieselbe Trefferquote
| KV-Stufe | KV-Anteil | Nadeltest bei 262.144 | Prompt-Median | Antwortzeit |
|---|---|---|---|---|
| fp16 | 32 GiB | 2/2 | 261.802 | 240,1 s |
| int8 | 32 GiB | 2/2 | 261.701 | 153,1 s |
| k8v4 | 32 GiB | 2/2 | 222.545 | 261,4 s |
| q4_0 | 32 GiB | 2/2 | 261.827 | 233,0 s |
| q4_0 | 0 GiB | 2/2 | 241.868 | 139,3 s |
| int8 (Vorlauf, 3 Tiefen) | 32 GiB | 2/3 | 262.133 | 202,2 s |
| int8 (Vorlauf, 131.072) | 32 GiB | 3/3 | 130.939 | 93,7 s |
Keine der vier KV-Stufen verliert die Sonde. Zehn Sonden in fünf Konfigurationen, zehn Treffer — bei 4-Bit-KV genauso wie bei unkomprimiertem fp16, bei 2,95 GiB Speicherbedarf genauso wie bei 10,82. Die Tempervorteile des q4_0 sind in dieser Maschine also nicht bezahlt. Wer 262.144 Token fährt, sollte q4_0 nehmen; dass die Flotte das seit dem Herbst tut, steht damit auf zwei Beinen.
Die eine verfehlte Sonde der Nacht gehört zur Geschichte: Im Vorlauf lief es die 90-Prozent-Tiefe mit einem Prompt von 262.133 Token — 11 Token unter dem harten Limit — und die Antwort kam ohne die Marke. Dieselbe Konfiguration traf in halber und oberster Tiefe bei 260.906 und 261.957 Token. Ich deute das nicht als Quanteneffekt, sondern als Rand: Der letzte Kilotonnen-Ring des Fensters ist unzuverlässig, Plane Puffer. Beim nächsten Nachlauf mit zwei Tiefen fand dieselbe Konfiguration beide Sonden.
Befund 4: Speicherplatz wirkt erst, wenn der KV-Cache kniet
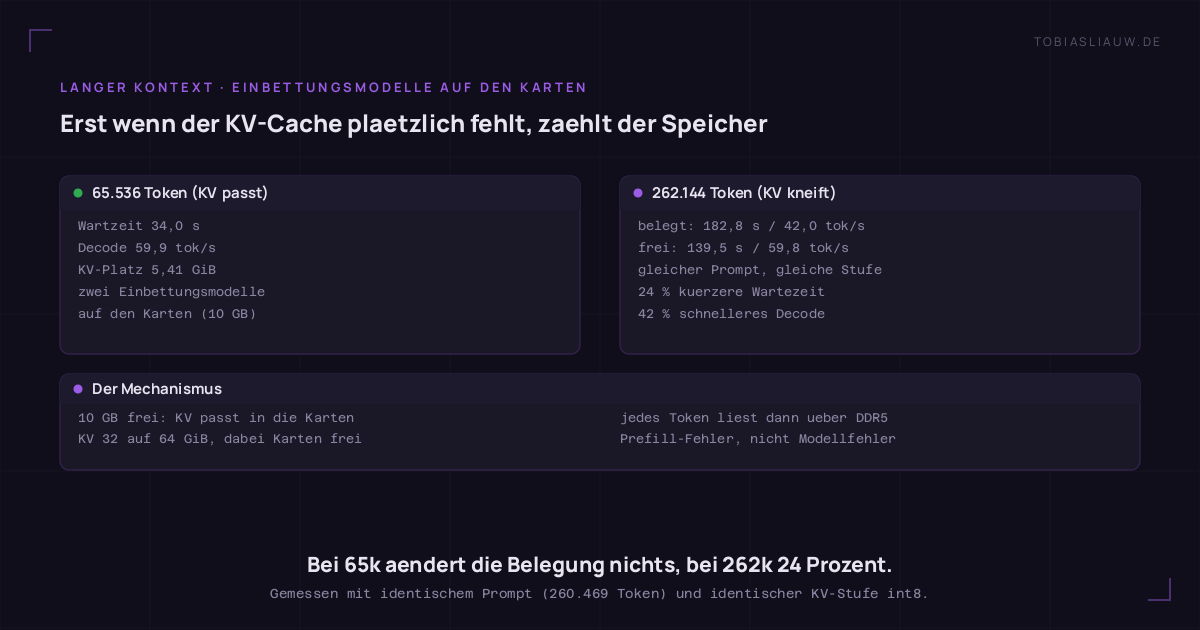
Vor der zweiten Nachmessung nahm ich zwei kleine Modelle von den Karten — ein Entscheidungsmodell für den Router und ein Einbettungsmodell, zusammen rund 10 GB. Bei 65.536 Token änderte das messbar nichts: 34,02 zu 34,27 Sekunden bis zum ersten Token, 59,9 zu 57,3 Token pro Sekunde Decode — dieselbe Zelle in zwei Welten. Bei 262.144 Token waren es 182,8 zu 139,5 Sekunden (24 Prozent kürzer) und 42,0 zu 59,8 Token pro Sekunde Decode (42 Prozent schneller).
Der Mechanismus passt zu Befund 1: Solange der KV-Cache einer Sitzung in den freien Grafikspeicher passt, ist er unsichtbar. Passt er nicht mehr, wandert er in den Arbeitsspeicher, und jedes Token des langen Prompts liest über DDR5 statt über die Karte. Zwei Einschränkungen muss ich nennen: Die Vergleichspaares unterscheidet sich nicht nur durch die Modelle auf den Karten, sondern auch durch den KV-Anteil (32 GiB gegen 64 GiB) und durch die Tageszeit (Vormittag gegen vier Uhr nachts, die Telemetrie misst in beiden Fällen 79 bis 94 Prozent Probens mit Kartennutzung durch die Messung selbst). Ein sauberes Paar mit identischem Ausbau steht noch aus; die Richtung deckt sich mit dem, was die Engine über ihren reservierten Speicher ausweist.
Befund 5: Der Sweetspot heißt 131.072 Token mal acht Sitzungen
| Kontext | Sitzungen | erstes Token | Decode tok/s | Restdurchsatz | Prefill tok/s | Kartenspitze |
|---|---|---|---|---|---|---|
| 65.536 | 2 | 34,27 s | 57,3 | 64,3 | 1.909 | 22.201 MB |
| 65.536 | 4 | 41,97 s | 57,8 | 33,4 | 1.640 | 22.201 MB |
| 65.536 | 8 | 34,44 s | 64,9 | 77,9 | 1.891 | 22.201 MB |
| 131.072 | 2 | 66,25 s | 61,1 | 80,2 | 1.990 | 22.187 MB |
| 131.072 | 4 | 67,11 s | 63,0 | 76,1 | 1.959 | 22.201 MB |
| 131.072 | 8 | 66,35 s | 61,8 | 78,0 | 1.980 | 22.201 MB |
| 262.144 | 2 | 139,52 s | 59,8 | 52,8 | 1.857 | 22.187 MB |
| 262.144 | 4 | 152,24 s | 61,1 | 77,6 | 1.656 | 22.187 MB |
Die Zeile 131.072 × 8 ist die Antwort auf vierte Frage: Voll ausgereizt trägt die Maschine 1,05 Millionen Token im Speicher und liefert 78,0 Token pro Sekunde Gesamtdurchsatz bei Kurzabfragen, während die langen Kontexte arbeiten. Die Wartzeit pro Anfrage bleibt dabei konstant — von zwei auf acht Sitzungen steigt sie bei 131.072 Token von 66,25 auf 66,35 Sekunden, weil die Engine die Vorläufe durch die Warteschlange staffelt statt sie zu parallelisieren. Wer also mehrere lange Dokumente gleichzeitig verarbeitet, zahlt mit Durchsatz pro Sitzung, nicht mit Wartezeit.
Doppelzimmer sind der Grund, warum ich die KV-Frage überhaupt stelle: Der Router stellt pro Sitzung garantierte KV-Zellen bereit. Bei 131.072 Token und 2,71 GiB int8-KV je Sitzung sind acht Sitzungen 21,6 GiB — tragbar, weil der KV-Cache komprimiert ist und ein Teil im Arbeitsspeicher liegt. Unkomprimiert (fp16, 5,41 GiB je Sitzung) wären es 43,3 GiB, und bei vollen 262.144 Token pro Sitzung 86,6 GiB. Ohne komprimierten KV-Cache wäre dieses Raster nicht acht Sitzungen groß, sondern zwei.
Was ich nicht gemessen habe
Vier Lücken, jede mit Grund. Erstens fehlt die Qualitätsachse jenseits der Nadelsuche: Ich habe gefunden, aber nicht gerechnet — keine Klassifikations- oder Zusammenfassungsaufgabe über den vollen Kontext, keine perplexität. Die Nadeltest-Quote ist eine untere Schranke für Retrieval, kein Qualitätsbeweis. Zweitens die Slot-Achse: Die Engine hätte gern pro Sitzung garantierte Zellen; wie sich garantierte Zellen und gewechselte Sitzungsplatz-Zahl (ein Slot plus Warteschlange gegen vier Slots) zueinander verhalten, ist für diese Maschine offen. Drittens fehlt die Quantleiter-Arm der dichten 27B-Modelle bei langem Kontext — die Datei passte nicht in den freien Speicher der Modelldisk, und aufräumen wollte ich mitten in der Messnacht nicht. Viertens die Wiederholung des KV-Ausbau-Paares (32 gegen 64 GiB) unter identischer Kartenbelegung, die Befund 4 sauber machen würde.
Dazu drei Grenzen, die ich nicht wegredne: Alle Zellen stammen von einem Modell und einer Engine-Version; Mediane beruhen auf zwei Läufen pro Zelle, weil ein Nachlauf von 260.000 Prompt-Token gut zwei Minuten kostet und die Nacht 27 bis 53 Zellen tragen musste; und ein Teil der Zellen lief bei laufendem Produktivbetrieb, weil die Produktionsinstanz nicht abgeschaltet war — die Leerlauf-Tore vor jeder Zelle fangen das, was sie fangen können, und die Telemetrie weist es pro Zelle aus.
Was ich daraus mache
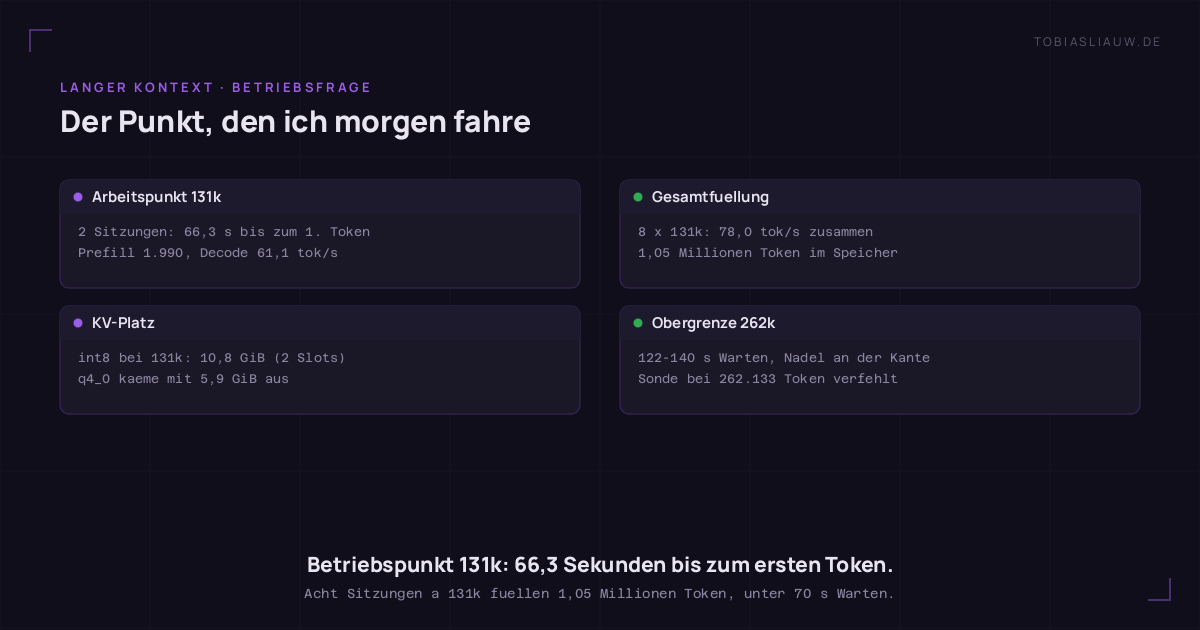
Vier Entscheidungen, alle ab sofort: Erstens bleibt der KV-Cache auf q4_0, die Messung hat den Verdacht in zwei Richtungen bestätigt (schnellste Stufe, keine Trefferquote verloren). Zweitens setze ich den interaktiven Arbeitspunkt auf 131.072 Token — 66 Sekunden Wartezeit sind an einem Schreibtisch noch erträglich, 139 bis 219 Sekunden sind es nicht; für Batch-Verarbeitung über mehrere Dokumente nehme ich acht Sitzungen und rechne mit 78 Token pro Sekunde Gesamtdurchsatz. Drittens plane ich das Kontextfenster nie ohne Puffer: Die eine verfehlte Sonde lag 11 Token unter dem Limit, also bestelle ich 245.000 statt 262.144. Viertens bleiben die kleinen Modelle von den Karten weg, die der große braucht — der Umzug hat die Wartzeit am Rand des Fensters um 24 Prozent gedrückt.
Der zweite Teil der Serie misst, was jenseits des Fensters liegt: denselben Rechner mit Rope-Stretching auf 512k und 1 Mio Token, die Nadeltest-Quote, die Antwortzeit eines vollen Durchlaufs — und was davon auf der GB10-Maschine anders läuft.
Artefakte
Die Messwerte als offene Dateien: alle Kennzahlen als JSON (Mediane je Zelle, Herkunftszeitstempel, Nadeltest-Einzelergebnisse) und die Zellen als CSV (Phase, KV-Stufe, Ausbau, Kontext, Sitzungen, Promptgröße, erstes Token, Prefill, Decode, Restdurchsatz, Kartenspitze, Nadelquote). Gebaut wird die Matrix mit einem Phasenläufer, der vor jeder Konfiguration die Engine-Datei umschreibt und danach zurückbaut; der Messer, die Nadelprüfung und der Auswerter liegen im selben Harness, das ich für den Patch-Vergleich gebaut habe.
Die fünf Grafiken in Originalgröße (1200 × 630): Vom ersten Token, nicht vom Speicher · Die Kurve steigt, aber sie bricht nicht · Was die KV-Stufe kostet und was sie bringt · Erst wenn der KV-Cache plaetzlich fehlt, zaehlt der Speicher · Der Punkt, den ich morgen fahre.