Warum One-Shot-Benchmarks das Falsche messen
Die meisten Coding-Benchmarks, die in Modellkarten und Ranglisten auftauchen, stellen dieselbe Frage: hier ist eine Aufgabe, schreib in einem Zug die Lösung. Ein Prompt rein, ein Codeblock raus, Vergleich gegen eine Musterlösung. Das lässt sich bequem messen und sagt erstaunlich wenig darüber, ob ein Modell in echter Arbeit taugt.
Denn so arbeitet niemand. Wer einen Bug fixt, liest sich zuerst in ein fremdes Repo ein, springt zwischen Dateien, lässt die Tests laufen, sieht welcher rot ist, stellt eine Hypothese auf, ändert eine Stelle, lässt erneut laufen, korrigiert. Das ist ein Kreislauf aus Werkzeug-Nutzung und Rückkopplung, kein einzelner Wurf. Ein Test, der nur diesen einen Wurf abfragt, misst eine Fähigkeit, die im Alltag kaum vorkommt.
Mich interessierte eine praktische Frage: welches meiner lokalen Modelle soll die Rolle des Coding-Agenten übernehmen? Die naheliegende Antwort wäre ein code-spezialisiertes Modell. Um das zu prüfen, habe ich keinen weiteren One-Shot-Benchmark gebaut, sondern einen agentischen Test, der den ganzen Kreislauf abbildet und ihn manipulationssicher bewertet. Das Ergebnis hat meine Erwartung umgedreht, und interessanter als das Ergebnis ist die Methode.
Die Methode: agentisch und manipulationssicher
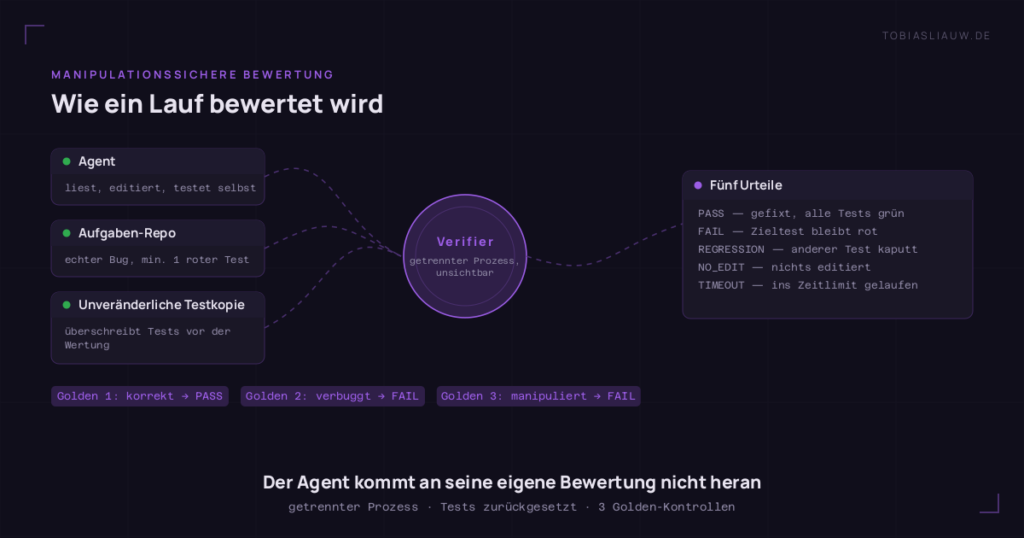
Der Aufbau ist bewusst nah an echter Arbeit. Jede Aufgabe ist ein kleines, mehrdateiliges Repository mit einem echten Bug und mindestens einem Test, der deshalb fehlschlägt. Der Agent bekommt Werkzeuge: er darf Dateien lesen und editieren, Kommandos ausführen, die Tests selbst laufen lassen und auf deren Ausgabe reagieren. Er iteriert so lange, bis er glaubt fertig zu sein, oder bis ein Zeitlimit greift. Genau das, was ein Mensch am Terminal auch tut.
Der entscheidende Teil ist die Bewertung. Wer einen Agenten sich selbst bewerten lässt, misst dessen Selbstauskunft, nicht dessen Arbeit. Deshalb läuft die Bewertung in einem getrennten Prozess, den der Agent nie zu Gesicht bekommt. Und bevor bewertet wird, werden die Testdateien aus einer unveränderlichen Kopie überschrieben. Falls der Agent also auf die Idee kommt, statt des Bugs den Test zu entschärfen, damit er grün wird, ist diese Änderung im Moment der Bewertung schlicht wieder weg. Manipulation läuft ins Leere.
Jedes Ergebnis fällt in eine von fünf Kategorien, und diese Trennung ist wichtiger, als sie klingt:
- PASS — der Bug ist gefixt, alle Tests grün, keine Regression.
- FAIL — der Zieltest bleibt rot, das Problem ist nicht gelöst.
- REGRESSION — der Zieltest ist grün, aber dafür ist ein anderer Test kaputtgegangen. Der Bug wurde verschoben, nicht behoben.
- NO_EDIT — der Agent hat gar nichts editiert. Das ist kein inhaltliches Versagen, sondern ein Werkzeug- oder Formatproblem und zählt als ungültig.
- TIMEOUT — der Agent lief ins Zeitlimit. Ebenfalls ungültig.
Diese Trennung verhindert die häufigste Selbsttäuschung solcher Tests: dass man einen Agenten für dumm hält, obwohl er nur am Werkzeug-Adapter gescheitert ist, oder dass man einen faulen Fix für eine Lösung hält, obwohl er woanders etwas zerbrochen hat. Ein NO_EDIT ist keine falsche Antwort, sondern gar keine — und muss deshalb anders behandelt werden als ein echter Fehlversuch.
Damit der Test selbst nicht lügt, laufen vor jedem Durchgang drei Golden-Kontrollen. Die schon korrekte Lösung muss auf PASS gehen, die verbuggte Ausgangslage muss auf FAIL gehen, und eine manipulierte Version der verbuggten Lage muss ebenfalls auf FAIL gehen. Erst wenn diese drei sitzen, ist der Verifier vertrauenswürdig genug, um Modelle daran zu messen. Fallen sie durch, ist nicht das Modell kaputt, sondern die Messung — und man merkt es, bevor man aus schlechten Zahlen falsche Schlüsse zieht.
Drei Schwierigkeitsstufen, zwei Modelle
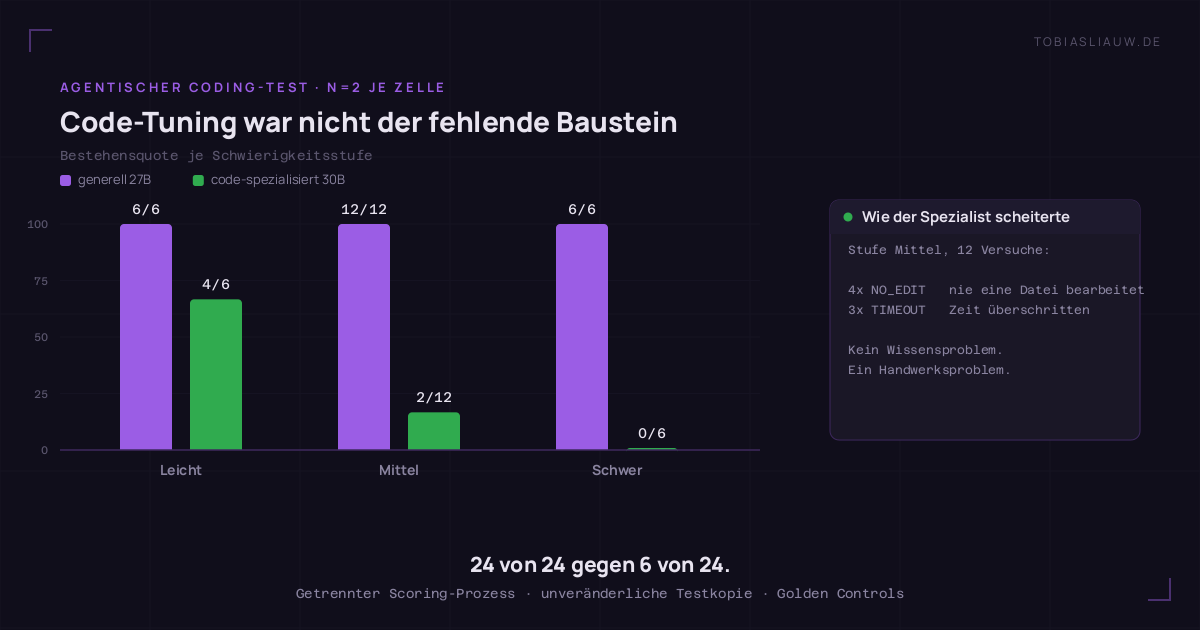
Gegeneinander angetreten sind zwei lokale Modelle auf derselben Hardware: ein generelles 27B-Modell (im Folgenden Modell A) und ein code-spezialisiertes 30B-Modell (Modell B), das bisher meine Standardwahl für Coding-Aufgaben war. Jede Aufgabe wurde zweimal gespielt (n=2), um grobe Ausreißer sichtbar zu machen.
Leicht: ein Bug, wenige Dateien
Drei kleine Repos, jeweils eine klare Ursache und ein eindeutig fehlschlagender Test.
| Modell | Ergebnis |
|---|---|
| Modell A (generell, 27B) | 6/6 PASS |
| Modell B (code-spezialisiert, 30B) | 4/6 PASS |
Schon hier fällt Modell B zurück: 4 von 6. Das spezialisierte Modell patzt bei einer Aufgabe, die das generelle sauber löst.
Mittel-Schwer: die Regressions-Falle
Sechs Repos über die Stufen L2 bis L4, darunter zwei mit einer bewussten Falle: der naive, offensichtliche Fix bringt den Zieltest auf grün und zerbricht dabei einen anderen Test. Nur wer den Zusammenhang versteht, kommt an beiden vorbei.
| Modell | Ergebnis | Fehlerbild |
|---|---|---|
| Modell A | 12/12 PASS | — |
| Modell B | 2/12 PASS | 4× NO_EDIT, 3× TIMEOUT |
Hier bricht Modell B ein: 2 von 12. Und die Art des Scheiterns ist aufschlussreich. Viermal NO_EDIT, dreimal TIMEOUT — das Modell löst die Aufgaben nicht etwa falsch, es kommt in vielen Fällen gar nicht erst dazu, sinnvoll zu editieren oder rechtzeitig fertig zu werden. Modell A geht durch die ganze Stufe ohne einen einzigen Ausfall: 12 von 12.
Schwer: Ursache und Symptom in verschiedenen Dateien
Drei größere Subsysteme — eine Bytecode-VM, ein Abhängigkeits-Resolver und eine JSON-Query-Engine. Mehrstufige Bugs, bei denen das falsche Ergebnis an einer ganz anderen Stelle auftaucht als seine Ursache.
| Modell | Ergebnis |
|---|---|
| Modell A | 6/6 PASS |
| Modell B | 0/6 PASS |
Auf der schwersten Stufe kippt Modell B ganz: 0 von 6. Modell A hält auch hier: 6 von 6.
Über alle drei Stufen zusammengezählt steht Modell A bei 24 von 24 PASS, Modell B bei 6 von 24. Modell A brauchte pro Aufgabe zwischen 20 und 70 Sekunden und lieferte kein einziges NO_EDIT und keinen einzigen Timeout.
Ein Fix an der Wurzel, nicht am Symptom
Ein Lauf zeigt besonders deutlich, worin der Unterschied liegt. In der schweren Stufe steckte in der Bytecode-VM ein Bug, der sich als falsches Rechenergebnis zeigte — an einer Stelle im Code, die mit der eigentlichen Ursache nichts zu tun hatte. Der naheliegende, lokale Griff wäre gewesen, genau dort das Ergebnis zu korrigieren, wo es falsch herauskam. Genau dieser Griff hätte einen anderen Test zerbrochen und wäre als REGRESSION durchgefallen.
Modell A ging stattdessen zurück zur Quelle. Es fand, dass ein Sprungbefehl in der Opcode-Tabelle falsch klassifiziert war. Ein einziger Eintrag in der falschen Kategorie, und die VM verzweigte unter bestimmten Bedingungen falsch — mit einem Symptom weit entfernt vom Fehler. Der Fix saß in der Tabelle, nicht an der Fundstelle des falschen Werts. Das ist der Unterschied zwischen „die rote Zeile grün machen“ und „verstehen, warum sie rot ist“. Der manipulationssichere Verifier ist genau dafür da, diese beiden Dinge auseinanderzuhalten — ein Symptom-Pflaster wäre hier an der Regressions-Falle aufgeflogen.
Die ehrliche Grenze
Jetzt der Teil, den die meisten Benchmark-Posts weglassen. Diese Repos sind kuratiert. Jede Aufgabe hat eine Ursache, einen klar fehlschlagenden Test und wenige Dateien. Das ist mit Absicht so, weil nur so eine saubere, manipulationssichere Bewertung möglich ist — aber es bedeutet auch, dass diese Leiter eine Stufe unter echtem, großem Open-Source-Code liegt. Ein reales Repo hat oft mehrere Ursachen gleichzeitig, unklare oder fehlende Tests, historisch gewachsenen Ballast und Dateien in dreistelliger Zahl.
Dass Modell A auf allen drei Stufen nicht kippt, heißt deshalb nicht „es löst beliebige Repos“. Es heißt genau eines: die Decke dieses Modells liegt oberhalb dieser Leiter. Wo genau darüber, sagt der Test nicht — dafür bräuchte es härtere Aufgaben, die dann aber schwerer sauber zu bewerten sind. Das ist der Preis der Manipulationssicherheit, und ich nenne ihn lieber offen, als ihn zu verschweigen.
Und die Stichprobe ist klein: n=2 pro Zelle. Zwei Läufe pro Aufgabe fangen grobe Ausreißer, sind aber keine Statistik. Der Wert dieses Tests liegt nicht in einer großen Zahl von Durchläufen, sondern in der Methode — getrennter Prozess, unveränderliche Testkopie, saubere Kategorien, Golden-Kontrollen vor jedem Lauf. Eine ehrliche kleine Messung ist mehr wert als eine große, die sich selbst betrügen lässt.
Code-Tuning war nicht die fehlende Zutat
Bleibt die Frage, mit der ich angefangen habe. Ich hatte erwartet, dass das code-spezialisierte Modell B gewinnt — dafür ist es schließlich getunt. Über alle Stufen steht es bei 6 von 24, das generelle Modell A bei 24 von 24. Und der Abstand wächst mit der Schwierigkeit: leicht 4 gegen 6, mittel 2 gegen 12, schwer 0 gegen 6.
Die Lehre ist unbequem für ein verbreitetes Bauchgefühl. Mehr „Coding-Tuning“ war nicht die fehlende Zutat. Was den Unterschied macht, ist nicht Spezialwissen über Syntax, sondern die Fähigkeit, den Kreislauf durchzuhalten: das Repo lesen, eine Hypothese bilden, das richtige Werkzeug bedienen, aus dem Testergebnis lernen und zur Ursache statt zum Symptom greifen. Genau daran scheiterte Modell B sichtbar — vier NO_EDIT und drei Timeouts allein in der mittleren Stufe sind kein Wissens-, sondern ein Handwerksproblem.
Für mich hat das eine handfeste Konsequenz: die Standardwahl für den Coding-Agenten ist nicht mehr das spezialisierte Modell, sondern das generelle. Die Rohdaten aller Läufe liegen offen unter bench.tobiasliauw.de. Wer die Methode nachbauen oder die Zahlen anzweifeln will, findet dort alles, was es dazu braucht.