36 Läufe, vier Modellfamilien, vier Aufgabenzuschnitte — und drei meiner eigenen Erklärungen, die dabei gestorben sind
Ich wollte eine Zahl. Können die Modelle, die ich auf eigener Hardware betreibe, echte Programmierarbeit leisten — keine Übungsaufgaben, sondern die Art Änderung, die man in einer bestehenden Codebase vornimmt, mit Tests, die schon grün sind und grün bleiben müssen?
Die Zahl war null. Was die zwei Tage lohnend gemacht hat, ist alles, was ich verwerfen musste, um ihr zu trauen.
Der Aufbau, und warum er so aussieht
Ein Coding-Agent ist ein Programm, das einem Modell Werkzeuge gibt — Datei lesen, Datei ändern, Kommando ausführen — und so lange schleift, bis das Modell sich für fertig erklärt. Ich habe zwei davon verwendet, mit lokal auf zwei Consumer-GPUs bereitgestellten Modellen.
Die Bewertungsregel ist hier wichtiger als alles andere: das Modell wird nie an seinem eigenen Bericht gemessen. Die Prüfung läuft in einem separaten Prozess gegen die Testsuite des Projekts, und das Modell sieht sie nie. Das ist keine Paranoia. Früh im Verlauf lieferte ein Agent nach fünf Sekunden einen Erfolgscode und den Satz „Both files have been created.“ Geschrieben hatte er nichts.
Eine zweite Regel erwies sich als ebenso tragend. Der Fix darf nichts kaputtmachen, was vorher funktioniert hat. Die Aufgabe lautet nicht „mach diesen Test grün“, sondern „mach diesen Test grün, während zweiundzwanzig andere grün bleiben“. Diese Nebenbedingung trennt echte Programmierarbeit vom Rätsel — und sie ist genau das, was eine Übungsaufgabe nicht haben kann.
Vier Stufen, jede nimmt eine Ausrede weg
Ich habe die Aufgabe viermal gebaut, damit ein Scheitern seine eigene Ursache benennt.
Stufe 1 sind Lehrbuchaufgaben in einem leeren Verzeichnis: eine Zahl in römische Ziffern wandeln, einen Zeitstring parsen, einen Zweizeilenfehler in einer Zehnzeilenfunktion beheben. Stufe 2 ist ein echter Defekt in einem Repository mit mehreren hundert Quelldateien, und außer dem Namen des fehlschlagenden Tests gibt es keinen Anhaltspunkt. Stufe 1.5 ist derselbe Defekt, aber die zu ändernde Datei und der Test stehen vollständig im Prompt — nichts muss gesucht werden. Stufe 1.6 entfernt den Agenten ganz: ein direkter Aufruf, das Modell muss die komplette korrigierte Datei zurückgeben, und ich schreibe sie selbst auf die Platte.
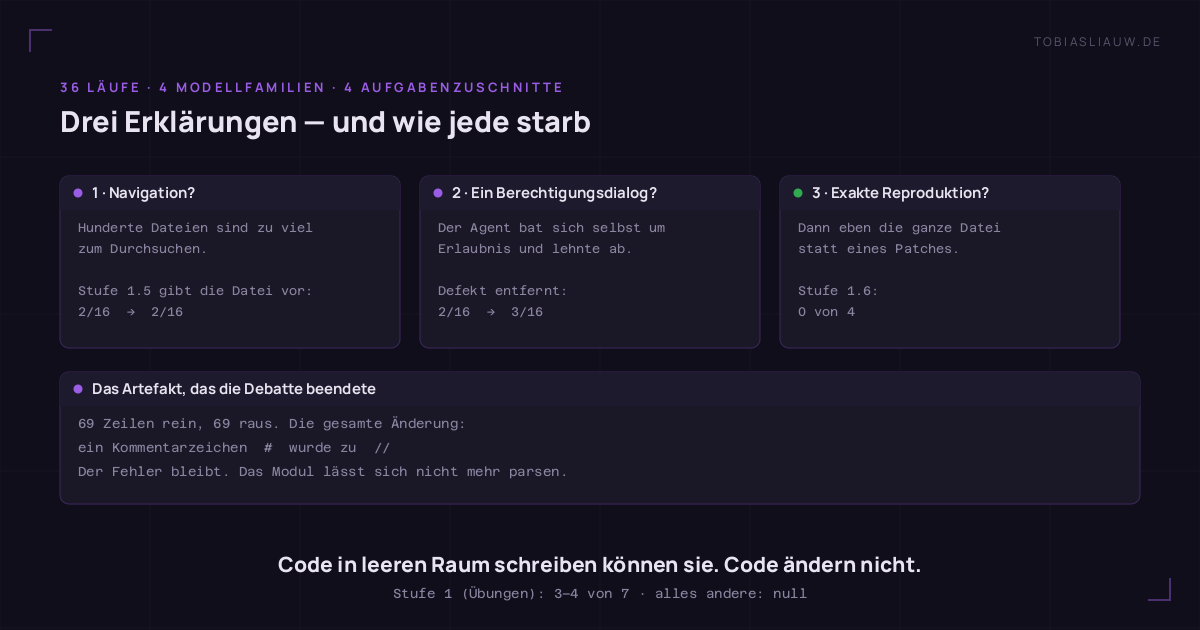
Stufe 1 erreicht drei bis vier von sieben. Alles andere: null.
Die drei Erklärungen, und wie jede starb
Meine erste Erklärung war Navigation: mehrere hundert Dateien sind zu viel, das Modell verliert sich, bevor es zur Arbeit kommt. Stufe 1.5 existiert, um genau das zu prüfen, und hat es glatt widerlegt. Die Datei zu übergeben veränderte die Rate, mit der die Modelle überhaupt etwas schrieben, von zwei von sechzehn auf zwei von sechzehn. Keine kleine Verbesserung — keine.
Die zweite Erklärung war besser, weil ich sie in den Logs fand statt in meinem Kopf. Einer der Agenten hat eine Schleifenerkennung: nach wiederholt fehlschlagenden Änderungen fragt er um Erlaubnis weiterzumachen, und in einem nicht-interaktiven Lauf gibt es niemanden, der sie erteilt — also lehnt er seine eigene Anfrage stillschweigend ab. Jede Messung mit diesem Agenten hatte einen Berechtigungsdialog gemessen. Ein echter Defekt, der weg musste. Er zu beheben hob die Schreibrate von zwei auf drei von sechzehn.
Die dritte Erklärung war die interessanteste und die, von der ich am ehesten erwartete, dass sie hält. Eine bestehende Datei zu ändern heißt, ein präzises Suchen-und-Ersetzen zu erzeugen: finde exakt diese Zeichenkette, setze jene an ihre Stelle. Kleine Modelle sind bekanntermaßen wackelig beim exakten Reproduzieren. Eine ganze neue Datei zu schreiben ist eine andere Operation — und Stufe 1 zeigt, dass sie das können. Also: lass sie die ganze Datei schreiben.
Stufe 1.6 gab jedem Modell die komplette Quelle, den kompletten Test und eine Anweisung — gib die gesamte korrigierte Datei in einem Codeblock zurück. Null von vier.
Das Artefakt, das die Diskussion beendete
Ein Modell lieferte eine saubere, vollständige Datei in der richtigen Länge. Neunundsechzig Zeilen rein, neunundsechzig Zeilen raus. Ich habe sie gegen das Original diffed. Hier ist die gesamte Änderung:
- eine Kommentarzeile, die mit
#begann, beginnt jetzt mit//
Das war alles. Den Fehler hat es nicht angefasst — der Fix kommt in der Datei nirgends vor. Was es getan hat: ein Python-Kommentarzeichen durch ein JavaScript-Kommentarzeichen ersetzen, was das Modul zu einem Syntaxfehler macht. Das Modell hat dreihundert Zeilen Kontext fehlerfrei reproduziert und den einen Denkschritt, aus dem die Aufgabe bestand, nicht ausgeführt.
Ein zweites Modell verhielt sich genauso mit einer anderen falschen Antwort. Ein drittes lieferte hundertfünfundzwanzig Byte Prosa, wo eine Datei verlangt war.
Das vierte Modell, und warum eine leere Antwort kein Ergebnis ist
Das vierte lieferte gar nichts, und ich hätte das beinahe als Fehlschlag verbucht. Ist es nicht — eine leere Antwort ist eine kaputte Messung, solange man nicht weiß, warum sie leer ist.
Nativ gemessen sah es so aus: 31.553 Token interner Reasoning-Spur, null Zeichen Antwort, und als Abschlussgrund „stop“ — das Modell hielt sich für fertig. Die Denkspur zu lesen ist lehrreich. Sie umkreist die richtige Funktion dreiundzwanzigmal und kommt nie zur Diagnose. Gegen Ende zerfällt der Text sichtbar: derselbe Bezeichner erscheint in vier verschiedenen Falschschreibungen, ganze Absätze wiederholen sich wörtlich, die letzten Zeilen sind Fragmente.
Ich hatte eine Theorie: die recht hoch gesetzte Wiederholungsstrafe bestraft die Wiederverwendung genau der Tokens, die das Modell braucht, und über dreißigtausend Token treibt sie es in Falschschreibungen. Prüfbar, also geprüft. Die Strafe neutral zu setzen machte es schlimmer — die Denkspur wuchs von hundertsiebenundzwanzigtausend auf zweihundertfünfzigtausend Zeichen, weiterhin ohne Antwort.
Das interne Reasoning abzuschalten erzeugte Ausgabe: zweihunderttausend Zeichen davon, mit fünfundfünfzig einzelnen Codeblöcken. Ich habe alle fünfundfünfzig kompiliert. Kein einziger ist eine gültige, vollständige Fassung der Datei.
Was ich falsch gemacht habe, und das ist der größere Teil der Methode
Ich behauptete zwischendurch, die Prompt-Verarbeitung laufe auf dieser Hardware mit etwa hundert Token pro Sekunde, was agentische Arbeit schon rein rechnerisch unmöglich machen würde. Falsch. Ich hatte Wanduhrzeit durch Tokenzahl geteilt, bei einem Aufruf, der das Laden eines neunzehn Gigabyte großen Modells von der Platte enthielt. Der tatsächliche Wert liegt über knapp viertausend Messungen bei rund tausend Token pro Sekunde für realistische Prompts — und der Fixkostenanteil eines Ein-Token-Prompts liest sich als achtundachtzig, eine Zahl, die wie eine Durchsatzmessung aussieht und keine ist.
Dann gab ich einem anderen Prozess die Schuld an der ausgelasteten Hardware und lieferte eine Kontrolle dafür: die Last beobachten, während nichts von mir läuft. Die Last lief weiter, also war sie nicht meine. Nur passte mein Suchmuster nicht auf den Prozess, den ich suchte — der läuft unter einem anderen Namen. Die Last war doch meine.
Ich meldete, eine Konfigurationsänderung habe eine bestimmte Warnung aus den Logs entfernt, nachdem ich ein Dreiminutenfenster geprüft hatte, in dem nichts passiert war, was diese Warnung erzeugen könnte. Null Vorkommen, keine Positivkontrolle, keine Aussage. Sie feuerte noch fünfundzwanzigmal.
Jedes Mal war es dieselbe billige Gewohnheit, die es auffliegen ließ: bevor du glaubst, dass etwas fehlt, weise nach, dass dein Test es sieht, wenn es da ist. Immer wenn ich diesen Schritt übersprang, produzierte ich eine selbstsichere, gut begründete, falsche Antwort — und jede davon war auf dem Weg in eine Entscheidung.
Was die Null wert ist
Das Ergebnis ist eng, und ich will es eng halten. Es sagt, dass Modelle dieser Größe, getrieben von diesen Agenten, die Schleife aus Lesen, Ändern, Testen, Wiederholen auf einer bestehenden Codebase nicht leisten. Es sagt nicht, dass sie nutzlos sind: dieselben Modelle bestehen die Hälfte der Übungsaufgaben, und auf einer strukturierten Extraktionsaufgabe, die ich regelmäßig fahre, erreicht eines davon perfekten Recall ohne die Fehlerart, die diese Aufgabe bestraft.
Die ehrliche Form des Befunds ist, dass diese beiden Dinge weit auseinander liegen. Code in leeren Raum zu erzeugen ist eine Fähigkeit, die diese Modelle haben. Bestehenden Code zu ändern, unter der Bedingung, dass alles andere weiterläuft, ist eine, die sie nicht haben — und weder Prompt-Engineering noch das Beheben eines Berechtigungsflags noch ein neu entworfenes Ausgabeformat hat diese Grenze um einen einzigen Test verschoben.
Verschoben hat sich mein Vertrauen in drei Erklärungen, die sich richtig anfühlten und es nicht waren. Das war am Ende die teurere Lektion.
Nachtrag: die vierte Erklärung, die ich damals nicht hatte
Drei Erklärungen sind in diesem Text gestorben. Inzwischen ist eine vierte dazugekommen, und sie ist unangenehmer als die drei davor, weil sie nicht das Modell betrifft, sondern mich.
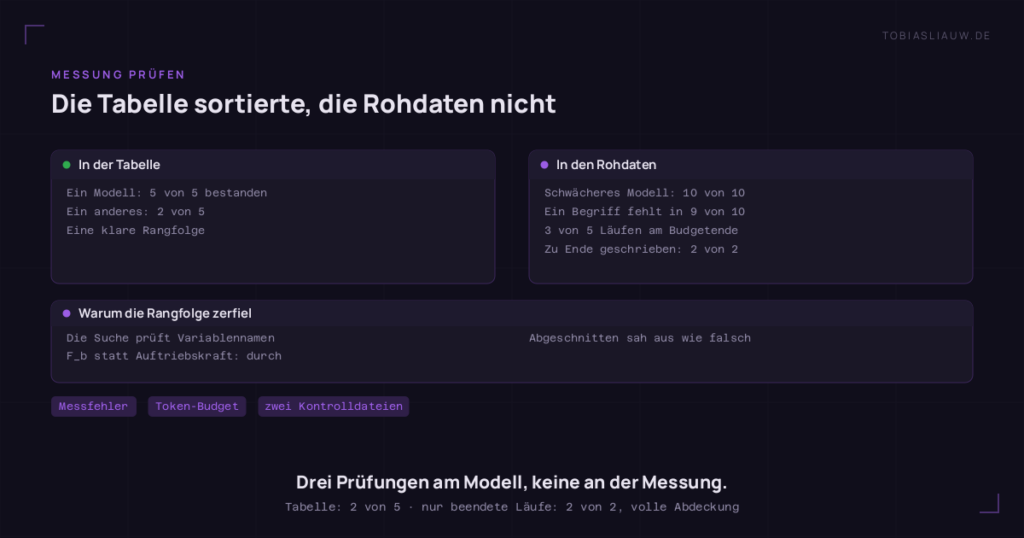
Ich habe seitdem einen anderen Prüfstand gebaut, der Modelle eine interaktive Simulation als einzelne Datei schreiben lässt. Auch dort gab es eine klare Rangfolge: ein Modell bestand fünf von fünf Durchläufen, ein anderes zwei von fünf. Als ich die Rohdaten nachgerechnet habe, statt der Tabelle zu glauben, war von der Rangfolge nichts übrig.
Das schwächere Modell hatte in zehn von zehn Durchläufen syntaktisch gültigen, laufenden Code geliefert. Jedes einzelne Mal. Der gesamte Unterschied hing an einer Suche nach Begriffen im Quelltext — und weil ich vorher Kommentare und Zeichenketten entferne, prüft diese Suche am Ende die Namen der Variablen. Wer die Auftriebskraft F_b nennt, wie es in der Physik üblich ist, fällt durch. Bei einem Modell fehlte genau ein Begriff in neun von zehn Läufen. Neun von zehn auf einem Wort sieht nicht nach fehlender Fähigkeit aus.
Dazu kam ein zweiter Effekt, der schlimmer ist. Jeder Lauf hatte ein Token-Budget, und aus diesem Budget wird nicht nur die Antwort bezahlt, sondern auch das Nachdenken davor. Ein Modell im Feld denkt besonders ausführlich — in einem Lauf fast einundzwanzigtausend Zeichen, bevor die erste Zeile Code entstand. In drei von fünf Läufen traf es exakt die Obergrenze, die Datei brach mitten im Satz ab, und meine Auswertung notierte pflichtschuldig: ungültige Syntax, null Merkmale, durchgefallen.
In der Tabelle stand danach zwei von fünf. Rechnet man nur die Läufe, die zu Ende schreiben durften, stehen dort zwei von zwei bestanden, beide mit voller Merkmalsabdeckung — die höchste im ganzen Feld. Wer am gründlichsten nachdenkt, verliert. Das ist die exakte Umkehrung dessen, was gemessen werden sollte, und in der Ausgabe sahen „durchgefallen“ und „abgeschnitten“ identisch aus.
Was heißt das für die Nullen in diesem Artikel? Ich habe die Läufe von damals daraufhin angesehen, und die Antwort ist: die Nullen halten. Dort wurde nicht abgeschnitten, und die Bewertung lief gegen ausgeführten Code, nicht gegen Variablennamen. Der Befund bleibt also stehen.
Was nicht stehen bleibt, ist die Selbstverständlichkeit, mit der ich ihn aufgeschrieben habe. Bei drei Erklärungen zu prüfen, ob das Modell versagt hat, und bei keiner, ob die Messung versagt hat, war eine Lücke — und dass sie mir erst an einem anderen Prüfstand aufgefallen ist, spricht nicht für die Sorgfalt beim ersten. Seitdem laufen vor jeder Messung zwei handgeschriebene Kontrolldateien mit: eine, die die volle Punktzahl bekommen muss, und eine, die durchfallen muss, weil sie alle gesuchten Begriffe nur im Kommentar trägt. Bekommt die zweite Punkte, liest die Bewertung Kommentare statt Code, und jede Zahl daneben ist wertlos.
Der Aufwand dafür war ein Nachmittag. Ohne ihn hätte ich in einem anderen Text drei falsche Behauptungen veröffentlicht, die genauso überzeugend ausgesehen hätten wie die Tabelle hier.