Infrastruktur

Mein AI Setup

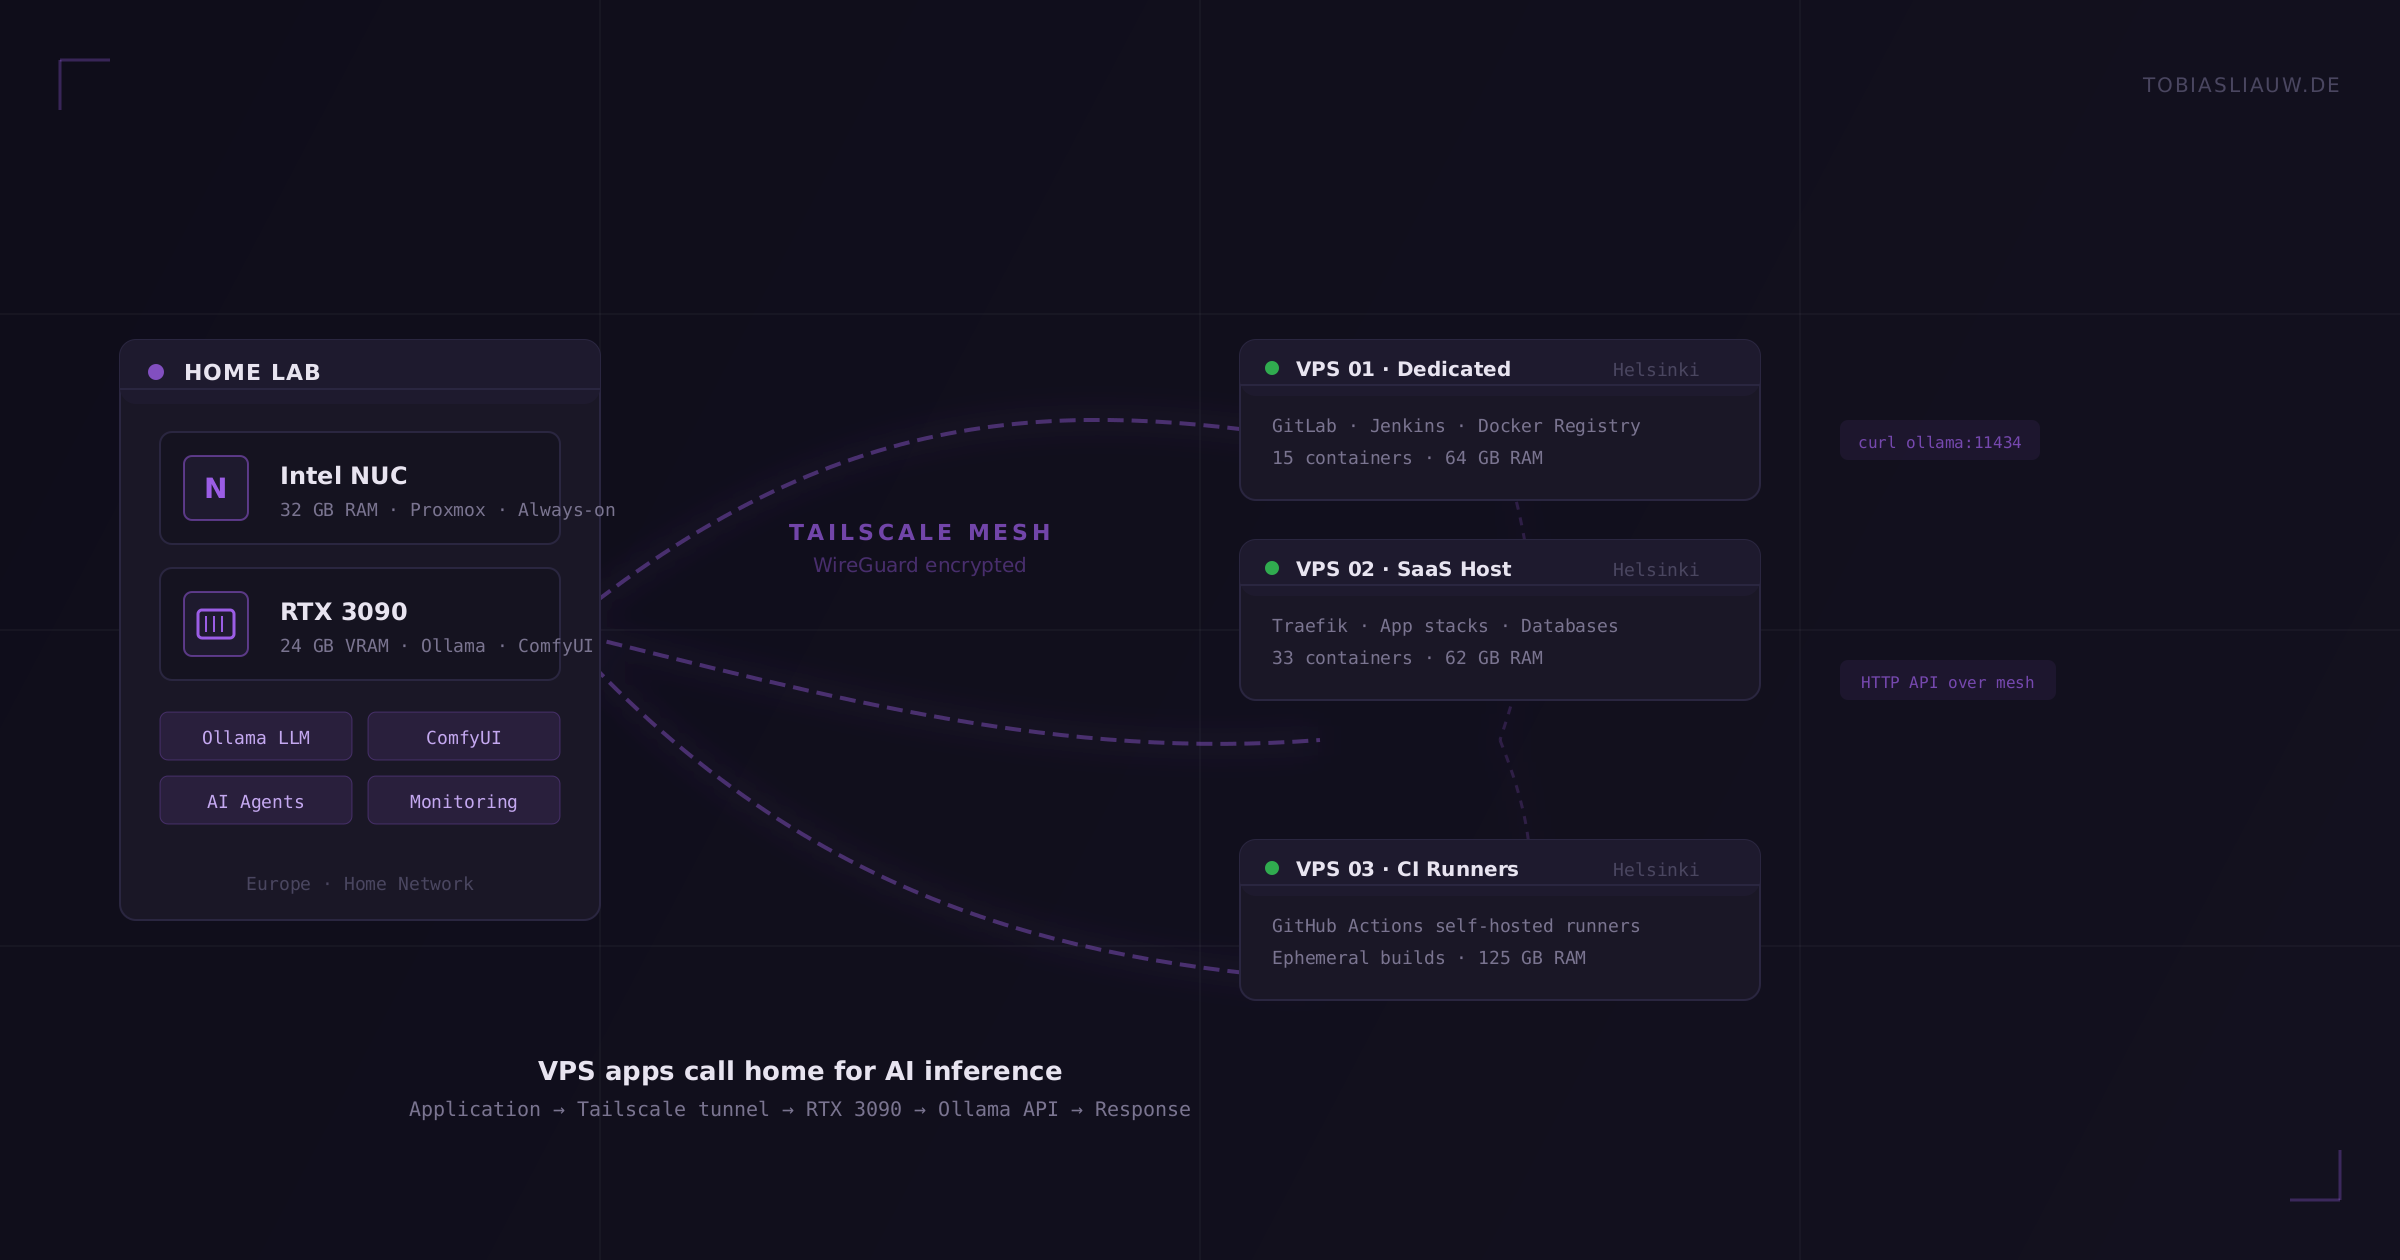
Architekturdiagramm auf sehr dunklem Grund. Links eine Karte HOME LAB mit zwei Geräten: einem Intel NUC mit 32 GB RAM unter Proxmox im Dauerbetrieb und einer RTX 3090 mit 24 GB Videospeicher für Ollama und ComfyUI, darunter vier Marken für Ollama LLM, ComfyUI, AI Agents und Monitoring sowie die Angabe Europa, Heimnetz. Rechts drei Karten mit grünem Statuspunkt: VPS 01 als dedizierter Server mit GitLab, Jenkins und Docker Registry, 15 Containern und 64 GB RAM; VPS 02 als SaaS-Host mit Traefik, App-Stacks und Datenbanken, 33 Containern und 62 GB RAM; VPS 03 mit selbst gehosteten GitHub-Actions-Runnern, kurzlebigen Builds und 125 GB RAM. Gestrichelte violette Kurven verbinden beide Seiten und tragen die Beschriftung Tailscale Mesh, WireGuard verschlüsselt, dazu zwei Marken für den Ollama-Aufruf und die HTTP-API über das Mesh. Unten die Aussage, dass die VPS-Anwendungen für KI-Inferenz nach Hause rufen, mit dem Weg von der Anwendung über den Tailscale-Tunnel zur RTX 3090 und zurück.
Die Anwendungen auf den Servern rufen für KI-Inferenz nach Hause — über das verschlüsselte Mesh an die GPU im Heimnetz.