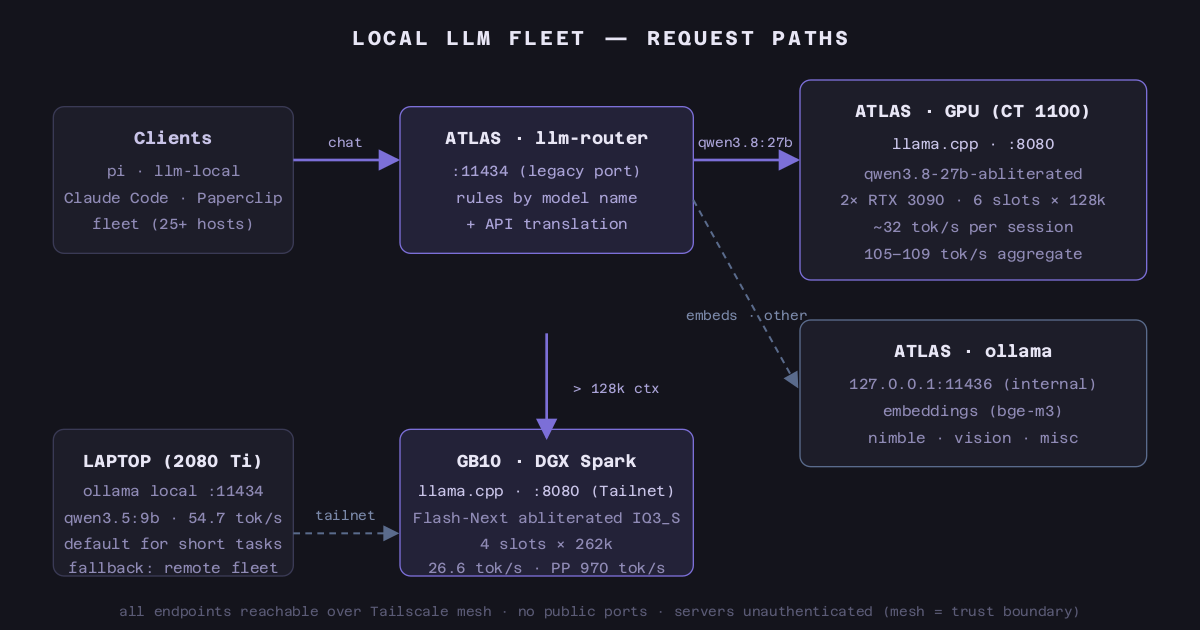
Vor zwei Jahren habe ich über einen NUC geschrieben, der 8B-Modelle auf dem CPU-Betrieb am Laufen hält, und nannte das die ganze Geschichte. Die Flotte ist seitdem gewachsen. Heute sind es drei Maschinen mit sehr unterschiedlichen Jobs: ein Dual-GPU-Server, der sechs parallele 128k-Sitzungen bedient, ein 121-GB-DGX-Spark, das alles über 128k Token beherrscht, und ein Laptop mit einer zehn Jahre alten GPU, die sich als schnellster Einzelstrom der gesamten Anlage herausstellt. So wurden die drei aufgebaut, und so hält ein 200 Zeilen Python-Router alle Clients am Laufen, während das Backend still von ollama auf llama.cpp umgestiegen ist.
Alle Zahlen in diesem Artikel sind gemessen, nicht geschätzt. Wo ich schätzen musste, sag ich’s.
Die Flotte auf einen Blick
Drei Maschinen, drei Jobs, ein Tailscale-Mesh. Keine öffentlichen Ports, keine API-Keys — das Mesh ist die Vertrauensgrenze, die Server sind bewusst unauthentisiert.
| Machine | Modell | Slots | Gemessen |
|---|---|---|---|
| Atlas — 2× RTX 3090, LXC auf Proxmox | Qwen 27B abliterated (Q4_K) | 6 × 128k Kontext | 105–109 tok/s gesamt bei 6 parallel |
| GB10 — DGX Spark, 121 GB unified | Qwen-27B-Klasse MoE, abliterated IQ3_S (84 GB) | 4 × 262k Kontext | 26,6 tok/s Generation, ~970 tok/s Prefill |
| Laptop — RTX 2080 Ti, 11 GB | 9B-Klasse (Q4_K_M) | Einzelstrom | 54,7 tok/s — der schnellste Einzelstrom der Flotte |
Atlas: der Arbeitstier, um Slots herum neu gebaut
Atlas ist der Haupt-Infrastruktur-Host — Proxmox, und darin ein LXC-Container, der das GPU-Paar trägt (zwei RTX 3090 per Passthrough). Lange Zeit lief die Inferenz über ollama, ein gutes Werkzeug, aber ollama serialisiert: eine Anfrage zur Zeit. Unter Flottenlast — und diese Flotte sind 25+ Hosts, die Agenten fahren — schoss die Zeit bis zum ersten Token bei 243 Sekunden. Das ist kein Modell-Problem, das ist ein Scheduling-Problem.
Die Lösung war ein llama.cpp-Build mit einem Flag, das die meisten Leute nie anfassen: -np 6 (sechs parallele Slots) plus -kvu --kv-unified-per-slot 131072 — ein einheitlicher KV-Cache, aufgeteilt in sechs gleich große 128k-Fenster. Das Modell (27B Q4_K, ~17 GB) liegt einmal im VRAM; jede Sitzung bekommt ihre eigenen 128k KV. Gemessen, im selben Harness, das dem alten ollama 48 tok/s serial brachte:
| Konkurrenz | pro Sitzung | gesamt | erstes Token |
|---|---|---|---|
| 1 | 42,6 tok/s | 42,6 | 0,32 s |
| 3 | 31,8 tok/s | 87–91 | 1,0 s |
| 6 | 19,2 tok/s | 105–109 | 2,5 s |
Drei parallele Sitzungen laufen in der Summe schneller als der beste Einzelstrom. Das ist das gesamte Argument für Slots.
Warum 6 × 128k und nicht 3 × 256k
Man könnte meinen, man wünscht sich weniger, größere Fenster. Die Rechnung sagt das Gegenteil, und sie kommt aus drei Messungen gegen meine eigene Prompt-Historie:
- Identische KV-Kosten. 6 × 128k und 3 × 256k reservieren beide 786.432 KV-Zellen — ~20 GB bei q4_0-Quantisierung (~27 KiB/Token bei diesem Modell). Größere Fenster kaufen im Speicher nichts.
- Die Last will es nicht. 3.408 echte Prompts aus einer Woche Flottenverkehr: nur 5,9 % lagen über 128k Token. Der Median-Prompt war 245 Token. Der 250k-Randfall braucht auf einer 3090 Minuten an Prefill, bis das erste Token erscheint.
- Luft für den Rest. 8 × 128k (27 GB KV) passen mit Modell, Embeddings und OS nicht auf 48 GB über zwei Karten. Und die langen Fälle haben einen besseren Ort — siehe GB10.
GB10: die Long-Context-Maschine
Der GB10 (DGX Spark) ist ein 121-GB-unified-Memory-Arm-Board — im Grunde eine Workstation, in der CPU und GPU einen großen Speicherpool teilen. Genau diese Eigenschaft ist, was Long-Context-Inferenz braucht, weil Kontextlänge ein Speicherproblem ist, kein Rechenproblem.
Das Modell darauf ist ein 27B-Klasse-Mixture-of-Experts (512 Experten, ~10 aktiv pro Token) in einer 84-GB-Quantisierung — es passt, weil die Experten durch den 121-GB-Pool streamen. Zwei Architektur-Details machen diese Maschine ungewöhnlich:
- Der KV-Cache ist winzig. Das Hybrid-Attention-Design hält die Full-Attention-Schichten auf einen kleinen Bruchteil des Stacks (12 von 48). Vier 262k-Slots mit einem einheitlichen KV-Pool kosten sehr wenig Speicher — der gesamte Server-Footprint, Modell inklusive, ist 61,8 GB.
- Er ist gebunden, nicht exponiert. Die API hört nur auf die Tailnet-Adresse und localhost, als systemd-User-Service mit Linger — kein sudo, keine öffentliche Oberfläche. Gemessen: ~970 tok/s Prefill, 26,6 tok/s Generation. Pro Token langsamer als die 3090er, aber es ist der einzige Ort, an dem ein 200k-Token-Prompt überhaupt leben kann.
Die Routing-Regel in einem Satz: alles über 128k Token geht auf den GB10, der Rest bleibt auf Atlas oder dem Laptop.
Der Laptop: unabsichtlicher Champion
Eine 10 Jahre alte RTX 2080 Ti mit 11 GB VRAM. Ich habe ein 9B-Klasse-Modell draufgesetzt (6,5 GB, Q4_K_M) und es drückt 54,7 tok/s — schneller pro Sitzung als jeder einzelne Strom auf der Dual-3090-Box, weil er einen Job zur Zeit macht, ohne jede Konkurrenz. Die Lektion, die sich in dieser Flotte wiederholt: ein kleines Modell mit einer ganzen GPU schlägt ein großes, das sich eine teilt.
Die praktische Teilung, die daraus wurde: kurze, interaktive, Einzelstrom-Arbeit (Pair Programming, schnelle Reviews) läuft lokal bei 55 tok/s. Alles, was die Qualität der 27B braucht, oder irgendeine Parallelität, geht an die Flotte. Der Laptop ist kein Fallback — er ist das richtige Werkzeug für seine Nische.
Der Router: alten Port behalten, Gehirn tauschen
Hier ist der Teil, den die meisten Setups falsch machen. Man hat jetzt drei Backends (llama.cpp, ollama, der GB10), und 25+ Clients über das Mesh — Agenten, CLI-Tools, eine Paperclip-artige Agent-Plattform — alle hartverdrahtet auf eine URL: atlas:11434. Jeden Client umzukonfigurieren ist ein Projekt; den Port zu halten und nach Inhalt zu routen, ist ein Nachmittag.
Deshalb läuft auf Atlas ein kleiner Router — nur Python-Standard-Bibliothek, ~200 Zeilen, eine systemd-Unit — auf dem alten Port 11434. Die Regeln:
- Modell
qwen3.8:27b(oder:latest) → GPU-llama.cpp auf 127.0.0.1:8080, das die OpenAI-API spricht. Alles andere (Embeddings, die kleinen Dienstmodelle) → echtes ollama, jetzt intern auf 127.0.0.1:11436 gebunden./api/tagsund dergleichen gehen direkt durch. - API-Translation wo nötig. Alte Clients sprechen ollama-nativ (
/api/generate,/api/chat); das neue Backend spricht OpenAI (/v1/chat/completions). Der Router übersetzt beide Richtungen, Streaming inklusive — Think/Format/Tool-Call-Payloads und alles. Neue Clients können die OpenAI-Routen direkt auf demselben Port treffen. - Ein Quirk, der sich zu kennen lohnt: Claude Code zerlegt seinen System-Prompt über mehrere Blöcke und kann mitten im Verlauf eine
role:"system"-Nachricht absetzen. Qwens Chat-Template lehnt das mit harten 500 ab („System message must be at the beginning“). Der Router faltet beides auf dem Anthropic-Route vor dem Weiterleiten in einen einzelnen System-Block. Ein Bug-Klasse, an einem Ort behoben, für jeden Client.
Nach dem Wechsel: 43 Modelle weiterhin im Tags-Endpoint sichtbar, Embeddings unverändert (1024 dims), Chat über LAN und Tailnet ok, null Fehler bei 80+ Requests. Die Clients haben’s nie bemerkt. Das ist der Test, der für diese Art von Änderung zählt — der alte Port hält seinen Vertrag, das neue Backend bekommt den Verkehr.
Ein Betriebsspiel, das uns gebissen hat und sich zu stehlen lohnt: Wenn llama.cpp neu startet, gibt er VRAM frei — und ollama, der immer hungrig ist, besetzt es in der Neustart-Lücke, sodass llama.cpp mit OOM zurückkommt. Die systemd-Unit hat jetzt ein ExecStartPre, das die anderen Modelle entlädt, bevor der Server Speicher reserviert, und das qwen-Modell in ollama ist auf CPU gepinnt als letzte Reserve. Eine vier Minuten lange Ausfallzeit hat mir das beigebracht.
Was ich anders machen würde
- Erst die Prompt-Verteilung messen. Das 6 × 128k-Design hat nur dann Sinn ergeben, als ich eine Woche echter Prompts gezogen und den 5,9 %/245-Token-Median gesehen hatte. Raten bei der Kontext-Größe ist, wie man auf verschwendetes VRAM oder 200-Sekunden-Erste-Tokens landet.
- Slots von Tag eins, nicht nach der 243-Sekunden-TTFT. Die Migration von ollama auf llama.cpp sah sich wie ein großer Umzug an. Es war eigentlich ein Scheduling-Fix mit einem Modell davor.
- Dem langen Schwanz einen eigenen Ort geben, bevor es ein Problem wird. Der GB10 war ein „was ist dieses Board“-Kauf; der winzige KV-Cache des Hybrid-Attention-Modells hat ihn zum Long-Context-Tier der Flotte gemacht. Die Hardware war der einfache Teil.
- Den Router dumm halten. Standard-Bibliothek, eine Datei, zwei Upstreams, Regeln nach Modellname. Im Moment, wo er eine Datenbank braucht, hast du einen Service gebaut, keinen Router.
Das wiederkehrende Thema: drei Maschinen, die auf den ersten Blick nichts miteinander zu tun haben, lösen eigentlich je ein Problem — Parallelität (Atlas), Speicher (GB10) und Konkurrenz-freie Einzelströme (Laptop) — und ein dünner Router, der der Flotte erlaubt, all das als einen einzigen Endpoint zu behandeln. Keine Cloud, keine Token-Abrechnung, keine öffentlichen Ports. Und das Ganze läuft auf Hardware, die einmal gekostet hat.