Abliteration entfernt einem Sprachmodell die Fähigkeit, Anfragen abzulehnen. Kein Nachtraining, kein neuer Datensatz — man findet die eine Richtung im Aktivierungsraum, entlang derer das Modell seine Verweigerung ausdrückt, und rechnet sie heraus. Das klingt nach einem Eingriff, der Spuren hinterlassen muss. Die naheliegende Frage ist: welche?
Ich hatte den Vergleich, um das zu messen. gemma4:26b steht in der Prompt-Messung dieser Serie ganz oben. Und es gibt eine abliterierte Fassung desselben Modells, gleiche Größe, gleiche Quantisierung. Also dieselben vier Aufgaben, dieselben vier Prompt-Varianten, dieselben drei Seeds, dieselben Parameter — 48 Zellen gegen 48 Zellen.
Korrigiert am 02.08.2026: „Drei Seeds“ beschreibt hier nur die Zahl der Durchgänge. Nachgemessen ist der Seed bei mehreren Modellen wirkungslos — ornith:35b und qwen3.6:27b liefern über alle drei Seeds byteidentische Ausgaben, andere streuen selbst bei identischem Seed. Die Zahlen bleiben gültig; die Einzelheiten stehen unter Wie ich messe.
Nachtrag vom 03.08.2026: „bei identischem Seed“ ist zu unscharf. Nachgemessen weicht genau ein Lauf je Gruppe ab, und zwar immer der erste — in 111 von 111 Fällen. Alle weiteren Läufe sind untereinander byteidentisch, auch über beide Rechner hinweg (108 von 108 Zellenpaaren). Fünf verschiedene Seeds liefern denselben Text wie fünf Wiederholungen desselben Seeds: der Seed wirkt nicht, die Position wirkt. An den Messwerten ändert sich nichts.
Das erste Ergebnis war eindeutig. Und falsch.
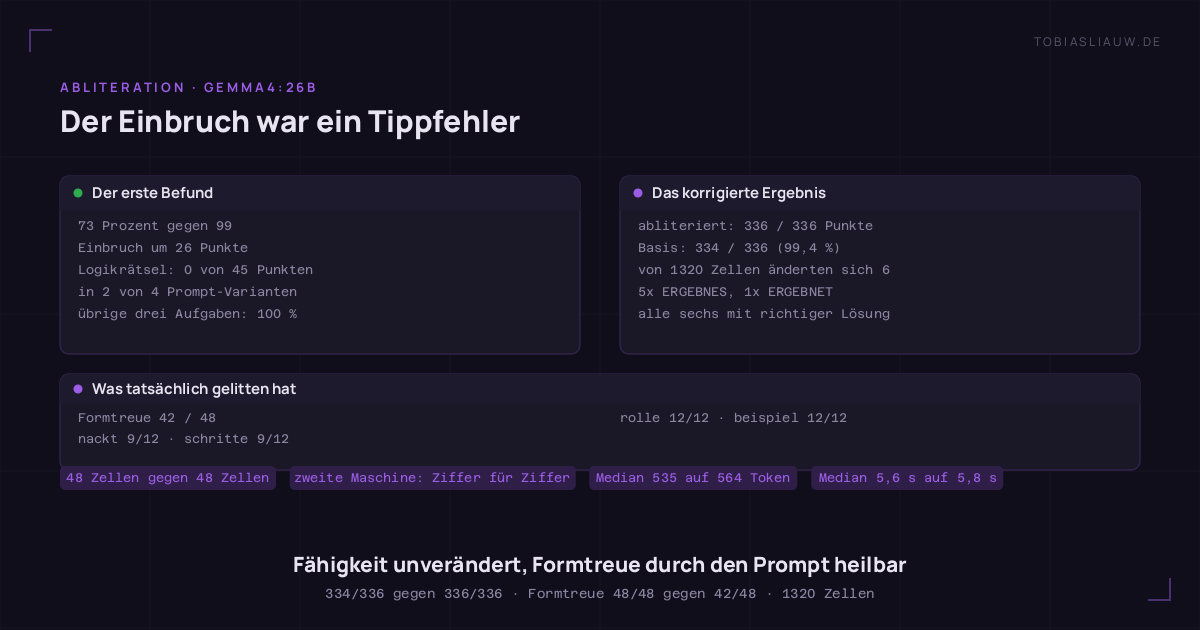
73 Prozent gegen 99. Ein Einbruch um 26 Punkte, und er war sauber lokalisiert: Rechnen, Zuordnen und Datenextraktion blieben bei glatten 100 Prozent, der gesamte Verlust steckte im Logikrätsel. Dort fiel das abliterierte Modell auf exakt null von 45 Punkten — in zwei der vier Prompt-Varianten, über alle Seeds hinweg.
„Abliteration kostet die Fähigkeit zum mehrstufigen Schließen“ wäre eine gute Überschrift gewesen. Sie hätte sich mit dem gedeckt, was man über den Eingriff vermutet. Und die Zahl stand da, dreifach abgesichert über drei Seeds.
Was mich gestört hat, war die Sauberkeit. Ein Fähigkeitsverlust sieht nicht aus wie null von 45 in zwei Varianten und 45 von 45 in den anderen beiden. Fähigkeiten bröckeln, sie schalten nicht um. Dazu kam eine Zahl, die zu genau passte: Die Formtreue lag bei 42 von 48 — sechs Fehlschläge, und es gab genau sechs Nullzellen.
Ein Buchstabe
Die Aufgabe verlangt, dass die Antwort in einer letzten Zeile steht, die mit ERGEBNIS: beginnt. Das abliterierte Modell hat das Rätsel gelöst — vollständig, mit einer selbst angelegten Gegenprüfung aller elf Bedingungen. Und dann geschrieben:
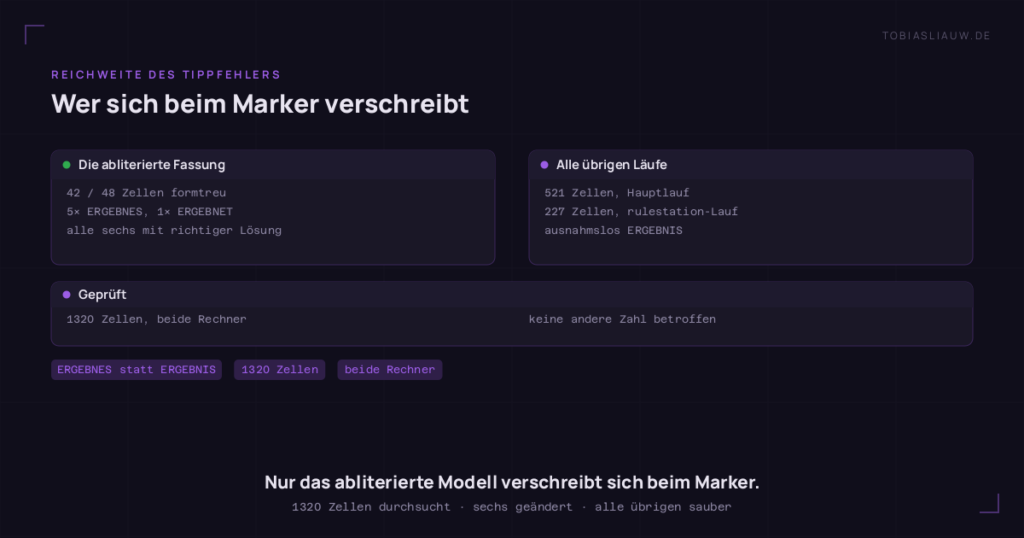
ERGEBNES: 1=Clara/Delta/Tee; 2=Anna/Atlas/Mate; 3=David/Echo/Kaffee; 4=Eva/Cirrus/Kakao; 5=Bernd/Boreas/WasserDas ist die korrekte Lösung. Bewertet wurde sie mit null, weil dort ERGEBNES steht und nicht ERGEBNIS. In fünf Zellen dieser Tippfehler, in einer sechsten ERGEBNET. Alle sechs enthalten die richtige Antwort.
Ich habe daraufhin sämtliche aufbewahrten Ausgaben beider Rechner nach Schreibvarianten des Markers durchsucht — 1320 Zellen. Ergebnis: Nur das abliterierte Modell verschreibt sich. In den 521 Zellen des Hauptlaufs, in den 227 des ersten rulestation-Laufs, in allen anderen: ausnahmslos ERGEBNIS. Keine anderen veröffentlichten Zahlen sind davon berührt.
Das korrigierte Ergebnis
Die Prüfroutine hat eine Nachsicht-Stufe bekommen: Findet sie im gesamten Text keinen exakten Marker, akzeptiert sie einen Fast-Treffer für die Richtigkeit — zählt ihn aber weiterhin als Formfehler. Weil sie nur greift, wenn gar kein sauberer Marker vorkommt, kann sie die Bewertung keiner bereits korrekt gelesenen Ausgabe verändern. Danach habe ich alle Läufe aus den gespeicherten Ausgaben neu bewertet. Von 1320 Zellen änderten sich sechs. Genau die sechs.
| gemma4:26b | abliteriert | |
|---|---|---|
| Punkte | 334 / 336 (99,4 %) | 336 / 336 (100 %) |
| Formtreue | 48 / 48 | 42 / 48 |
| Median Token | 535 | 564 |
| Median Zeit | 5,6 s | 5,8 s |
Auf diesen vier Aufgaben kostet Abliteration keine Fähigkeit. Das abliterierte Modell löst jede einzelne Zelle — auch die zwei, an denen die Basis zwei Punkte liegen ließ. Es ist geringfügig besser, und dieser Unterschied ist zu klein, um etwas zu bedeuten. Die ehrliche Aussage lautet: kein messbarer Unterschied in der Richtigkeit.
Was tatsächlich gelitten hat
Die Formtreue, und zwar nicht zufällig verteilt:
| Prompt-Variante | formtreue Zellen |
|---|---|
| nackt (nur die Aufgabe) | 9 / 12 |
| schritte („denk Schritt für Schritt“) | 9 / 12 |
| rolle (Modell bekommt eine Rolle) | 12 / 12 |
| beispiel (ein gelöstes Beispiel vorab) | 12 / 12 |
Das Modell verschreibt sich nur dort, wo der Prompt nichts weiter tut, als die Aufgabe zu stellen. Sobald er eine Rolle zuweist oder ein durchgerechnetes Beispiel zeigt, trifft es den Marker in zwölf von zwölf Fällen. Der Verlust ist also nicht nur klein — er ist durch den Prompt vollständig auffangbar.
Das ergibt auch Sinn, wenn man sich ansieht, was Abliteration tut. Sie greift in die Richtung ein, entlang derer das Modell einer Anweisung Folge leistet oder eben nicht. Dass dabei die Bindung an eine wörtlich vorgegebene Zeichenfolge etwas lockerer wird, während die Fähigkeit zu rechnen und zu schließen unberührt bleibt, passt zum Eingriff. Belegt ist das hier nicht — es ist eine Erklärung, die zu vier Aufgaben passt, mehr nicht.
Das dritte Mal
Es ist in dieser Serie der dritte Fall, in dem eine Prüfroutine ein korrekt antwortendes Modell mit null bewertet hätte. Zuerst eine Markdown-Überschrift, die den Marker verziert hat. Dann ein Modell, das nach der richtigen Antwort nicht aufhören konnte. Jetzt ein Buchstabe.
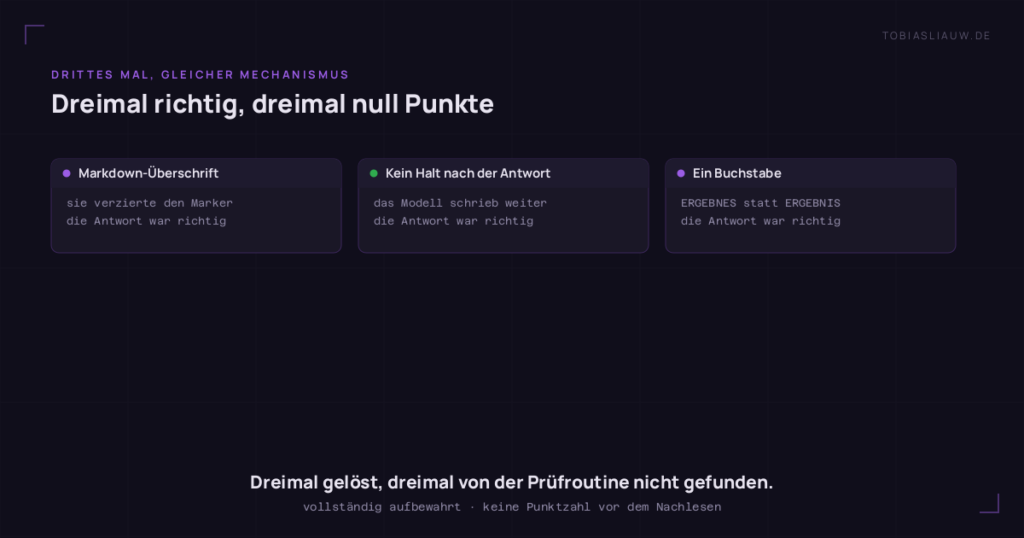
Dreimal derselbe Mechanismus: Das Modell hat die Aufgabe gelöst, und meine Software hat die Lösung nicht gefunden. Dreimal war die falsche Zahl plausibel, dreimal hätte sie zu einer Geschichte gepasst, die man gerne erzählt. Dass ich es überhaupt bemerkt habe, liegt nur an einer Regel: jede erzeugte Ausgabe wird vollständig aufbewahrt, und keine Punktzahl gilt, bevor ich die Ausgaben gelesen habe. Ohne die aufbewahrten Dateien hätte ich hier nichts nachrechnen können.
Die Regel steht seit dem ersten Artikel dieser Serie da. Ich habe sie inzwischen dreimal gebraucht.
Was das nicht zeigt
- Vier Aufgaben sind vier Aufgaben. Rechnen, Zuordnen, Extrahieren, ein Logikrätsel. Sie decken nicht ab, was Abliteration an Stil, Sicherheit oder langen Gesprächen verändert.
- Gemessen mit abgeschaltetem Denkmodus. Bei gemma4 greift dieser Schalter nachweislich — mit eingeschaltetem Denkmodus erzeugt es 2716 statt 562 Token. Für andere Modelle der Serie gilt das nicht, wie sich inzwischen gezeigt hat; darüber schreibe ich getrennt.
- Das ist eine Aussage über diese eine abliterierte Fassung — ein bestimmter Build eines bestimmten Modells. Andere Abliterationen anderer Modelle können anders ausfallen.
- Über den eigentlichen Zweck der Abliteration steht hier nichts. Ob das Modell tatsächlich weniger ablehnt, habe ich nicht gemessen. Gemessen habe ich nur, was es dabei an Können eingebüßt hat — nämlich nichts Messbares.
Korrigiert am 02.08.2026: Der Schalter steuert nicht, ob gedacht wird. Bei qwq:32b sind die Ausgaben mit und ohne think byteidentisch; bei deepseek-r1:14b bleibt die Zahl erzeugter Token exakt gleich (1402) und nur die Denkblöcke wandern aus dem Antworttext heraus. Für gemma4:26b (562 → 1261 Token) und qwen3:8b (730 → 1448) wirkt er wie erwartet. Die Einschränkung „mit abgeschaltetem Denkmodus gemessen“ gilt also nicht pauschal für alle Modelle. An den Messwerten ändert sich nichts. Zahlen am 03.08.2026 berichtigt: die beiden Paare verglichen versehentlich verschiedene Aufgaben (Planung gegen Rätsel, Rechnung gegen Planung). Richtig sind 562 → 1261 und 730 → 1448; an der Aussage ändert sich nichts.
Zur Sicherheit habe ich die ganze Messung auf der zweiten Maschine wiederholt. Sie reproduziert das Ergebnis Ziffer für Ziffer: Basis 334 von 336, abliteriert 336 von 336, Formtreue 48 von 48 gegen 42 von 48, dieselben sechs verschriebenen Marker. Und die Formtreue zerfällt auf beiden Rechnern nach demselben Muster — ohne Rolle und ohne Beispiel jeweils 9 von 12, mit Rolle und mit Beispiel jeweils 12 von 12. Zwei Maschinen, die sich außer dem GPU-Modell fast nichts teilen, nicht einmal den Platinenhersteller. Dass beide auf dieselbe Zahl kommen, macht aus einem Einzelbefund einen Befund.
Die Überschrift, die ich beinahe geschrieben hätte, wäre die interessantere gewesen. Sie war nur nicht wahr.