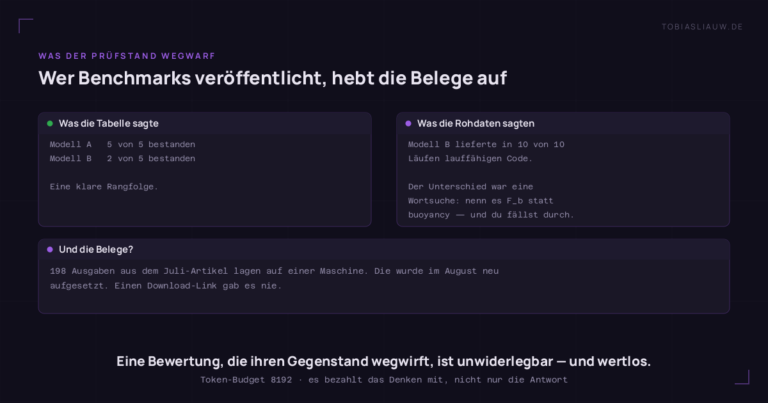
Wer Benchmarks veröffentlicht, muss die Artefakte aufheben
Ich habe im Juli einen Artikel über Determinismus bei lokalen Modellen veröffentlicht. Darin steht der Satz: „Alle 198 Ausgaben liegen vollständig vor, damit man mir widersprechen…
Ich habe im Juli einen Artikel über Determinismus bei lokalen Modellen veröffentlicht. Darin steht der Satz: „Alle 198 Ausgaben liegen vollständig vor, damit man mir widersprechen…
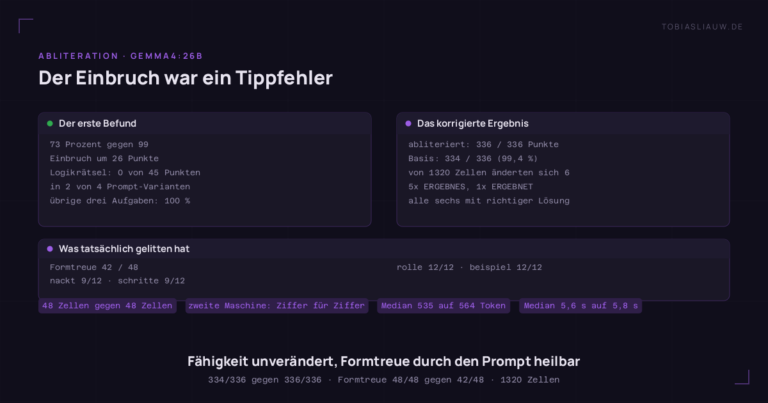
Ein abliteriertes Modell fiel im Logikrätsel auf exakt null von 45 Punkten. „Abliteration zerstört das Denken" wäre eine gute Überschrift gewesen. Sie war nur nicht wahr…
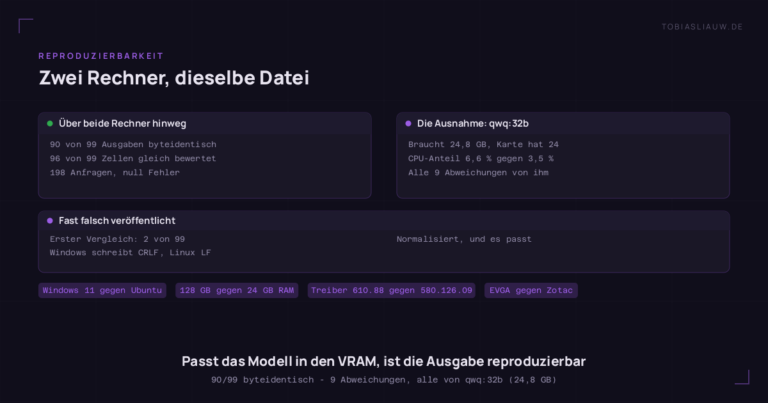
Elf lokale Modelle, drei echte Arbeitsaufgaben, zwei RTX-3090-Hosts, 198 Anfragen, null Fehler. 90 von 99 Ausgaben kamen über beide Rechner hinweg byteidentisch zurück — und die…
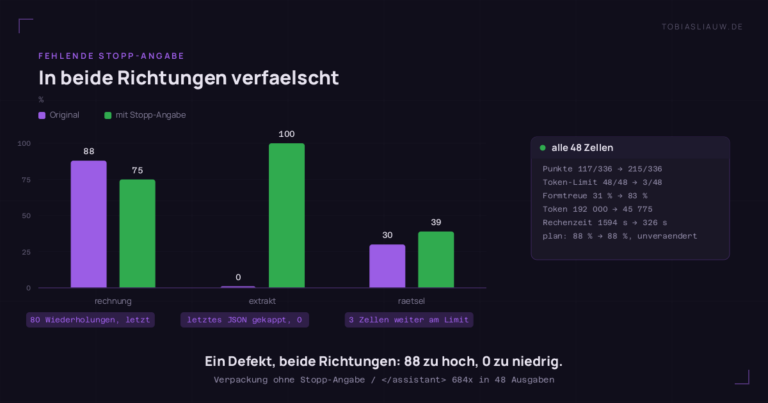
Ein Modell steht mit 35 Prozent am Tabellenende. Die Zahl ist echt gemessen — und trotzdem falsch, in beide Richtungen zugleich. Was passiert, wenn eine Ollama-Verpackung…
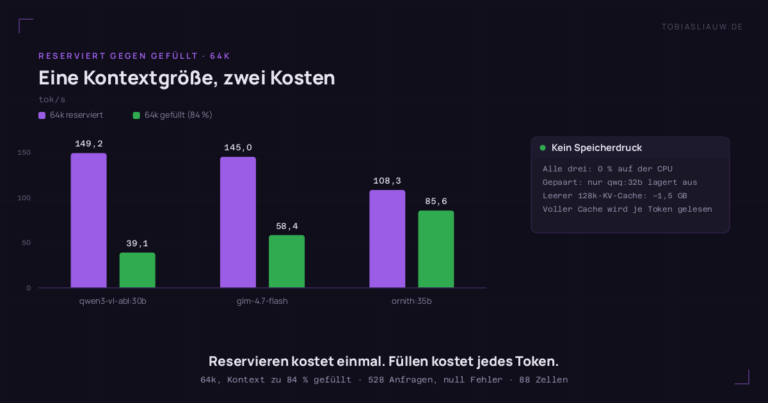
Zwei RTX 3090, elf Modelle mit identischen Digests, 528 Anfragen ohne Fehler. Einen 128k-KV-Cache zu reservieren ist beinahe umsonst; ihn zu füllen kostet 10 bis 66…
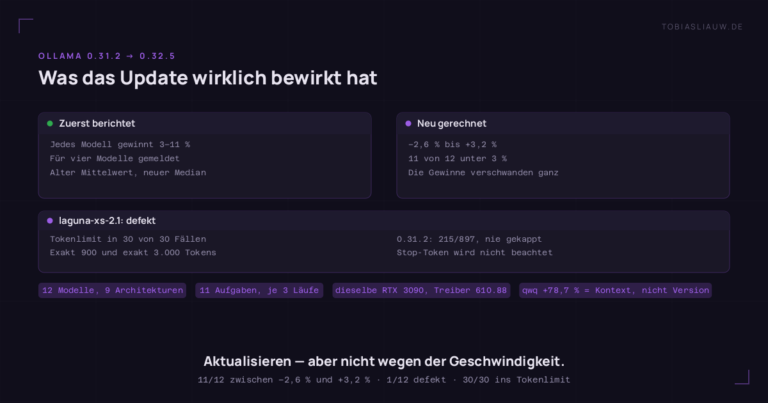
Ollama 0.32.5 war draußen, meine Workstation lief noch auf 0.31.2, und ich hatte gerade 26 Modelle darauf durchgemessen. Damit ergab sich eine seltene Gelegenheit: dieselbe Maschine,…
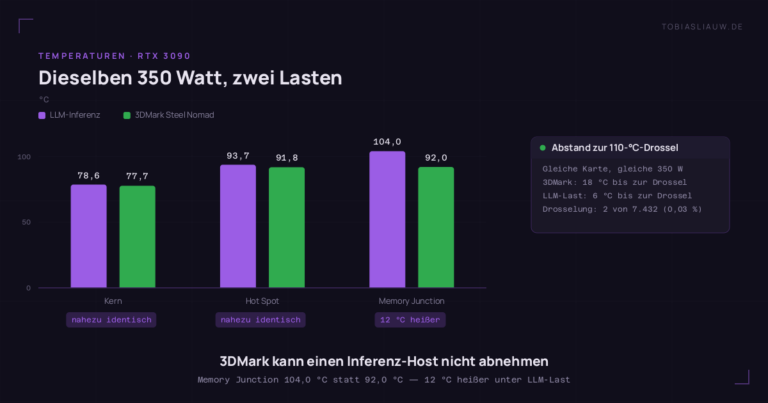
In meiner Windows-Workstation steckt eine RTX 3090, die demnächst ausgebaut und als Proxmox-AI-Host neu aufgesetzt wird. Vorher wollte ich für jedes Modell, das ich darauf halte,…
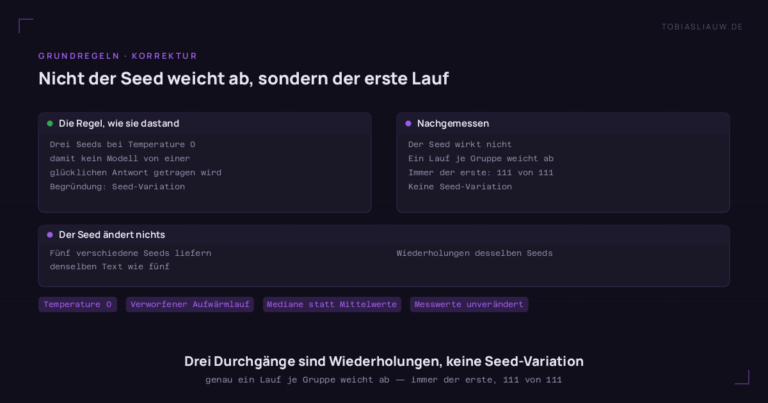
Zwei Hosts, die sich eine Grafikkarte teilen und sonst fast nichts, eine Bewertung, die nur zählt, was ein Skript nachprüfen kann, und die Regeln, die jede…
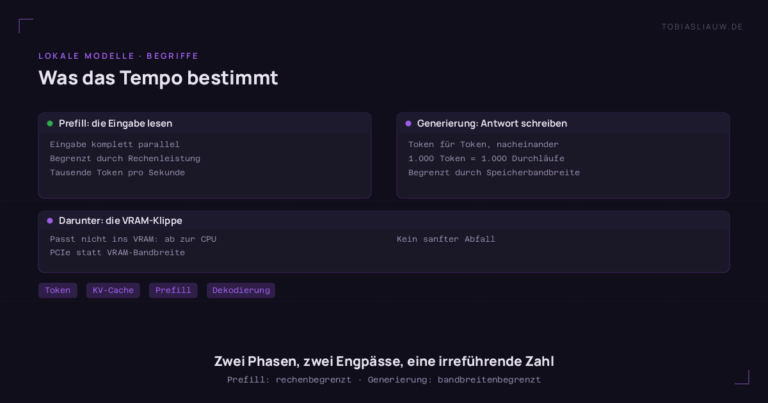
Der Auftakt einer Serie, in der ich messe, was lokale Sprachmodelle auf käuflicher Hardware tatsächlich leisten. Dieser erste Teil enthält keine Messungen — er ist das…
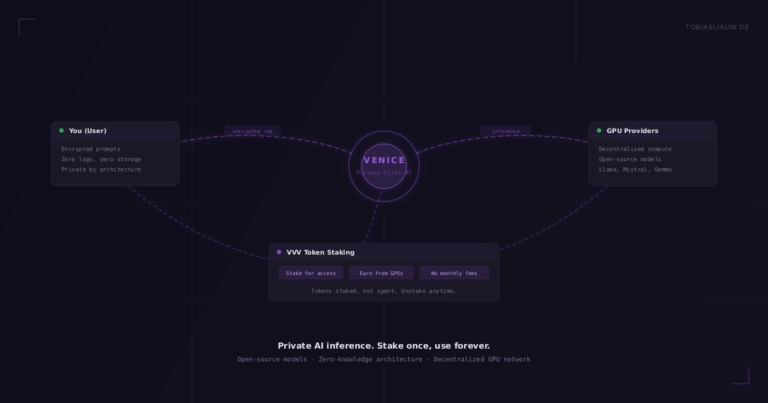
Venice.ai betreibt quelloffene Modelle mit Zero-Knowledge-Datenschutz. Keine Protokolle, kein Training mit deinen Daten. Das Staking-Modell des VVV-Tokens gibt dauerhaften KI-Zugang ohne Monatsgebühr. Wie es funktioniert und…