Mein Homelab lief jahrelang auf einem Proxmox-Knoten, der irgendwann nicht mehr passte: keine GPU mehr im Gehäuse, aber immer mehr Workloads, die eine brauchten. Die Lösung stand daneben — eine Workstation, die ich seit Jahren kaum noch anfasste. Dieser Text beschreibt, was aus ihr wurde und was der Umzug dorthin gekostet hat.
Teil 1 — Aus einer Workstation wird ein Hypervisor
Die Hardware ist eine Generation alt. Das ist der Punkt.
Der neue Knoten ist kein gekaufter Server, sondern ein Selbstbau von 2020. Man sieht es ihm bis heute im DMI an: Manufacturer: System manufacturer, Product Name: System Product Name. Niemand hat je eine Identität eingetragen.
| Mainboard | ASUS ROG Strix X299-E Gaming (Intel X299, LGA 2066), BIOS von Juni 2020 |
| CPU | Intel Core i9-10920X, 12 Kerne / 24 Threads, 3,5–4,8 GHz |
| RAM | 128 GB DDR4 (4 × 32 GB, Dual Rank), effektiv 2933 MT/s |
| GPU | 2 × NVIDIA RTX 3090, zusammen 48 GB VRAM |
| Datenträger | 5 × NVMe, 1 × SATA-SSD, 2 × SATA-HDD — rund 14,5 TB roh |
Eine CPU mit AVX-512 und 24 Threads, 128 GB RAM und 48 GB VRAM: als Hypervisor schlägt das die meisten Fertigserver derselben Preisklasse deutlich. Der Haken kommt an anderer Stelle.
Storage: drei Pools, drei Aufgaben
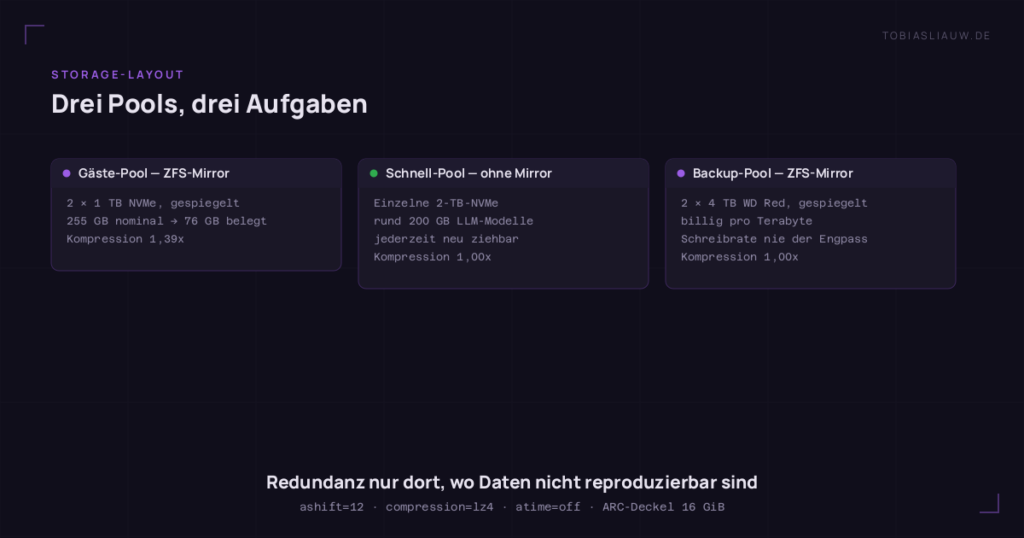
Die Aufteilung folgt einer simplen Regel — Gäste auf gespiegeltes NVMe, Modelle auf schnelles Einzel-NVMe, Backups auf gespiegelte Rotationsplatten.
- Gäste-Pool — ZFS-Mirror aus zwei 1-TB-NVMe. Hier zeigt sich sofort der Charme dünner ZFS-Subvolumes: Volumes, die auf dem alten Knoten nominal 255 GB provisioniert waren, belegen hier rund 76 GB.
- Schnell-Pool — eine einzelne 2-TB-NVMe, bewusst ohne Redundanz. Dort liegen nur reproduzierbare Daten: rund 200 GB LLM-Modelle, jederzeit neu ziehbar. Wer dort etwas anderes ablegt, muss das wissen.
- Backup-Pool — ZFS-Mirror aus zwei 4-TB-WD-Red. Rotationsplatten sind für Backups genau richtig: billig pro Terabyte, und die Schreibrate ist beim Dumpen nie der Engpass.
Einheitlich ashift=12, compression=lz4, atime=off. Das Kompressionsverhältnis auf dem Gäste-Pool liegt bei 1,39x — auf den anderen beiden bei 1,00x, weil Modelle und zstd-Dumps längst komprimiert sind. Der ARC ist per modprobe.d auf 16 GiB gedeckelt, damit er den Gästen kein RAM wegfrisst.
Wo die Plattform ihr Alter zeigt
Hier liegt der eigentliche Kompromiss:
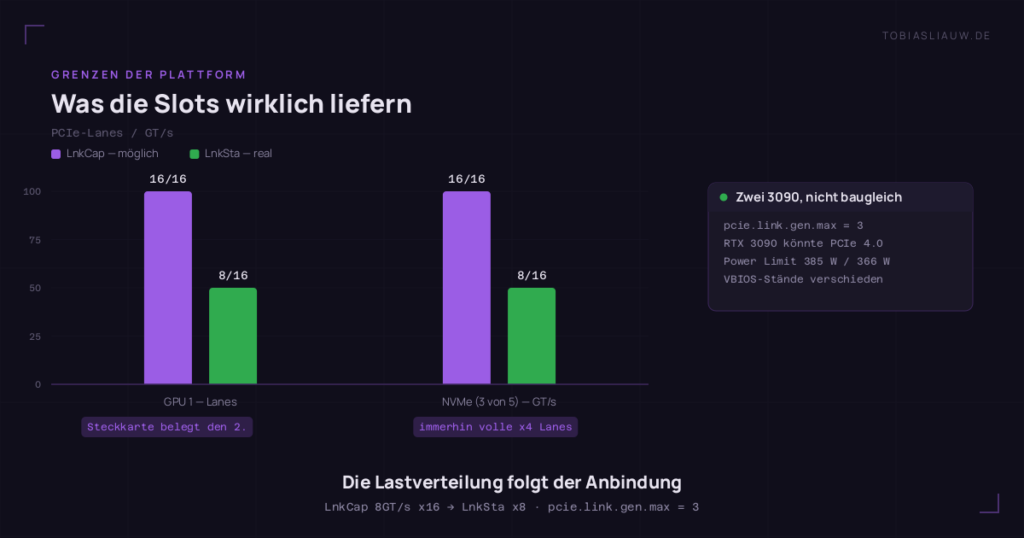
GPU 0   LnkCap 8GT/s x16  →  LnkSta x16     volle Anbindung
GPU 1   LnkCap 8GT/s x16  →  LnkSta x8      halbiert
Die zweite Karte läuft elektrisch nur auf x8, weil eine Steckkarte den zweiten x16-Slot belegt. Baulich nicht behebbar — also muss die Lastverteilung es berücksichtigen: der rechenintensive Container bekommt die x16-Karte, der Transcoding-Container die x8.
Dazu meldet nvidia-smi für beide Karten pcie.link.gen.max = 3. Die RTX 3090 kann PCIe 4.0, die X299-Plattform bietet 3.0. Dasselbe bei drei der fünf NVMe: LnkCap 16GT/s trifft auf LnkSta 8GT/s. Alle laufen immerhin mit vollen x4 Lanes.
Und die beiden 3090 sind nicht einmal baugleich — unterschiedliche VBIOS-Stände, 385 W gegen 366 W Power Limit.
GPU-Passthrough in LXC: drei Stolpersteine
1. Die Device-Major-Nummern sind hostspezifisch. Auf dem neuen Host lauten sie 195 / 510 / 235 für nvidia, nvidia-uvm und nvidia-caps. Auf dem alten waren es 195 / 505 / 508. Wer eine lxc.cgroup2.devices.allow-Zeile aus einer alten Config übernimmt, reicht die falschen Geräte durch — auf dem neuen Host ist 508 nämlich lirc. Immer aus /proc/devices neu ablesen.
2. Die Geräteknoten müssen vor den Gästen existieren. Dafür braucht es eine eigene Unit, deren ganzer Wert in der Reihenfolge liegt:
After=systemd-modules-load.service
Before=pve-guests.service pve-container@.service
Type=oneshot
RemainAfterExit=yes
ExecStart=/usr/bin/nvidia-modprobe -c 0 -c 1 -u
3. c 195:* rwm ist keine GPU-Aufteilung. Das habe ich auf die harte Tour gelernt. Beim Nachziehen des NVIDIA-Userspace legte der Installer selbst einen fehlenden Geräteknoten an — und weil die cgroup-Regel alle Minor-Nummern erlaubte, sah der Container plötzlich beide Karten statt einer. Die Aufteilung hing gar nicht an einer Regel, sondern nur daran, dass der Knoten zufällig fehlte. Richtig ist, die Minor-Nummer explizit zu nennen.
Noch eine Falle, die einen halben Abend kostet: der NVIDIA-Userspace im Container muss zur Host-Treiberversion passen. Sonst kommt Failed to initialize NVML: Driver/library version mismatch. Der Fix ist <treiber>.run --no-kernel-module --silent im Container — das Kernelmodul kommt vom Host, der Userspace muss separat nach.
Netz: eine Gigabit-NIC für 48 GB VRAM
Der einzige aktive Uplink ist die Onboard-Gigabit-Karte. Das klingt nach einem Detail und ist in Wahrheit die prägendste Einschränkung des ganzen Aufbaus — im zweiten Teil wird sich zeigen, warum.
Darauf liegen drei Bridges: die LAN-Management-Bridge, eine VLAN-Bridge fürs IoT-Netz und eine interne Bridge ohne physischen Port für isolierte Worker-VMs.
Die VLAN-Bridge trägt eine Zeile, die man einmal schmerzhaft lernt:
post-up echo 0 > /sys/class/net/<bridge>/bridge/multicast_snooping
IGMP-Snooping muss dort aus, sonst findet die Hausautomatisierung die Hälfte ihrer Geräte nicht mehr.
Die isolierte Bridge ist das interessantere Stück: Gäste bekommen Internet per NAT, aber kein LAN. Sechs Regeln, und die Reihenfolge entscheidet — eine gezielte Ausnahme für zwei Monitoring-Ports steht vor dem generellen Block des privaten Adressbereichs. Jede post-up-Regel hat ein exaktes post-down-Gegenstück mit 2>/dev/null || true, damit ein ifdown sauber abräumt, ohne über fehlende Regeln zu stolpern.
Teil 2 — Der Umzug, und was dabei schiefging
Migration zwischen zwei Standalone-Hosts
Beide Knoten sind eigenständig, kein Cluster. Trotzdem gibt es pct remote-migrate beziehungsweise qm remote-migrate: eine Gast-Migration zwischen unabhängigen Hosts über einen API-Token und einen WebSocket-Tunnel. Kein gemeinsamer Storage nötig, keine Cluster-Mitgliedschaft. Auf dem Papier elegant.
In der Praxis sind es sieben Fallstricke. Sechs davon sind unangenehm, aber sichtbar. Der siebte ist der, wegen dem ich diesen Text schreibe.
Die sechs sichtbaren
1. LVM-thin nach ZFS geht nicht direkt. lvmthin exportiert das Format raw+size, zfspool spricht ausschließlich zfs. Es gibt keine Konvertierung im Migrationspfad. Also erst auf einen formatkompatiblen Storage migrieren und danach lokal per move-volume verschieben.
2. Bind-Mounts blockieren die Migration — cannot migrate local bind mount point. Sie müssen vorher aus der Config entfernt und danach auf beiden Seiten wieder eingetragen werden.
3. Der Container muss dafür gestoppt sein. Ein set --delete mpN landet auf einem laufenden Container nur im Pending-Bereich; die Mounts bleiben aktiv und die Migration bricht trotzdem ab.
4. Feature-Flags außer nesting scheitern am Token. Ein API-Token darf sie nicht setzen, die API antwortet mit 403. Vor dem Transfer reduzieren, danach beidseitig zurückschreiben — und daran denken, dass Docker im Container keyctl braucht.
5. Rohe lxc.*-Zeilen werden nicht übertragen. Kein lxc.cgroup2.devices.allow, kein lxc.mount.entry. Für Container mit /dev/net/tun oder GPU-Durchreichung heißt das: von Hand nachtragen. Kurios: vzdump überträgt sie sehr wohl.
6. Übertragen wird die provisionierte, nicht die belegte Größe. Ein Container mit 430 GB provisioniert und 60 GB belegt schiebt 430 GB durch die Leitung. Bei einem Gigabit-Uplink ist das der Unterschied zwischen einer und acht Stunden. Für solche Fälle ist der Umweg über vzdump besser: dateibasiert, und beim Restore lässt sich die Rootfs-Größe neu wählen.
Der siebte: rc=0 und trotzdem kaputt
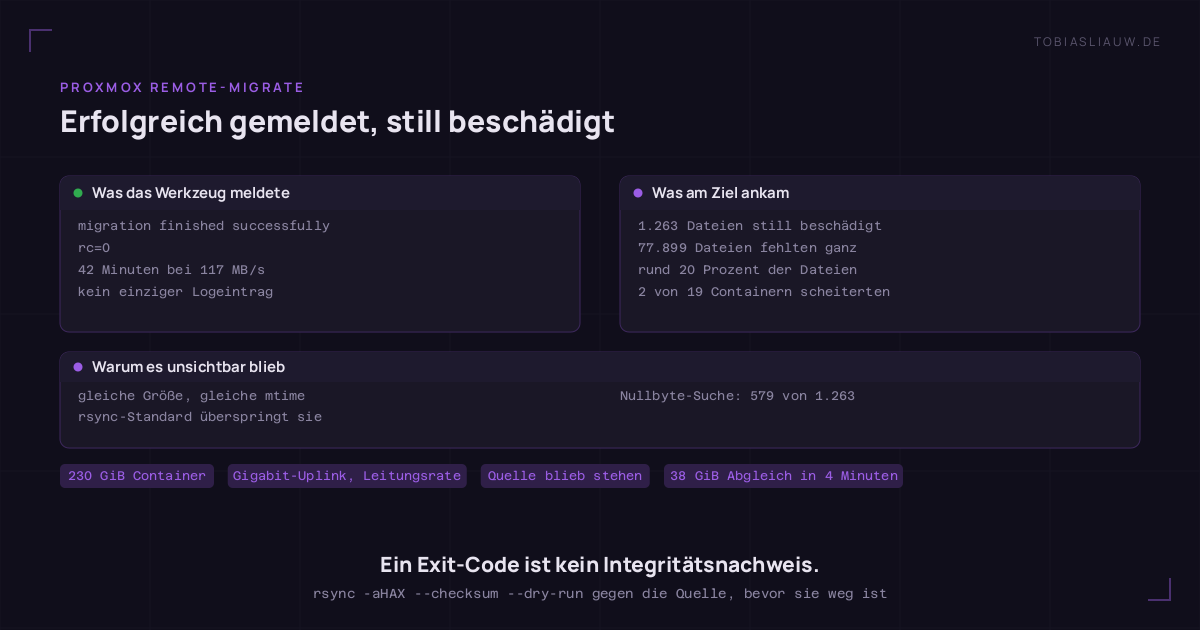
Der letzte Container war der größte: ein Offline-Wissensserver mit 230 GiB, davon 200 GiB Vektordatenbank. Der Transfer lief 42 Minuten mit konstanten 117 MB/s — Leitungsrate für Gigabit. Am Ende:
migration finished successfully
rc=0
Beim ersten Start am Ziel scheiterten zwei von neunzehn Docker-Containern:
redis:   Wrong signature trying to load DB from file
homebox: failed to mount ... fstype: overlay ... err: bad message
bad message ist EBADMSG, und bei ext4 ist das der Code für einen Metadaten-Prüfsummenfehler — kein overlayfs-Problem, wie man zuerst vermutet. Der Kernel hatte es längst selbst protokolliert:
EXT4-fs error: __ext4_find_entry: checksumming directory block 0
EXT4-fs warning: No space for directory leaf checksum. Please run e2fsck -D.
tune2fs -l bestätigte: Filesystem state: clean with errors, erster Fehler exakt zum Startzeitpunkt.
Der Umfang war deutlich größer als die zwei Container
Nach e2fsck -fyD folgte ein Vollabgleich gegen die noch unangetastete Quelle:
| rsync-Kennung | Anzahl | Bedeutung |
|---|---|---|
<fc........ |
1.152 | gleiche Größe, gleiche mtime, anderer Inhalt |
| weitere Varianten | 111 | ebenfalls inhaltlich abweichend |
<f+++++++++ |
77.899 | fehlte am Ziel komplett |
1.263 Dateien waren still beschädigt, und rund 20 Prozent der Dateien fehlten ganz. Bei rc=0. Ohne einen einzigen Logeintrag.
Warum das so lange unsichtbar bleibt
Der Quellcontainer lief seit Tagen durch — alle betroffenen Dateien lagen im Page-Cache. Erst der Kaltstart am Ziel liest sie von der Platte. Dieselbe Mechanik erklärt, warum auf der Quelle nie etwas auffiel. „Läuft doch“ ist deshalb kein Integritätsnachweis.
Die Reparatur — und der eine entscheidende Schalter
e2fsck -fyD /dev/<vg>/<volume>
mount -o ro,noload /dev/<vg>/<volume> /mnt/quelle
rsync -aHAX --numeric-ids --checksum --delete --itemize-changes /mnt/quelle/ ziel:/mnt/ziel/
--checksum ist der ganze Punkt. Die beschädigten Dateien haben dieselbe Größe und dieselbe mtime wie das Original — rsyncs Standardheuristik überspringt sie ausnahmslos. Ohne diesen Schalter meldet der Lauf „nichts zu tun“ und bestätigt den Schaden. Der Abgleich über 38 GiB dauerte vier Minuten.
Die Regel, die daraus folgt
Nach jeder
remote-migrateeinenrsync --checksum --dry-rungegen die Quelle fahren, bevor die Quelle angefasst oder gelöscht wird.rc=0ist kein Nachweis.
Und Heuristiken taugen als Vorfilter, nicht als Freigabe. Eine Suche nach Dateien mit komplett genullten ersten 4 KiB fand nur 579 der 1.263 Schäden — weniger als die Hälfte. Sie fand null Treffer in /usr/bin, /usr/lib und /usr/sbin; der Schaden lag in den Container-Layern und im Anwendungsverzeichnis. Wer nur Systemverzeichnisse scannt, sieht garantiert nichts.
Zwei Lektionen, die nichts mit dem Migrationswerkzeug zu tun haben
Geteilte Backup-Stores prunen nicht nach Knoten. Beide Hosts schrieben in denselben flachen Export. Die Prune-Funktion nimmt Storage, Retention, VMID und Typ — keine Node-Dimension, und die Dateinamen tragen kein Knotenkennzeichen. Die Jobs beider Knoten räumen also gegenseitig ihre Archive weg. In meinem Fall drohte das in beide Richtungen gleichzeitig: der neue Wochenjob hätte die bewusst gehaltenen Monatsarchive des alten gelöscht, dessen Tagesjobs hätten die frischen Kopien binnen drei Tagen verdrängt.
Konfiguration steckt nicht nur in Konfigurationsdateien. Ein Orchestrator wies trotz korrigierter .env weiter Aufgaben dem alten Host zu — rund 400 API-Requests pro Stunde. Die Ursache lag in einer SQLite-Datenbank: eine Tabelle zeigte längst richtig, aber fünfzehn Zeilen einer anderen trugen noch den alten Knotennamen. Ein grep -r über /etc findet so etwas nie.
Was den Umzug am Ende gerettet hat
Zwei Entscheidungen, beide vorher getroffen:
Die Quelle blieb stehen. remote-migrate löscht sie nur bei explizitem --delete. Ohne die intakte Quelle wäre die Reparatur schlicht unmöglich gewesen — es hätte nichts gegeben, wogegen man hätte vergleichen können.
Alles lief detached. Ein früherer Versuch war an interrupted by signal gestorben, mit hoher Wahrscheinlichkeit ein SIGHUP durch eine abbrechende SSH-Sitzung. Seitdem läuft jede lange Operation unter systemd-run --unit=…. Seitdem ist keine mehr abgebrochen.
Der eigentliche Ertrag dieses Umzugs ist nicht der schnellere Host. Es ist die Gewissheit, dass ein rc=0 nichts beweist — und die Angewohnheit, das nachzuprüfen, solange die Quelle noch da ist.