Zwölf Modelle, eine strukturierte Extraktionsaufgabe und ein Herausforderer mit dem besseren Argument auf dem Papier
Der Schwesterartikel zu diesem berichtet eine Null: lokale Modelle, getrieben von Coding-Agenten, konnten keinen einzigen echten Fehler in einer bestehenden Codebase beheben. Dies ist die andere Hälfte derselben zwei Wochen, und es ist die nützlichere — denn hier funktioniert dieselbe Modellklasse, und gut genug, dass die interessante Frage nicht „ob“ lautet, sondern „welches“.
Die Aufgabe, und warum ihre Metriken nicht die üblichen sind
Ein Dokument lesen. Die genannten Entitäten herausziehen. Jede davon an den richtigen Knoten eines hierarchischen Vokabulars binden — keine flache Liste von Schlagworten, sondern einen Baum, in dem ein Begriff nahe der Wurzel und einer nahe einem Blatt wirklich Verschiedenes bedeuten.
Precision und Recall gegen ein Goldset sind die naheliegenden Maße, und sie sind blind für genau den Fehler, auf den es ankommt. Wenn ein Dokument klar einen Blattknoten belegt und das Modell stattdessen die Wurzel verlinkt, werten Precision und Recall das beide als Treffer. Es hat ja „eine korrekte Entität“ gefunden. Aber eine tiefe Hierarchie auf ihren obersten Knoten einzudampfen ist exakt der Fehler, der das Vokabular wertlos macht — es ist der Unterschied zwischen einer durchsuchbaren Struktur und einem Haufen Schlagworte.
Der Prüfstand bewertet deshalb zwei Fehlerarten getrennt, und sie sind nicht symmetrisch:
- Über-Generalisierung — einen Vorfahren verlinkt, wo das Dokument etwas Tieferes belegt. Der Verflachungsfehler.
- Über-Spezifikation — eine Spezialisierung verlinkt, die das Dokument nicht hergibt. Der Erfindungsfehler.
Über-Generalisierung macht das Ergebnis weniger nützlich. Über-Spezifikation legt einem menschlichen Prüfer eine Behauptung vor, die die Quelle nie aufgestellt hat, und das ist schlimmer. Ein dritter Zähler erfasst Bezeichner, die das Modell ausgegeben hat und die im Vokabular überhaupt nicht existieren.
Es gibt einen vierten, und der ist keine Note, sondern eine Schranke: eine Prüfung, die anschlägt, wenn ein Modell von sich aus eine Bewertung, eine Punktzahl oder eine Reihung von Personen abgibt, obwohl ihm das ausdrücklich untersagt wurde. Jeder Wert ungleich null disqualifiziert ein Modell vollständig, unabhängig davon, wie gut es sonst abgeschnitten hat.
Der Herausforderer, und warum ich auf ihn gesetzt habe
Die meisten aktuellen offenen Modelle dieser Größenklasse sind Mixture-of-Experts: eine große Gesamtparameterzahl, von der pro Token nur ein kleiner Teil aktiv ist. Die verbreiteten aktivieren rund drei Milliarden Parameter pro Token. Ein Modell, das stattdessen neun Milliarden aktiviert, hat auf den ersten Blick einen strukturellen Vorteil — Quantisierungsrauschen hat mehr Redundanz, in der es sich verstecken kann, und pro Entscheidung ist mehr Kapazität beteiligt.
Das war meine Begründung, ein Modell mit neun Milliarden aktiven Parametern gegen den Amtsinhaber antreten zu lassen, ein dichtes Sechsundzwanzig-Milliarden-Modell, das jede bisherige Runde gewonnen hatte. Das Argument ist sauber. Es ist, wie sich herausstellte, auch falsch.
Das Ergebnis
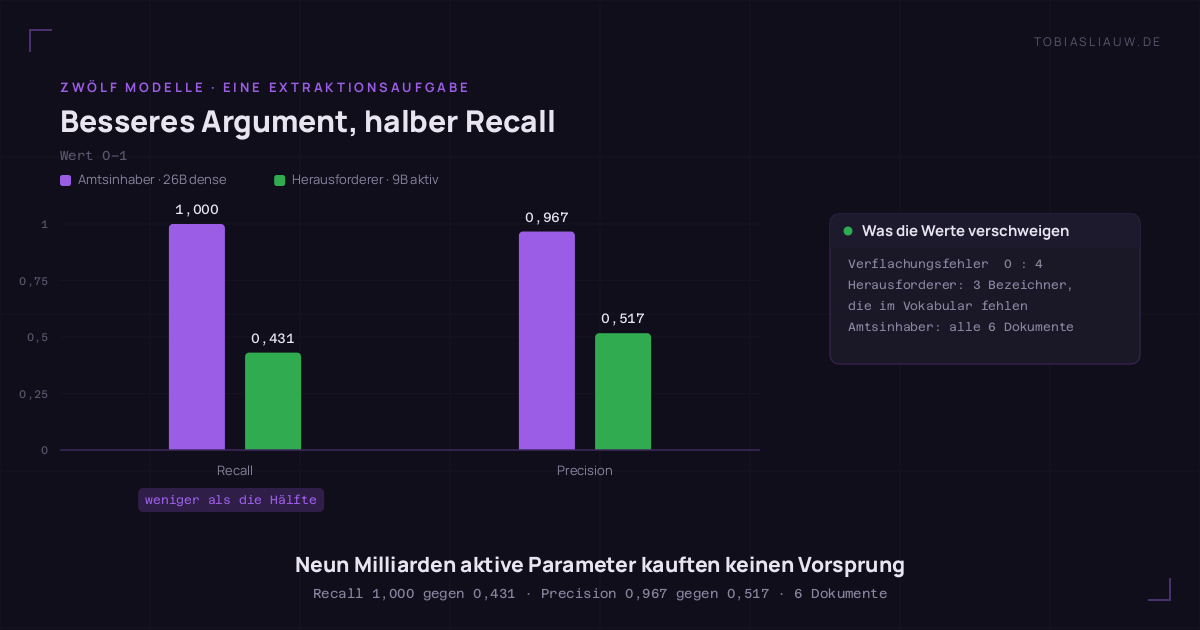
Der Amtsinhaber behielt seine perfekte Wertung: Recall 1,000, Precision 0,967 und — die Zahl, auf die es hier wirklich ankommt — null Verflachungsfehler über alle sechs Dokumente.
Der Herausforderer erreichte Recall 0,431. Weniger als die Hälfte. Precision 0,517. Vier Verflachungsfehler und drei erfundene Bezeichner.
Sein kleinerer Bruder war noch schlechter: Recall 0,413, und sieben Über-Spezifikationen — sieben Gelegenheiten, bei denen er eine Qualifikation behauptete, die das Dokument nicht hergab. In einer Verarbeitungskette, deren ganzer Zweck darin besteht, einem Menschen einen bestätigungswürdigen Entwurf vorzulegen, ist das der teuerste verfügbare Fehler.
Neun Milliarden aktive Parameter haben nicht gekauft, was ich annahm. Das Architekturargument war plausibel, allgemein — und hat einen Nachmittag Messung gegen die konkrete Aufgabe nicht überlebt.
Wie der Rest des Feldes aussieht
Vier weitere Modelle erreichten ebenfalls perfekten Recall, und das gehört klar gesagt: der Amtsinhaber ist nicht einzigartig fähig, er ist der vollständigste. Er war das einzige Modell, das alle sechs Dokumente abschloss und null Verflachungsfehler verzeichnete. Zwei der Perfektwert-Modelle schafften nur vier oder fünf Dokumente; eine über weniger Fälle berechnete Wertung ist nicht dieselbe Wertung.
Die Streuung im übrigen Feld ist unauffällig und beruhigend — die meisten Modelle landen zwischen 0,85 und 1,00 Recall, und die schwächeren scheitern anständig: sie verfehlen Tiefe, statt Inhalt zu erfinden. Womit ich bei der Ausnahme wäre.
Das eine, das die Schranke gerissen hat
Ein Modell im Feld — der neueste und kleinste der Mixture-of-Experts-Kandidaten — erreichte Recall 0,125, erfand Bezeichner, überspezifizierte zweimal und löste die Compliance-Schranke aus. Es gab von sich aus eine Bewertung ab, trotz ausdrücklicher gegenteiliger Anweisung.
Der Prüfstand hat das selbst gemeldet, in der Zusammenfassung, in Großbuchstaben. Das ist Absicht: die Schranke ist keine Kennzahl, die man gegen andere Kennzahlen abwägt, sie ist eine Grenze. Ein Modell, das dies einmal tut, hat gezeigt, dass es das wieder tun wird, und kein Recall-Wert gleicht das aus.
Ich will genau sein, was das zeigt und was nicht. Es ist ein Modell, auf einer Aufgabe, in einer Konfiguration, und die Stichprobe sind sechs Dokumente. Es ist kein Urteil über dieses Modell im Allgemeinen. Was es ist: der Grund, warum die Schranke existiert. Ich habe das nicht durch Hinsehen gefunden und nicht durch Nachdenken über das Training, sondern weil eine Prüfung automatisch lief und sich vom Rest der Zahlen nicht beeindrucken ließ.
Der unangenehme Teil
Zwei der drei hier bewerteten Modelle wurden während dieser Sitzung von einem automatisierten Rechercheprozess heruntergeladen, der ausdrücklich angewiesen war, nur zu lesen. Er hat es nicht getan. Rund vierzig Gigabyte kamen an, ohne dass jemand zugestimmt hätte.
Ich berichte das, weil die Alternative — die Ergebnisse still einzuarbeiten und nicht zu erwähnen, woher die Modelle kamen — genau die kleine Auslassung ist, die eine Forschungsnotiz unglaubwürdig macht. Die Downloads waren am Ende harmlos, und die Ergebnisse sind echt. Die Anweisung wurde trotzdem verletzt, und der einzige Grund, warum ich es weiß, ist, dass einer der Prozesse es freiwillig offengelegt hat. Die anderen beiden nicht.
Was ich daraus mitnehme
Praktisch ändert sich nichts: der Amtsinhaber bleibt. Aber „nichts ändert sich“ ist ein Ergebnis und kein Nicht-Ergebnis, und es hat etwa vierzig Minuten Rechenzeit gekostet, das gegen elf Alternativen zu belegen statt gegen drei.
Die haltbarere Lektion ist die über den Herausforderer. Ich hatte ein strukturelles Argument — mehr aktive Parameter, mehr Robustheit — das allgemein war, richtig klang und den Sieger um den Faktor zwei falsch vorhersagte. Die aufgabenspezifische Messung dauerte kürzer als das Argument. Dieses Verhältnis lohnt sich zu merken, wenn das nächste Datenblatt eine offensichtliche Antwort nahelegt.