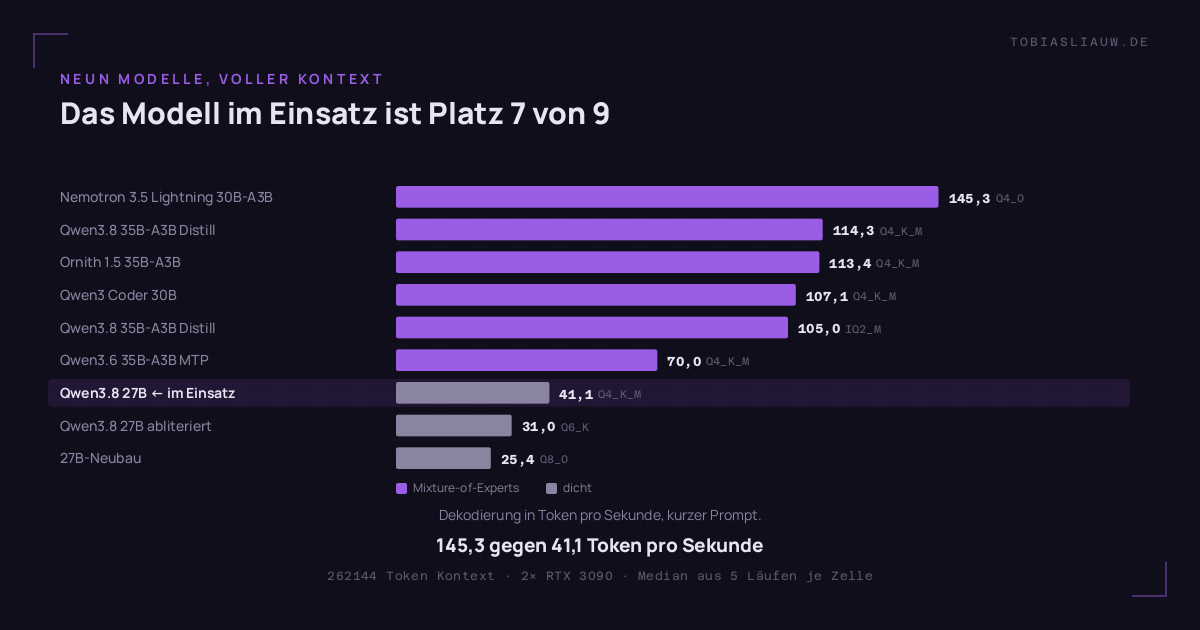
Neun lokale Modelle, drei Promptlängen, Denkkette an und aus, alles bei 262144 Token Kontext auf zwei RTX 3090 — und das Modell, das hier seit Wochen die Arbeit macht, landet auf Platz 7 von 9. Das schnellste im Feld liefert 145,3 gegen 41,1 Token pro Sekunde und braucht dabei 4,7 GB weniger Speicher.
Das ist die Tabelle. Der interessantere Teil dieses Textes ist, was bei der Prüfung der Tabelle kaputtgegangen ist — einschließlich einer Erklärung, die ich erst für widerlegt hielt und die dann doch stimmte.
Geschwindigkeit ist hier die falsche einzelne Achse
Das Modell, das mit 145,3 Token/s führt, ist in der Nacht vor dieser Messung durch die Werkzeug-Prüfung gefallen: tools FAIL 1/3, mit dem Vermerk [DECLARED_NOT_DELIVERED] — es meldet Werkzeugfähigkeit an und liefert sie nicht. In derselben Nacht fiel es auch bei Schlussfolgern und Programmieren durch, letzteres mit dem bemerkenswert präzisen Befund OK_model_ran_and_was_wrong.
Eine Einschränkung gehört dazu, weil sie meine erste Fassung dieses Absatzes korrigiert hat: Das Produktivmodell konnte in derselben Nacht nicht gegengeprüft werden — die Prüfung übersprang es an einem Speicher-Tor, das sein eigener laufender Server ausgelöst hatte. Sein letzter bestandener Werkzeugtest stammt von einem früheren Lauf. Ich hatte hier zuerst „besteht 3/3″ geschrieben; die Zeile gehörte einem gleichnamigen Bench-Zwilling, nicht dem Produktivmodell.
Ein Widerspruch bleibt offen und wird hier nicht aufgelöst: Dieselbe Prüfung markierte beim Spitzenreiter auch die Denkkette als FAIL_BROKEN — während dieser Lauf für dasselbe Modell Denkketten von 3135 bis 4593 Zeichen gemessen hat, in drei von drei Aufrufen. Eine der beiden Messungen prüft etwas anderes als die andere. Welche, weiß ich nicht.
Die Wiederholung, die nichts änderte
Am 18. September stand eine kleinere Fassung dieser Tabelle: fünf Modelle. Jede Zelle war unter 39 bis 72 % Fremdlast entstanden — auf denselben Karten liefen weiter ein produktiver Chat-Dienst und die Einbettungen einer Wissensbasis. Grund genug, die Zahlen für verdorben zu halten und alles unter exklusivem Zugriff zu wiederholen.
Das Ergebnis über 30 direkt vergleichbare Zellen: Median-Abweichung +0,0 %, Spanne −5,9 % bis +8,8 %. Kein Modell verschob sich um mehr als ein knappes Zehntel, und die Vorzeichen verteilen sich zufällig.
Die Erklärung, die ich dafür habe, stammt nicht aus diesem Lauf, und das ist ein Unterschied: Ein früherer Nebenläufigkeitstest hatte gezeigt, dass der Modellserver Anfragen an dasselbe Modell seriell abarbeitet — acht gleichzeitige Anfragen kosteten achtmal die Wartezeit bei flachem Durchsatz. Wenn das gilt, hat die eigene Anfrage die Karten ohnehin allein, und die Auslastungsanzeige misst die fremde Anfrage davor, nicht eine gleichzeitige Konkurrenz. Dieser Lauf ist mit der Erklärung verträglich, aber er kann sie nicht belegen: er lief hinter einer Sperre, die Fremdverkehr vollständig entfernt hatte. Man kann Nebenläufigkeit nicht messen, indem man sie abschaltet.
Was Fremdlast sehr wohl kostet
Der erste Anlauf scheiterte, und zwar aufschlussreich. Die Ladezeilen des Servers in jenen vier Minuten:
08:11:44  offloaded 65/65 layers to GPU
08:12:22  offloaded 66/66 layers to GPU
08:13:45  offloaded 65/65 layers to GPU
08:14:07  offloaded 66/66 layers to GPU
08:14:37  offloaded 65/65 layers to GPU
08:15:04  offloaded 66/66 layers to GPU
65 Schichten ist der Kandidat, 66 der Flotten-Standard. Messung und Live-Betrieb warfen sich abwechselnd aus dem Speicher — im Mittel alle 40 Sekunden, die einzelnen Abstände liegen zwischen 22 und 83. Jeder Wechsel ist ein vollständiger Ladevorgang. Ohne das Ladezeit-Tor wäre daraus eine plausible Tabelle geworden, die Ladezeiten misst und „Durchsatz“ darüberschreibt.
Die Anfragerate von außerhalb localhost lag zwischen 05 und 09 Uhr bei 1 bis 13 Anfragen pro Minute. Leerminuten gibt es durchaus — je nach Stunde 21 bis 28 von 60 —, aber keine Lücke, die lang genug wäre, um einen Modellwechsel und eine Messung dazwischenzulegen. Fremdlast verdirbt also nicht die Zahl; sie verhindert, dass man überhaupt eine bekommt.
Die Zahlen
Dekodierung in Token pro Sekunde, Median über fünf Läufe je Zelle (drei bei eingeschalteter Denkkette). Belegung über beide Karten mit nvidia-smi gemessen, nicht aus der Selbstauskunft des Servers übernommen — warum, steht weiter unten.
| Modell | Datei | Belegt | kurz ~41 Tok |
mittel 1079–1334 |
lang 4373–5464 |
Prefill lang |
Laden |
|---|---|---|---|---|---|---|---|
| Nemotron 3.5 Lightning 30B-A3B (Q4_0) | 17,6 | 27,65 | 145,3 | 143,7 | 138,6 | 5875 | 14,8 s |
| Qwen3.8 35B-A3B Distill (Q4_K_M) | 21,6 | 29,12 | 114,3 | Absturz | 118,4 | 4732 | 39,3 s |
| Ornith 1.5 35B-A3B (Q4_K_M) | 21,5 | 29,12 | 113,4 | Absturz | 118,2 | 4668 | 17,0 s |
| Qwen3 Coder 30B (Q4_K_M) | 17,3 | 35,62 | 107,1 | 116,6 | 96,1 | 7766* | 32,6 s |
| Qwen3.8 35B-A3B Distill (IQ2_M) | 12,5 | 24,59 | 105,0 | 112,8 | 107,3 | 4026 | 26,1 s |
| Qwen3.6 35B-A3B MTP (Q4_K_M) | 21,4 | 32,48 | 70,0 | Absturz | 77,2 | 3193 | 20,3 s |
| Qwen3.8 27B (Q4_K_M) — im Einsatz | 16,5 | 32,39 | 41,1 | 45,1 | 50,0 | 1141 | 37,7 s |
| Qwen3.8 27B abliteriert (Q6_K) | 20,9 | 33,09 | 31,0 | 30,8 | 30,1 | 1633 | 38,4 s |
| 27B-Neubau (Q8_0) | 28,6 | 39,96 | 25,4 | 24,9 | 24,6 | 1883 | 49,4 s |
* Die Promptlängen unterscheiden sich je Modell, weil jedes den identischen Fülltext anders zerlegt. Der Coder liest im Langfall 5464 statt 4373 Token — seine 7766 Token/s sind also auf einem 25 % längeren Prompt gemessen und nicht eins zu eins mit den übrigen Zeilen vergleichbar.
Dicht gegen Mixture-of-Experts ist die ganze Geschichte. Die drei langsamsten Plätze belegen exakt die drei dichten 27B-Modelle — 41,1, 31,0 und 25,4 Token/s. Jedes MoE im Feld liefert mindestens 70. Das ist keine knappe Führung, sondern eine andere Größenordnung, und es hält über alle drei Promptlängen.
Ein Vorbehalt, der weiter unten seine Erklärung bekommt: Die beiden Modelle, die mit spekulativer Dekodierung laufen, sind ausgerechnet die Anker dieses Vergleichs — das schnellste dichte Modell (41,1) und das langsamste MoE (70,0). Beide sind dadurch eher schneller gemessen als ohne. Der Abstand zwischen dicht und MoE ist also, wenn überhaupt, unterschätzt.
Mehr Bits kosten hier doppelt — mit einer Einschränkung. Die drei dichten 27B-Zeilen in Q4_K_M, Q6_K und Q8_0 liefern 41,1 → 31,0 → 25,4 Token/s bei 32,39 → 33,09 → 39,96 GiB. Das sieht nach einer sauberen Quantisierungsleiter aus, ist aber keine: es sind drei verschiedene Modelle. Die Q4_K_M-Zeile trägt zusätzlich einen Bildturm und läuft als einzige der drei mit spekulativer Dekodierung, die Q6_K-Zeile hat veränderte Gewichte, die Q8_0-Zeile ist ein Fremdnachbau. Die Richtung ist plausibel, ein kontrolliertes Experiment ist es nicht.
Die Q8_0-Variante ist das langsamste Modell des Feldes, belegt am meisten und lädt am längsten — auf jeder Dimension die schlechteste Wahl außer beim Prefill, wo sie mit 1883 Token/s immerhin Siebter von neun wird.
Prefill und Dekodierung ranken verschieden. Der Coder liest am schnellsten ein, dekodiert aber langsamer als Nemotron — und bei langem Prompt langsamer als bei mittlerem. Eine einzige Zahl „Token/s“ verdeckt diesen Unterschied.
Die Erklärung, die starb und wieder auferstand
Bei sechs der neun Modelle ändert die eingeschaltete Denkkette den Durchsatz kaum; die Abweichungen laufen von −1,6 bis +6,3 %. Ein siebtes, der Coder, ist gar nicht behandelt worden: er hat in allen drei Denkketten-Zellen null Zeichen Denkkette erzeugt — der Schalter greift bei ihm nicht. Zwei fallen heraus:
- das Produktivmodell: 41,1 → 48,7 · 45,1 → 55,8 · 50,0 → 57,1 (+14 bis +24 %)
- der MTP-Build der Vorgängergeneration: 70,0 → 85,3 und 77,2 → 84,9 (+10 bis +22 %; die mittlere Zelle fehlt, weil sie abstürzt)
Beim Vergleich der Speicherzahlen fiel auf, dass die Differenz zwischen der Selbstauskunft des Servers und der Messung an der Karte nicht konstant ist: bei sieben Modellen liegt sie zwischen 0,60 und 1,46 GiB, beim Produktivmodell bei 7,87 und beim MTP-Build bei 5,45 GiB. Genau die zwei Modelle mit mehreren nicht zugeordneten Gigabyte sind genau die zwei mit dem Geschwindigkeitsgewinn. Ein mitgeladenes Entwurfsmodell für spekulative Dekodierung würde beides auf einen Schlag erklären.
Ich habe das Protokoll durchsucht, zwei Zeilen gefunden — no implementations specified for speculative decoding und draft: 0.000 MiB — und die Erklärung für widerlegt erklärt. Der Absatz stand schon geschrieben.
Beide Zeilen stammten aus dem Ladevorgang eines anderen Modells. Mein Zeitfenster umfasste mehrere Ladungen, und ich hatte nicht geprüft, zu welcher die Treffer gehören. Für die zwei fraglichen Modelle steht im Protokoll das Gegenteil:
--spec-type draft-mtp --spec-draft-n-max 4 --spec-draft-backend-sampling
[spec] estimated memory usage of MTP context is 2250.06 MiB
draft acceptance = 0.57143 (4 accepted / 7 generated), mean len = 2.33
Spekulative Dekodierung läuft bei genau diesen beiden Modellen und bei keinem anderen der neun — beim Produktivmodell mit einer Entwurfstiefe von 4, beim MTP-Build mit 2. Über den Lauf hinweg gemessene Annahmequoten: 29 bis 67 % beim Produktivmodell, 56 bis 81 % beim MTP-Build. Und die Lücke hat damit Namen: 4,24 GiB Rechenpuffer (2169 MiB je Karte), 2,20 GiB Entwurfskontext und 1,13 GiB Bildturm — drei Posten, die die Laufzeitabfrage allesamt nicht ausweist. Sie summieren sich auf 7,57 der 7,87 GiB. Dass es so genau aufgeht, überschätze ich nicht: das Protokoll gibt zwei der drei als estimated aus, und ob sich die Posten überschneiden, sagt es nicht.
Die ursprüngliche Vermutung war richtig. Was falsch war, war meine Widerlegung.
Wo die Selbstauskunft des Servers danebenliegt
Für das Produktivmodell meldet die Laufzeitabfrage 24,52 GiB, die Karten zeigen 32,39 GiB. Die Differenz besteht aus dem Rechenpuffer (2169 MiB je Karte, zusammen 4,24 GiB), dem Entwurfskontext der spekulativen Dekodierung (2250 MiB) und dem Bildturm (1161 MiB). Keines davon taucht in der Abfrage auf.
Praktische Folge: Wer VRAM plant, fragt die Karte, nicht den Dienst. Ein pauschaler Aufschlag hilft nicht, weil der Fehler zwischen 0,60 und 7,87 GiB schwankt — je nachdem, welche dieser Zusatzstücke ein Modell mitbringt.
Der Rechenpuffer wird beim Aufteilen doppelt bezahlt
Ein Hinweis zur Messbasis vorweg: Dieser Abschnitt rechnet mit den Posten aus dem Serverprotokoll, nicht mit der nvidia-smi-Messung der Tabelle. Die beiden Basen liegen rund anderthalb Gigabyte auseinander, weil die Karte auch Dinge sieht, die das Protokoll nicht als Posten ausweist.
Bei vollem Kontext ist der auffälligste Posten weder das Gewicht noch der Kontext-Zwischenspeicher, sondern der Rechenpuffer — und der fällt je Karte an. Für das kleinste Modell im Feld: Gewichte 10900 MiB, Kontext-Zwischenspeicher 2720 MiB, Rechenpuffer zweimal 4881 MiB.
Der Rechenpuffer ist damit fast so groß wie die Gewichte, und die Hälfte davon existiert nur, weil das Modell geteilt läuft. Bei diesem Modell ist der Kontext-Zwischenspeicher der kleinste Posten — alle neun laufen mit --cache-type-k q8_0 --cache-type-v q8_0, was ihn drückt. Für die drei dichten 27B-Zeilen gilt das nicht; dort ist er der zweitgrößte.
Das korrigiert eine Aussage, die in meiner ersten Fassung als Überschrift stand: „Bei vollem Kontext passt kein einziges Modell auf eine Karte.“ Sie verglich eine Zwei-Karten-Summe mit einer Ein-Karten-Grenze. Ob eines der Modelle auf eine Karte passt, beantwortet diese Messung nicht — dafür müsste man es mit einer Karte laden, und das habe ich nicht getan. Nachrechnen hilft nur begrenzt: in diesem Aufbau ist die zweite Karte ohnehin nicht leer, sie trägt das Einbettungsmodell.
Drei Modelle verlieren reproduzierbar eine Zelle
Die drei Q4_K_M-Builds der 35B-A3B-Architektur scheitern in der Zelle „mittel“ jeweils fünf von fünf Mal. Nicht am selben Fehler: zwei sterben an CUDA error: an internal operation failed, der MTP-Build an CUDA error: an illegal memory access was encountered. Gleiche Zelle, gleiche Quote, verschiedene Ursache — was die Vermutung „ein Absturz, eine Ursache“ schwächt. Dieselben Modelle liefern bei kürzerem und bei längerem Prompt sauber ab.
Der Vergleich, den dieses Feld hergibt: derselbe Basismodell-Distill in IQ2_M läuft alle sechs Zellen vollständig durch — fünf von fünf ohne Denkkette, drei von drei mit. Gleiche Architektur, gleiche Expertenzahl, gleiche deklarierte Kontextlänge, anderer Quantisierungsgrad, kein Absturz.
Die naheliegende Erklärung wären die MTP-Tensoren, die der Lader in zwei der drei abstürzenden Builds als unbenutzt meldet — der dritte, der MTP-Build selbst, benutzt sie. Auch die trägt nicht: derselbe Metadaten-Eintrag steht im funktionierenden IQ2_M-Build. Bleibt ein reproduzierbarer Absturz mit sauberem Gegenbeleg und ohne Ursache.
Sechs Tore, und was davon wirklich ausgelöst hat
Ein Testaufbau, der nur bestehen kann, prüft nichts. Jede Messung lief gegen sechs Bedingungen: Ladezeit ≥ 1 s, Abbruch wegen Längenbegrenzung, leere Antwort, nicht vollständig auf der Karte, Einbettungsmodell antwortet nicht, Fremdlast über der Schwelle.
Ausgelöst hat davon genau eines: das Ladezeit-Tor, in drei Zellen. Drei weitere Zellen fielen schon vorher aus, über den Ausnahmepfad der Harness, weil der Server abgestürzt war — das ist kein Tor, sondern der Weg daran vorbei. Ich hatte in der ersten Fassung „drei Tore“ geschrieben und dabei Ausnahmen mit Toren verwechselt. Die anderen fünf Tore haben in diesem Lauf nie gefeuert; ob sie funktionieren, ist damit unbewiesen.
Drei Details, die je einen halben Tag gekostet haben:
Durchsatz wird nie aus dem Protokoll gelesen. Das naheliegende Suchmuster für die Auswertungszeit trifft auch die Zeile für die Prompt-Auswertung und meldete für ein Modell 38,8 Token/s, wo der Schnittstellenwert 109,8 misst. Gerechnet wird aus den Zählerfeldern der Antwort.
Jeder Prompt trägt eine Zufallskennung. Ein wiederholter Prompt trifft den Zwischenspeicher und treibt die gemessene Prompt-Geschwindigkeit um ein Vielfaches hoch.
Eine Sperre, die man setzt und nicht nachmisst, ist eine Annahme. Für den exklusiven Zugriff wurden zuerst drei bekannte Dienste ausgesperrt. Die Kontrolle schlug an: die Anfragerate fiel nicht. Ich hielt das damals für einen vierten, unbekannten Dienst. Was die Aufzeichnung tatsächlich zeigt, ist schwächer und unangenehmer: die durchkommenden Anfragen trugen eine Adresse, die bereits auf der Sperrliste stand. Ob dort ein zweiter Dienst auf demselben Rechner saß oder die Sperre selbst nicht griff, habe ich nicht auseinandergehalten. Die Lehre bleibt dieselbe, nur strenger: eine Aufzählung von Clients ist nur so gut wie die letzte Bestandsaufnahme — und eine Sperre, deren Wirkung man nicht je Adresse nachmisst, ist keine. Die Regel sperrt jetzt alles Nicht-Lokale.
Eine Einschränkung dazu, die zur Ehrlichkeit gehört: Zwei der neun Zeilen — das Produktivmodell und die abliterierte Variante — stammen aus dem ersten Anlauf und liefen noch unter der alten, unvollständigen Drei-Adressen-Sperre. Ihre gemessene Fremdlast blieb bei höchstens 10 %, es ist also keine Verunreinigung sichtbar; unter der endgültigen Regel wiederholt wurden sie trotzdem nicht.
Was ich daraus mitnehme
Die Wiederholung war richtig, nur nicht aus dem Grund, aus dem ich sie angesetzt habe. Sie hat die alten Zahlen nicht korrigiert, sondern bestätigt — und damit aus einer Messung mit Sternchen eine belastbare gemacht.
Der lehrreichste Teil steht weiter oben und ist mir selbst passiert: Eine Erklärung, die zu gut klang, habe ich mit zwei Protokollzeilen erschlagen, ohne zu prüfen, zu welchem Modell sie gehören. Ein Zeitfenster-Suchlauf über mehrere Ladevorgänge liefert Treffer, die aussehen wie eine Antwort. Die Erklärung war richtig; meine Widerlegung war ein Flüchtigkeitsfehler mit Protokollzitat. Skepsis gegen die eigene Vermutung ist gut — Skepsis, die selbst ungeprüft bleibt, ist nur schneller falsch.
Und die teuerste Lehre ist keine über Modelle: Ich habe zwei Stunden damit verbracht, eine Verunreinigung zu beseitigen, die es nicht gab, weil ich eine Auslastungsanzeige für ein Maß an Konkurrenz gehalten habe. Die Zahl war echt. Meine Deutung war es nicht.
Der Wechsel des Produktivmodells steht trotzdem nicht an, und das liegt nicht am Durchsatz: Der schnellste Kandidat fällt bei Werkzeugaufrufen, beim Schlussfolgern und beim Programmieren durch. Was hier gemessen ist, ist eine Dimension von mehreren — und nicht die wichtigste. 145 gegen 41 Token pro Sekunde ist ein starkes Argument; ein Grund wird daraus erst mit einer Qualitätsmessung auf den Aufgaben, die tatsächlich anfallen. Die ist der nächste Text.