Sieben Teile lang hat diese Serie gemessen, was lokale Modelle antworten, wenn man sie fragt. Dieser Teil handelt von der Frage davor, die ich nie gestellt hatte: Antwortet überhaupt das Modell, das in der Konfiguration steht? Die Frage klingt zu banal zum Messen. Dann habe ich an einem einzigen Tag nachgesehen, worauf die Dienste in meinem Bestand tatsächlich zeigen.
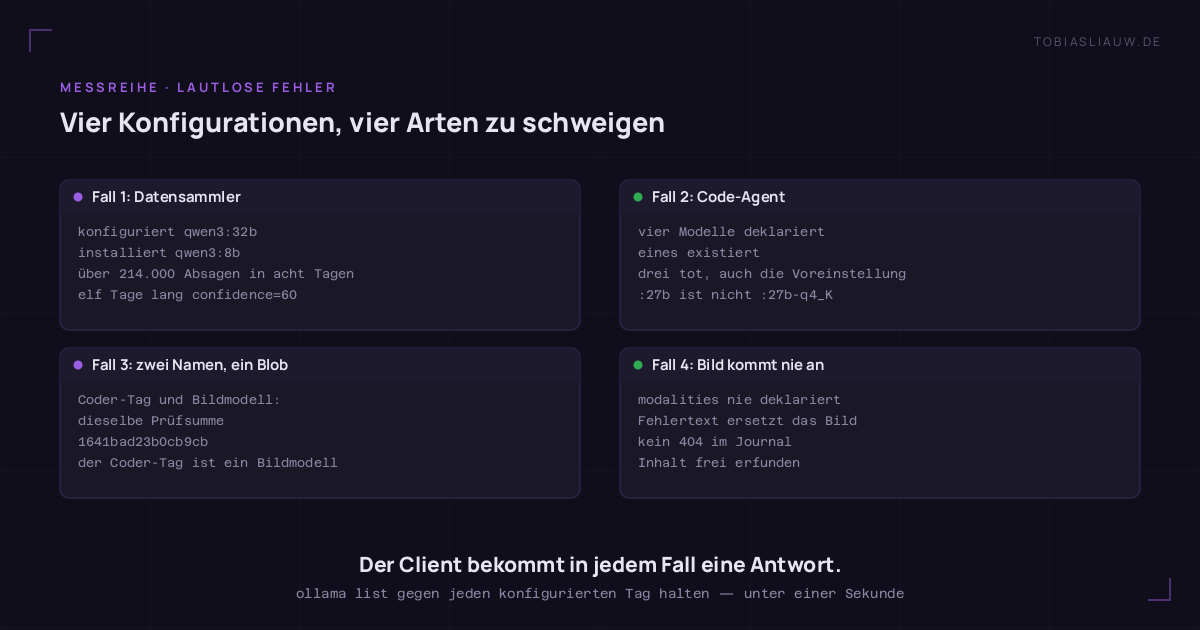
Das Ergebnis in einem Satz: Vier Konfigurationen, die auf denselben Modellserver zeigen, benannten Modelle, die es dort nicht gibt oder die etwas anderes sind, als ihr Name behauptet — und alle vier scheiterten lautlos, ohne dass je eine Fehlermeldung einen Menschen erreicht hätte.
Der lauteste der vier Fälle hat elf Tage lang im Mittel über 40.000 Anfragen täglich abgesetzt, jede einzelne wurde abgewiesen — und aufgefallen ist es nur, weil jemand aus einem ganz anderen Grund die Zugriffe auf den Modellserver zählte.
Die Zählregel, bevor die Fälle kommen
Wie in jedem Teil dieser Serie stand die Regel fest, bevor gezählt wurde. Ein Fall kommt nur auf die Liste, wenn drei Bedingungen zugleich erfüllt sind:
- Eine aktiv benutzte Konfigurationszeile benennt einen Modell-Tag, der auf dem Server nicht existiert — oder der nachweislich etwas anderes ist, als sein Name sagt.
- Der Dienst hat trotzdem weiter Antworten geliefert.
- Kein Fehler hat je einen Menschen erreicht.
Auskommentierte Zeilen und Anleitungstexte zählen nicht. Zwei Kandidaten sind an genau dieser Regel ausgeschieden: dort stand der tote Modellname nur in Kommentaren oder in einer Markdown-Anleitung, aktiv war jeweils ein existierendes Modell. Und eine Einschränkung vorweg, weil gleich Messwerte kommen: für diesen Teil stand nur ein Host zur Verfügung. Die byteidentische Zweitmessung über zwei Rechner, das stärkste Belegmittel dieser Serie, gibt es hier nicht — alle Zahlen stammen von einer Maschine und ihrem Journal.
Fall 1: 43.000 Absagen am Tag — ein Datensammler
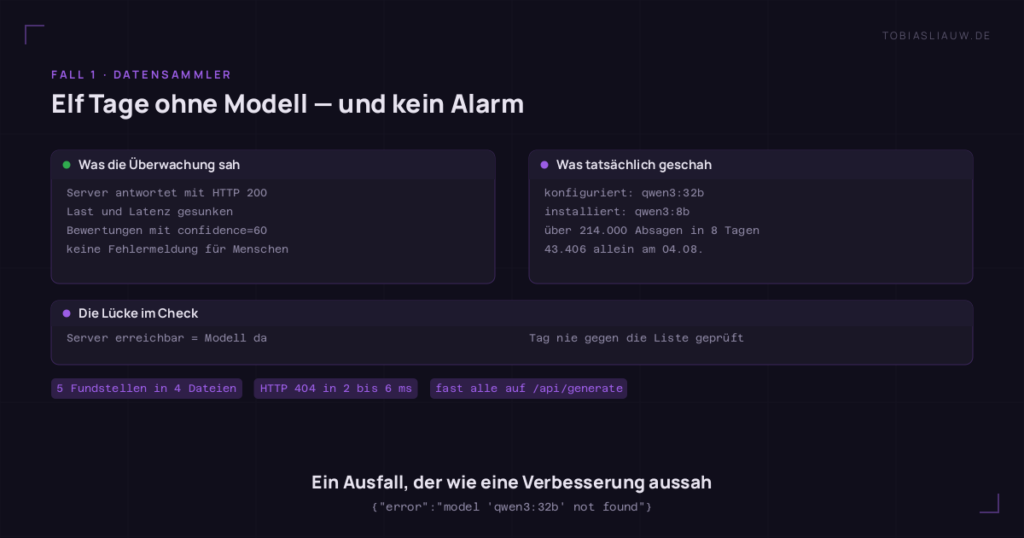
Ein Datensammler, der Marktdaten einsammelt und von einem Modell bewerten lässt, hatte an fünf Fundstellen in vier Dateien den Tag qwen3:32b konfiguriert. Installiert war qwen3:8b. Die Antwort des Servers auf jede dieser Anfragen, wörtlich und live reproduziert:
{"error":"model 'qwen3:32b' not found"}
HTTP 404, erledigt in zwei bis sechs Millisekunden. Das Journal des Modellservers reichte noch acht Tage zurück und zählt für diesen Zeitraum über 214.000 abgewiesene Anfragen:
| Tag | abgewiesene Anfragen |
|---|---|
| 30.07. | 576 |
| 31.07. | 30.211 |
| 01.08. | 50.893 |
| 02.08. | 49.324 |
| 03.08. | 32.790 |
| 04.08. | 43.406 |
| 05.08. | 6.977 (Dienst im Lauf des Tages gestoppt) |
| 06.08. | 52 |
Am 04.08. kamen 43.344 der 43.406 Absagen von der Maschine, auf der der Datensammler läuft, fast alle auf /api/generate. Der Fall ist damit eindeutig zugeordnet.
Warum elf Tage lang niemand etwas merkte, steht im Code, an zwei Stellen. Erstens prüft die Verfügbarkeitsfunktion des Dienstes nur, ob der Server die Modell-Liste mit HTTP 200 ausliefert — sie vergleicht den eigenen konfigurierten Tag nicht mit dieser Liste. Der Server war da, also galt das Modell als da. Zweitens fängt der Dienst die 404 ab, schreibt eine Warnung in sein eigenes Log und fällt auf einen Stichwortabgleich zurück, der ein fest verdrahtetes confidence=60 liefert. Der Dienst produzierte also weiter Bewertungen mit einer Kennzahl, die wie ein Messwert aussieht — nur eben elf Tage lang ohne Modell.
Und der Ausfall hat die Maschine nicht einmal belastet: eine Absage in zwei bis sechs Millisekunden ist billiger als jede echte Inferenz. Wer auf Last oder Latenz schaute, sah in diesen elf Tagen eine Verbesserung.
Fall 2: vier Modelle deklariert, eines existiert — ein Code-Agent
Die Konfiguration eines Code-Agenten deklarierte vier Modelle. Der Abgleich gegen die installierten Tags:
| deklariert | Befund |
|---|---|
qwen3-coder:latest | 404 — existiert nicht |
huihui_ai/Qwen3.6-abliterated:27b | 404 — installiert ist :27b-q4_K |
qwen3:14b | 404 — installiert ist qwen3:8b |
devstral:24b | existiert |
Drei von vier tot, darunter die Voreinstellung — das Modell, das beim Start ausgewählt ist. Der zweite Eintrag ist der lehrreichste, weil er eine Regel aus den Grundregeln dieser Serie in neuer Form bestätigt: kein Modellname ohne Prüfung der Variante. :27b und :27b-q4_K sehen aus wie dasselbe Modell in zwei Schreibweisen. Für den Server sind es zwei verschiedene Tags, und einen davon gibt es nicht.
Fall 3: zwei Namen, ein Blob
Eine Anwendung mit getrennt konfiguriertem Text- und Bildmodell zeigte mit ihrer Textmodell-Variablen auf huihui_ai/qwen3-coder-abliterated:30b-a3b-instruct-q4_K_M. Dieser Tag existiert sogar — nach der Zählregel wäre der Fall beinahe durchgerutscht. Aber der Tag und das Bildmodell huihui_ai/qwen3-vl-abliterated:30b-a3b-instruct-q4_K_M tragen dieselbe Prüfsumme: 1641bad23b0cb9cb. Zwei Namen, ein Modell.
Gegenprobe, damit das kein Artefakt der Messung ist: die Thinking-Fassung desselben Anbieters trägt eine andere Prüfsumme (e89241bfa4109e24) — gleiche Prüfsummen entstehen hier also nicht von selbst. Und die Modellauskunft des Servers sagt über den „Coder“-Tag: Fähigkeiten completion, vision, tools; ein Mixture-of-Experts-Bildmodell mit 31 Milliarden Parametern. Das Coder-Modell dieser Anwendung ist ein Bildmodell mit falschem Etikett. Ein Coder-Modell gab es im ganzen Bestand nicht.
Besonders bezeichnend: ein Wächterprozess, der das „richtige“ Modell im Grafikspeicher halten soll, hat seit dem 17.07. 119-mal nachgepinnt und dabei am 27.07. binnen 33 Minuten den gepinnten Namen vom Coder-Tag auf den Bild-Tag gewechselt. Am geladenen Modell änderte sich dabei: nichts. Der Wächter bewachte ein Etikett.
Fall 4: das Modell, das nie ein Bild sah
Der Code-Agent aus Fall 2 hat noch einen zweiten, leiseren Defekt. In seiner Konfiguration fehlt die Deklaration, welche Eingabearten ein Modell versteht (modalities). Die Folge, am lebenden System geprüft: hängt man einem Prompt ein Bild an, ersetzt der Agent das Bild stillschweigend durch einen Fehlertext und schickt diesen Text an das Modell. Das Modell sieht nie ein Pixel. Es antwortet trotzdem — flüssig, grammatisch, ohne jede Kennzeichnung, dass es auf einen Platzhaltertext statt auf ein Bild reagiert.
Das ist die gefährlichste Variante der vier, weil hier nicht einmal ein 404 im Journal steht. Anfrage gültig, Antwort gültig, Inhalt — bezogen auf das Bild, das nie ankam — frei erfunden.
Warum alle vier lautlos sind
Vier Konfigurationen, vier verschiedene Dienste, vier verschiedene Mechanismen — und dieselbe Struktur: der Client bekommt in jedem Fall eine Antwort. Einen Fallback mit fester Kennzahl (Fall 1), einen sofortigen Fehler, den kein Mensch liest (Fall 2), ein falsches, aber funktionierendes Modell (Fall 3), einen Fehlertext als Bildersatz (Fall 4). Eine HTTP-API kennt kein Schweigen. Der Unterschied zwischen „das konfigurierte Modell hat geantwortet“ und „irgendetwas hat geantwortet“ steht in keinem Statuscode — den muss der Client selbst prüfen, und keiner der vier tat es.
Deshalb halte ich das für eine Fehlerklasse und nicht für vier Pannen. Ein toter Modellname erzeugt kein Symptom: keine Last, keine Latenz, keine Fehlerseite. Er erzeugt nur Antworten, die etwas anderes sind, als sie zu sein behaupten. Das Etikett wird beim Anlegen der Konfiguration einmal gelesen und danach nie wieder mit dem Bestand verglichen — und jeder Bestand ändert sich.
Der Preis der Gegenmaßnahme
Die Prüfung, die alle vier Fälle gefunden hätte, ist eine Zeile: die Ausgabe von ollama list gegen jeden konfigurierten Tag halten. Sie kostet unter einer Sekunde und keine GPU-Zeit. Auf der anderen Seite der Rechnung stehen allein in Fall 1 über 214.000 Fehlanfragen in acht Tagen und ein Dienst, der elf Tage lang erfundene Kennzahlen lieferte. Das ist die günstigste Kosten-Nutzen-Rechnung, die in dieser Serie bisher vorkam.
Zwei Ergänzungen für die Fälle, die der Namensabgleich nicht fängt: Für Fall 3 muss man zusätzlich die Prüfsummen vergleichen — zwei Tags mit derselben Prüfsumme sind ein Modell, egal was die Namen sagen. Für Fall 4 hilft nur die Grundregel dieser Serie: einmal ein Bild durchschicken und die Antwort lesen, nicht die Kennzahl.
Der eigene Fehler
Er kam prompt. In derselben Woche hat sich mein eigener nächtlicher Prüflauf selbst in diese Liste eingetragen. Der Lauf brauchte 21 Sekunden statt Stunden, meldete 17 von 17 Modellen als „übersprungen (nicht installiert)“ und beendete sich dreimal mit Rückgabewert 0. Die Kette dahinter: Das Kommandozeilenwerkzeug stürzt ab, wenn die Umgebungsvariable HOME fehlt; die Container-Ausführung reichte eine leere Umgebung durch; ein 2>/dev/null in meinem Skript verschluckte genau diese Absturzmeldung; und eine leere Modellliste wurde als „nichts installiert“ gelesen statt als Fehler.
Repariert ist es dreifach: HOME wird gesetzt, stderr wird nicht mehr verworfen, und eine leere Modellliste bricht den Lauf hart ab, statt ihn leer durchlaufen zu lassen. Aber der Punkt ist ein anderer: ich habe in dieser Serie mehrfach geschrieben, dass eine auffällig runde Null verdächtig ist und dass man Ausgaben lesen muss statt Kennzahlen. 17 von 17 „nicht installiert“ in 21 Sekunden ist eine sehr runde Null, und mein Skript hat sie mit Rückgabewert 0 quittiert. Die Fehlerklasse aus diesem Beitrag unterscheidet nicht zwischen fremden Diensten und den eigenen Prüfständen.
Was das nicht zeigt
- Nicht, dass es nur vier Fälle sind. Eine Volltextsuche nach Modellnamen über die übrige Konfigurationslandschaft lieferte über 3.000 Fundzeilen; zwei große Bestände davon sind nicht durchgearbeitet. Vier ist die belegte Untergrenze, keine Bilanz.
- Nicht, dass der Modellserver etwas falsch macht. Ollama antwortet auf einen unbekannten Tag korrekt und schnell mit 404. Die Stille entsteht ausnahmslos auf der Client-Seite.
- Nicht, dass Fallbacks falsch sind. Ein Fallback, der sich als Fallback zu erkennen gibt, wäre in Fall 1 der richtige Umgang gewesen. Falsch ist der Fallback, der sich als Messwert ausgibt.
- Nicht, dass das überall so aussieht. Vier Fälle an einem Modellserver mit 24 Tags und einer Handvoll Konsumenten — über andere Umgebungen sagt das nichts. Es sagt, dass die Prüfung eine Zeile kostet und sich hier viermal gelohnt hätte.
Der Aufbau
- Ein Modellserver: Ollama 0.32.5, zwei RTX 3090, zum Messzeitpunkt 24 installierte Tags.
- Die Zahlen zu den Fehlanfragen stammen aus dem Journal des Modellservers, je Tag gezählt; die zitierte 404-Antwort wurde per direktem API-Aufruf reproduziert, nicht aus Logs geschlossen.
- Prüfsummen und Fähigkeiten je Tag kommen aus der Modellauskunft des Servers, nicht aus Dateinamen.
- Nur ein Host verfügbar. Die Serie belegt Behauptungen sonst bevorzugt über zwei Rechner mit byteidentischen Ausgaben; eine zweite Maschine mit gleichem Modellbestand stand für diesen Teil nicht zur Verfügung. Die Zahlen sind deshalb einfach belegt, nicht doppelt.
Was als Nächstes gemessen wird: was Abliteration einem Modell tatsächlich nimmt — ein Prüfstand mit vorab festgelegten Szenarien, auf denselben Karten.