Karte: „1 PC. Eigenes KI-Team. 0 Abo.“
Anders gesagt: Aus einem einzelnen Arbeitsrechner wird ein Büro. Ein lokal laufendes Sprachmodell wird zum Gehirn, ein Agent-Harness zur Arbeitskraft, Skills und Notizen zum Betriebswissen. Dieser Artikel erklärt das Modell „1 KI-Mitarbeiter“ an unserem Beispiel, zeigt fünf Bauteile und gibt den 60-Minuten-Weg für eigene Hardware.
1. Was ein KI-Mitarbeiter ist
Zuletzt kursiert ein Template in drei Rollen: ein großes Modell als Berater (liest riesige Kontexte, lenkt den Plan), ein mittleres als Session-Lead (führt Edits, testet), kleine als Schwarm (scannen Repos, holen Docs). Dasselbe bauen wir mit lokalen Modellen: flash-next (SC117, 262k Kontext) als Berater, 27b als Lead, nimble plus ein 7b auf einer alten RTX 2080 Ti als Schwarm. Drei Hirne, drei Maschinen, 0 Cloud.
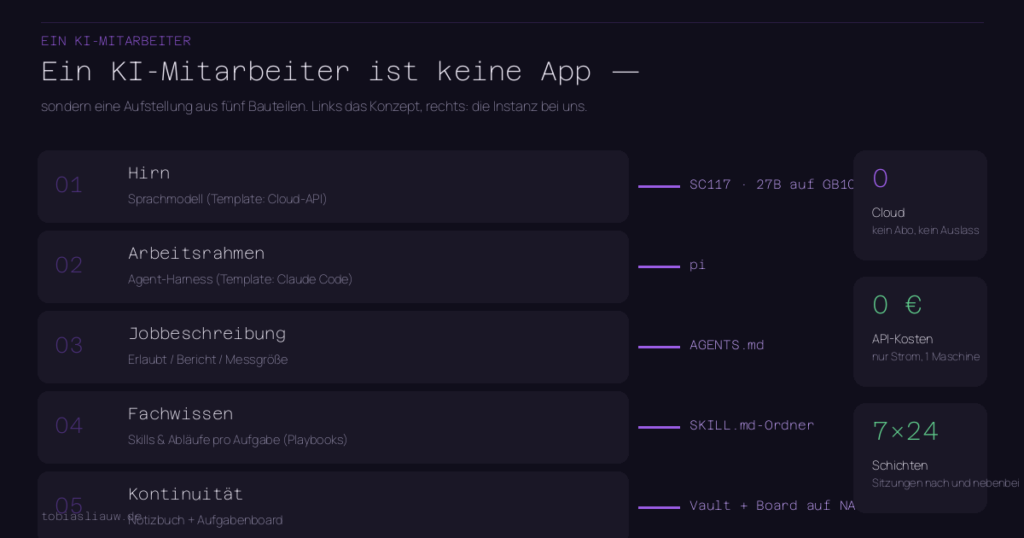
Ein KI-Mitarbeiter ist keine App, sondern eine Aufstellung aus fünf Bauteilen:
- Hirn — ein Sprachmodell (Template: Cloud-API; bei uns: ein Modell auf der eigenen Karte).
- Arbeitsrahmen — ein Agent-Harness, das Denken, Handeln und Beobachten in einen Kreislauf legt (Template: Claude Code; bei uns: pi).
- Jobbeschreibung — eine Datei, die sagt, was der Mitarbeiter darf, wie er berichtet, woran er gemessen wird (bei uns: AGENTS.md).
- Fachwissen — Skills und Abläufe, die er bei jeder Aufgabe lädt (Template: Playbooks; bei uns: SKILL.md-Ordner).
- Kontinuität — ein Notizbuch (Vault) und ein Aufgabenboard, damit Arbeit von Sitzung zu Sitzung trägt.
Baut man die fünf zusammen, „wacht“ der Mitarbeiter auf: Er liest seine Jobbeschreibung, sieht, was zu tun ist, arbeitet und hinterlässt Notizen. Genau so ein Mitarbeiter läuft bei uns — mehrere, nacheinander und parallel, gegen 0 € API-Kosten.
2. Unser Hirn: der GB10
Die Hardware ist ein NVIDIA DGX Spark (GB10): ein Arbeitsstationssystem mit 124,5 GiB gemeinsamem Speicher und 175 GB/s Speicherbandbreite. Das Besondere ist nicht die Grö&szl;e, sondern die gemeinsame Adresse: Modell, Kontext und KV-Cache sitzen in einem Speicher, den weder CPU noch GPU teilen müssen.
Darauf läuft unser Produktionsmodell SC117 (27B-Klasse) in einem llama.cpp-Server mit 262.144 Token Kontext. Unsere Benchmarks (13 dokumentierte Läufe, veröffentlicht unter bench.tobiasliauw.de) zeigen:
| Modell (GGUF) | Dekodiergeschwindigkeit @ 32k | Stellung |
|---|---|---|
| HuiHui (27B) | ≈ 33,6 tok/s | schnellster Kandidat |
| SC117 (27B) | ≈ 26,3 tok/s | Produktionsmodell |
| Q4Mix | ≈ 24,3 tok/s | Kompaktkandidat |
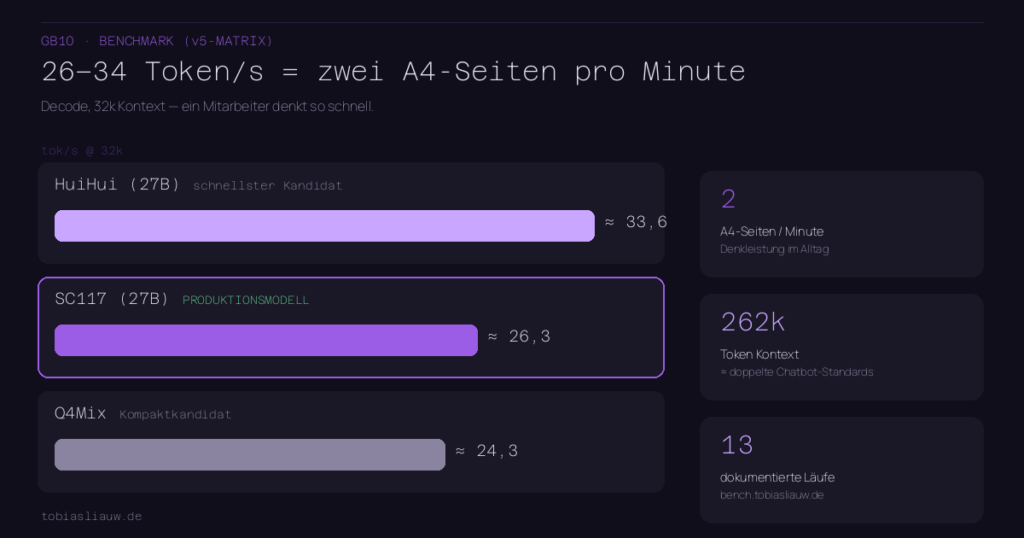
26–34 Token/s heißt im Alltag: Ein Mitarbeiter, der in einer Minute zwei A4-Seiten Text denkt — schnell genug, um zu denken, langsam genug, um es zu genießen. Ein Cloud-Modell ist stärker; es weiß aber auch, worüber Sie denken.
3. Fünf Bauteile, konkret
Hirn: llama-server (llama.cpp, 27B GGUF, CUDA) auf Port 8080. Betriebsregel: Das Produktionsmodell wird nie außer Betrieb gesetzt; Tests laufen im Fensterrahmen mit automatischer Wiederherstellung.
Arbeitsrahmen (pi): Der Agent liest Dateien, führt Bash aus, bearbeitet Code, schreibt neue Dateien. Jede Sitzung bekommt eine AGENTS.md mit harten Regeln (z. B. „Fließtext nie verdichten“, „Board: lesen → bearbeiten → schreiben → zurücklesen“).
Jobbeschreibung (AGENTS.md): Beispiele aus unserer —
- „Benchläufe laufen live auf GB10 in
~/gb10-bench-tetris/runs/— nicht auf Atlas.“ - „Nur im Betriebsfenster stoppen; Wiederherstellung über
restore.sh; harte Grenze 22:00 CEST.“ - „Vault-Index immer mit bge-m3 (1024 dims).“
Fachwissen (Skills): z. B. ein Second-Brain-Skill, der 27 Ordner automatisch zusammenfasst, oder ein Design-Skill-Kit für jedes Frontend-Redesign.
Kontinuität (Board + Vault): Unser Aufgabenboard ist eine Markdown-Datei auf dem NAS. 499 Kilobyte an Verwirrung reduzierte eine Sitzung auf 243 Kilobyte Wahrheit (63 doppelte Einträge entfernt, 31 veraltete abgelegt), mit Prüfsumme verifiziert. Das war kein Backup — das war Aufräumen.
4. 60 Minuten: dein Mitarbeiter
Voraussetzungen: Ein Rechner mit ≥ 64 GB gemeinsamem Speicher (ideal 128 GB, z. B. GB10 oder Strix-Halo) oder eine GPU mit ≥ 24 GB VRAM. Linux. 60 Minuten.
- Hirn starten: Ollama oder llama.cpp plus ein 27B-Q4/Q6-GGUF-Modell. Ziel:
curl http://localhost:8080/v1/modelsantwortet. - Arbeitsrahmen starten:
pi(oder eine vergleichbare Agent-Instanz) gegen die lokale OpenAI-kompatible API zeigen. - Jobbeschreibung:
AGENTS.mdmit den harten Regeln schreiben (was darfst du, was nie, wo liegen die Dateien, wie schreibst du Reports). - Ein Fachwissen: einen einzigen Skill mit
SKILL.mdanlegen (z. B. „tägliches Dashboard“). - Kontinuität: ein
board.mdund einen~/vault/-Ordner. In der AGENTS.md: „Am Sitzungsende: Board-Status aktualisieren.“ - Auftrag: „Lies dein Board, finde die offene Aufgabe, führe sie aus, schreibe den Report, aktualisiere das Board.“
Das ist der Mitarbeiter. Alles Weitere (mehr Mitarbeiter, mehr Fachwissen, eigene Modelle, Benchmark-Suites) ist das, was wir in den letzten Wochen gebaut haben.
5. Ehrliche Grenzen
- Geschwindigkeit/Qualität: 27B-lokal << Frontier-Cloud. Für Betriebsarbeit, Code, Recherche-Entwürfe: völlig ausreichend. Für Spitzenkreation: noch nicht.
- Drei Hirne, drei Maschinen — eine Spitze: Das Tri-Muster (Berater/Lead/Schwarm) decken wir lokal ab. Die Qualitäts spitze bleibt frontier und läuft bei uns als Frontliner für Top-Kreation, harte Planung und Review; Routing-Regeln entscheiden, was lokal bleibt und was nach draußen darf. Ersetzt wird deren Basislast und ihr Datenabfluss.
- Betrieb: Board, Betriebsregeln und Wiederherstellung sind die halbe Arbeit. Ein KI-Mitarbeiter ohne Betriebsordnung ist ein Praktikant ohne Ausweis.
Karte: „Nicht eine KI, die antwortet — sondern Mitarbeiter, die arbeiten.“
Teil 2: Private
(Kürzabo, nächste Woche): Warum sensible Dateien das eigentliche Produktversprechen eines lokalen Teams sind; dazu die Datenflusskarte (was bleibt drin, was verlässt es nie) und das ehrliche Duell mit Ollama + Open-WebUI.