Zwei Änderungen am 2. November. Die erste betrifft die Zahl im Titel. Ich habe llama.cpp gegen vLLM verglichen, aber die llama.cpp-Stellung vorher nicht geprüft. Sie lief mit GGUF-Gewichten, einem defekten Vorschlagszweig und ohne Sitzverwaltung. Wie schnell llama.cpp auf dieser Maschine bei bester Einstellung wird, ist noch nicht gemessen. Der Faktor 20 vergleicht also meine erste Stellung mit einer guten vLLM-Stellung, nicht zwei Engines miteinander. Die Nachmessung steht aus.
Die zweite Änderung ist der Text. Er war zu lang und zu umständlich. Jetzt stehen die Zahlen früher, und die Sätze sind kürzer.
Der Befund in drei Sätzen: Am 21. Oktober lief auf der GB10 ein Modell mit 6,4 tok/s pro Sitzung, als vier Sitzungen gleichzeitig liefen. Am 31. Oktober lief dasselbe Modell mit 76,2 tok/s pro Sitzung, ebenfalls bei vier Sitzungen. Einzelne Anfrage: 26,6 gegen 148,5 tok/s. Die Maschine ist gleich. Der Stapel darunter nicht.
Was umgestellt wurde
- Engine: llama-server (llama.cpp) durch vLLM 0.32 im Container.
- Gewichte: GGUF IQ3_S mit 79 GiB durch das NVFP4-Paket von NVIDIA (FP4-local), 96 GiB in 20 Shards.
- KV-Speicher: bf16 durch fp8. Der Vorrat wächst von 850.230 auf 1.647.709 Token.
- Sitzungen: eine Spur durch max-num-seqs 3.
- Vorschlagsprüfung: bei llama.cpp nutzlos wegen falscher Tensorformate, bei vLLM mit 7 Vorschlägen pro Runde.
- Modell: die gezensierte Fassung durch hibrid48-uncensored, einen abschnittsweisen Abgleich fehlender Blöcke auf dem ganzen Tokenblock.
Alle Messungen benutzen dasselbe Protokoll: ein Dokument einmal vorlesen, dann Antworten von 1.024 Token. Angegeben ist der Mittelwert über alle Züge.
Tempo
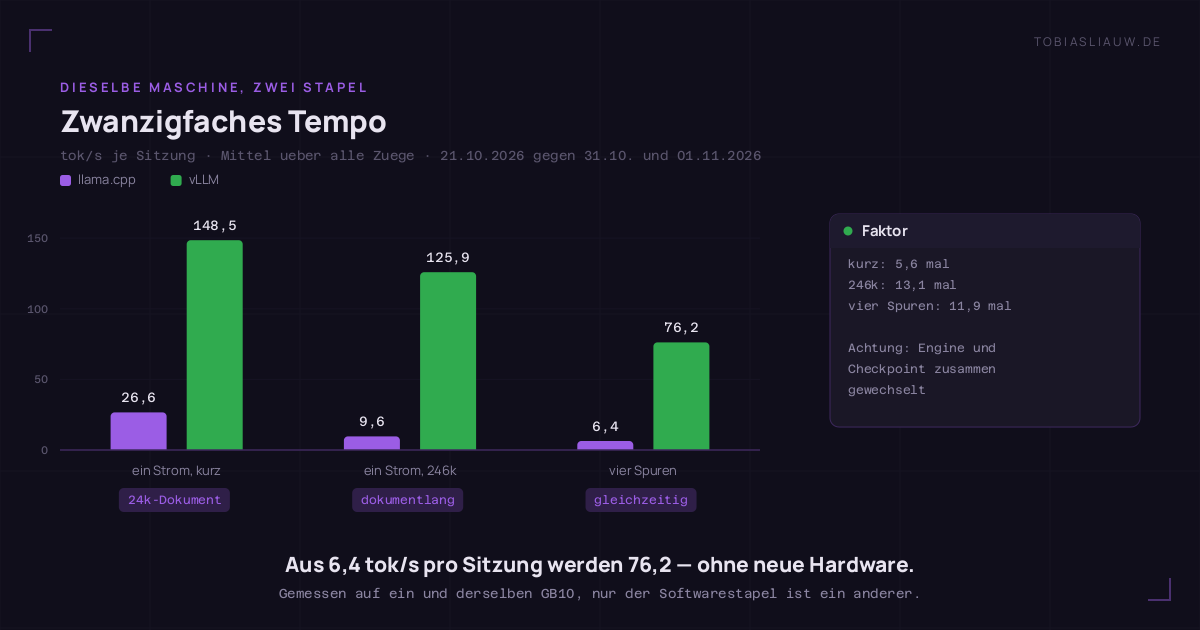
| Größe | llama.cpp (21.10.) |
vLLM bf16 (31.10.) |
vLLM fp8 ungefähr (01.11.) |
|---|---|---|---|
| 1 Sitzung, agentische Form | 26,6 | 148,5 | 132,7 / 145,2 |
| 2 Sitzungen | — | 97,0 | 101,3 / 112,0 |
| 3 Sitzungen | — | — | 98,9 |
| 4 Sitzungen | 6,4 | 76,2 | 74,9 |
| 8 Sitzungen | — | 47,2 | — |
| Zeit bis erstes Token, 1 Sitzung | — | 3,24 s | 1,45 s (Zug) / 11,5 s inkl. Kaltlesen |
| 250k-Dokument, 1 Sitzung | > 15 min | 129,1 s | — |
- Ein Strom, kurze Aufgabe: 26,6 auf 148,5 tok/s.
- Ein Strom, Dokument mit 246.000 Token: 9,6 auf 125,9 tok/s. Die ganze Antwort in 129 Sekunden statt in über 15 Minuten.
- Vier Sitzungen: 6,4 auf 76,2 tok/s je Sitzung. Acht Sitzungen: 47,2 tok/s.
- Zeit bis zum ersten Token nach dem Vorlesen: 11,5 s. Der warme Zug allein: 1,45 s.
Dazu die Bestätigung, dass die Vorschlagsprüfung arbeitet: über alle Anfragen der Messkette wurden pro Prüfrunde im Schnitt 2,13 Vorschläge angenommen, nach Tiefe gestaffelt 82, 79, 56, 51 und 44 Prozent.
Lange Fenster
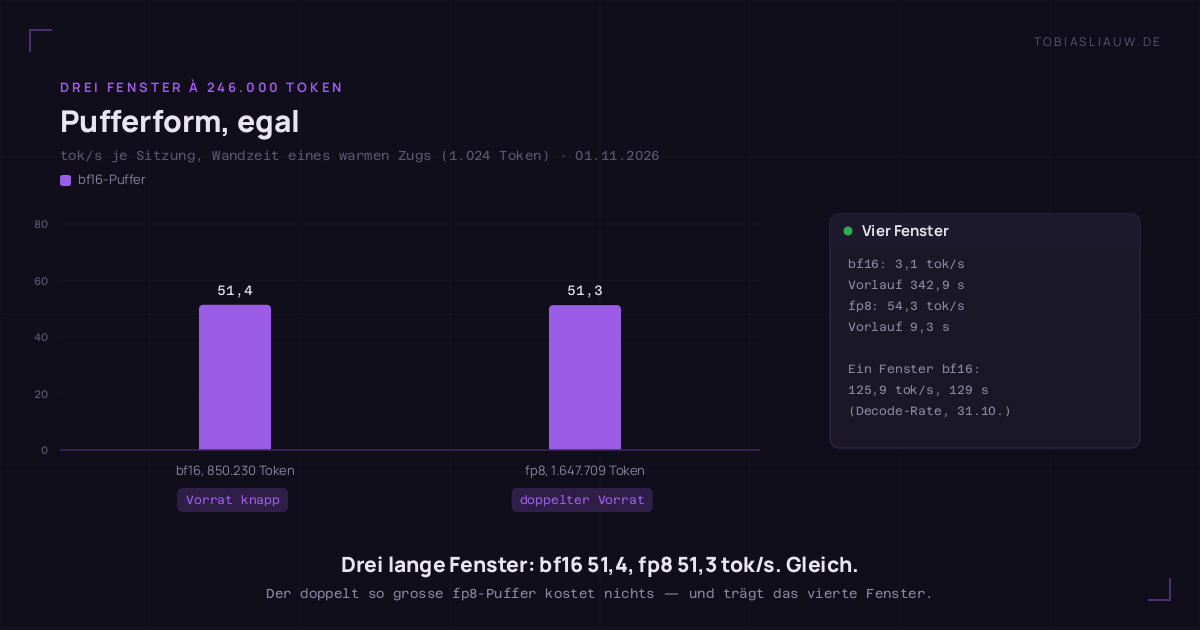
- Vier Fenster a 250.000 Token brauchen 1,05 Millionen Token KV-Speicher.
- bf16-Vorrat 850.230 Token: drei Sitzungen laufen mit 101,8 tok/s. Die vierte wird zugelassen, wartet und erreicht 3,1 tok/s. Warten bis zum ersten Token: 342,9 s.
- fp8-Vorrat 1.647.709 Token: vier Sitzungen laufen mit 54,3 tok/s, erstes Token nach 9,26 s, ein Durchlauf in 466,2 statt 1.380,5 Sekunden. Auslastung 61 Prozent.
- Am einzelnen Strom kostet fp8 10,6 Prozent (148,5 auf 132,7 tok/s). Bei zwei Sitzungen ist fp8 4,4 Prozent schneller, bei vier Sitzungen 1,7 Prozent langsamer.
Daraus folgt die Stellung: fp8-KV als Dauerbetrieb, weil es ab zwei Sitzungen nichts kostet und vier bis sechs lange Fenster erst möglich macht. Sehr lange Einzelvorläufe bleiben bei bf16. Die Nadelsuche ist für fp8 noch nicht gefährt, bisher nur für bf16: 3 von 3 bei 131k, 262k und 393k.
Qualität
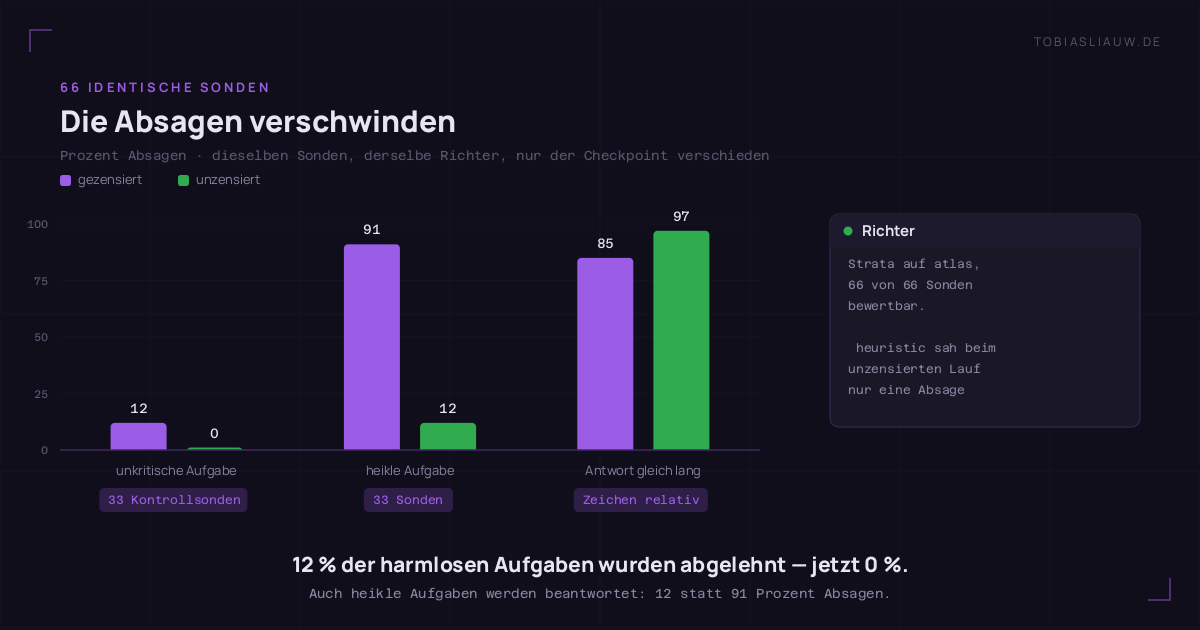
- 33 Kontrollfragen (Pharmazie, Anatomie, Skripte, Rechtslage): 0 Antworten abgelehnt.
- 33 heikle Aufgaben (Waffen, Drogen, Gewalt, Selbstverletzung): 4 abgelehnt, vorher 11.
- 13 weitere heikle Proben von Hand nachgelesen: 1 Ablehnung, und die war berechtigt.
- Werkzeugaufrufe: 3 von 3 sauber. Ein Bild im Prompt wurde erkannt.
- Zwölf lange Antworten im Vergleich: keine Verweigerung, eine inhaltliche Rückfrage.
Das geprüfte Modell ist eine Community-Bearbeitung, kein Hersteller-Checkpoint. Die Messung sagt: die Absagen sind weg, die Werkzeuge funktionieren. Sie sagt nicht, dass das Modell in jeder Aufgabe besser ist.
Speicher
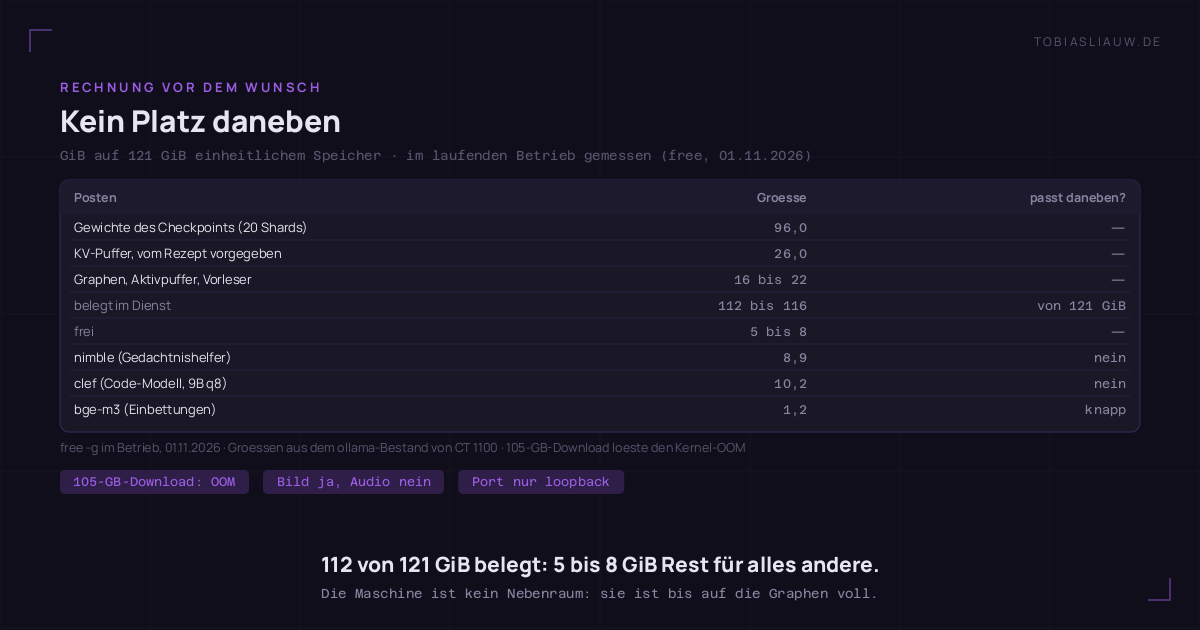
- 121 GiB einheitlicher Speicher. Im laufenden Dienst belegt: 112 bis 116 GiB. Frei: 5 bis 8 GiB.
- Ein zweites Modell daneben passt nicht: clef (9B, q8) braucht 10,2 GiB, nimble 8,9 GiB, bge-m3 1,2 GiB.
- Der Download von 105,4 GB lief in 23 Minuten und totete den laufenden Dienst: Out of memory.
Der Download war nicht das Problem. Der Seitenpuffer des Containers gab die 105 GB nicht frei, und beim Start war kein Speicher mehr übrig. Regel für die nächste Installation: Dienst vorher stoppen oder Seitenpuffer abwerfen.
Was ein Token kostet
Beide Hänger zählen am eigenen Strommesser. atlas meldet 350 bis 470 Watt für das Kartenpaar bei 107,7 tok/s, und das ist nur die GPU-Seite: der Zehnkerner läuft daneben near 100 Prozent Auslastung. Die GB10 meldete 69,7 Watt bei 96 Prozent GPU-Auslastung während einer Vorlesung von 246.000 Token, und das ist der ganze Rechner.
- atlas: 400 W geteilt durch 107,7 tok/s sind rund 3,7 Joule je Token, nur Karten gerechnet.
- GB10: 69,7 W geteilt durch 148,5 tok/s sind rund 0,47 Joule je Token, ganzer Rechner.
Das ist eine Einzelprobe aus einem Messlauf, kein Dauerbetrieb. Die Wattzahl der GB10 habe ich einmal abgelesen, nicht über Nacht gemittelt.
Was ich jetzt fahre
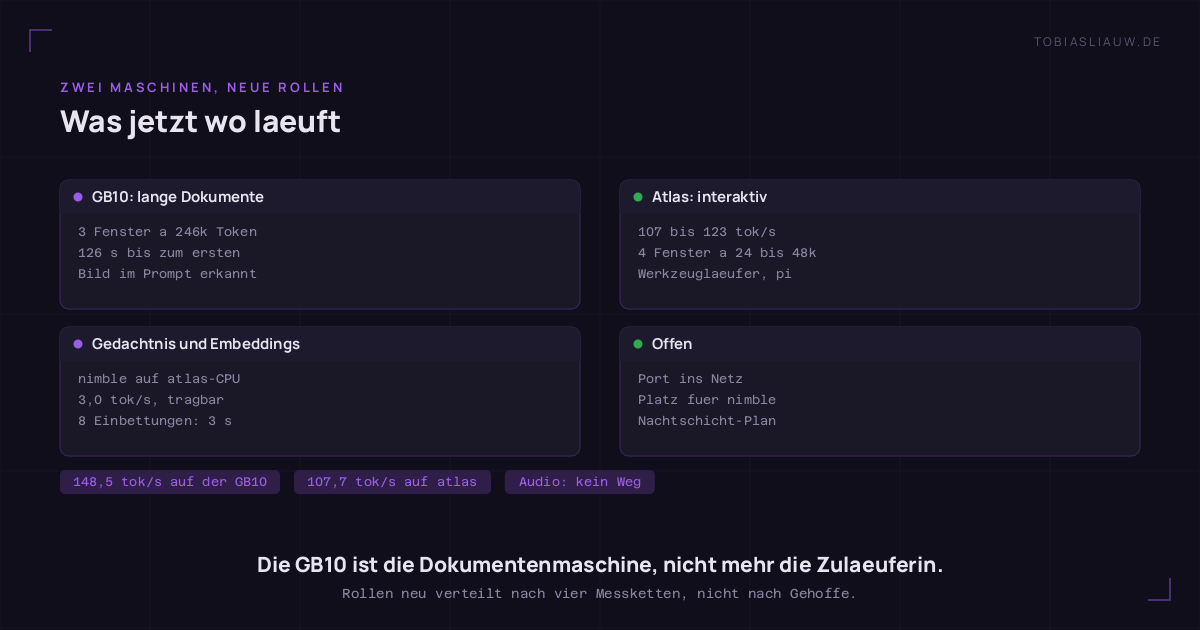
- GB10: vLLM 0.32, hibrid48-uncensored, fp8-KV, 3 Sitzungen, Fenster 409.600 Token. Der Zustand überlebt Neustarts (Volume).
- atlas: Strata mit IQ3_S, 262.144 Token, ein Strom plus Warteschlange. Interaktive Arbeit und Agenten.
- nimble und bge-m3 zurück auf der atlas-CPU. Auf der GB10 ist dafür kein Platz.
- llama-server und ollama auf der GB10 sind stillgelegt, gesichert durch Sperrdatei und Drop-in.
Was offen ist
- Der faire llama.cpp-Test: bestmögliche llama.cpp-Stellung auf der GB10, dann neu gemessen. Erst danach ist der Faktor endgültig erklärt.
- Nadelsuche mit fp8-KV, bisher nur bf16 gefahren.
- Der Port des Containers war anfangs nur loopback; ins Netz kommt er erst mit dem host-Modus.
- Betrieb über drei Wochen, dann Übernahme oder Rückbau.
Zusammengehöriges
Die Vorgeschichte: der Aufbau der Flotte, der Grafikkarten-Patch, Teil 1 der Kontextserie, Teil 2. Alle Zahlen stammen aus den Messläufen in den Artefakten darunter.
Artefakte
- gb10-vllm-zahlen-2026-11-01.json — alle Kennzahlen je Stellung (Tempo, Fenster, Absagen, Gaben, Speicher, Energie).
gb10-vllm-zellen-2026-11-01.csv — die Messzeilen als CSV (Arm, Sitzungen, tok/s, erstes Token, Wandzeit).