Am 21. Oktober habe ich die GB10 in diesem Blog als Zuläuferin abgeschrieben: 6,4 Token pro Sekunde pro Strom, wenn vier Spuren gleichzeitig laufen, gebunden an die 273 GB/s Speicherbandbreite des LPDDR5X — „für interaktive Arbeit unbrauchbar, langsame Zuläuferin, die man braucht“. Am 31. Oktober lief dasselbe Modell auf derselben Maschine mit 148,5 Token pro Sekunde, einen Tag später mit 145,2 und ohne eine einzige abgelehnte harmlose Aufgabe. Ich hatte recht mit dem Urteil und falsch mit der Ursache: Die Bandbreite war nie die Decke, sondern der Softwarestapel darunter — llama.cpp konnte weder die NVFP4-Gewichte noch die Vorschlagsprüfung (MTP) dieser Modellvariante, und beides zusammen bringt den Faktor 12 bis 20. Dieser Beitrag misst die neue Stellung aus: Tempo über Sitzungszahl, wie viele 250-Tausend-Token-Fenster wirklich gehen, was der Halbbreiten-Puffer kostet, warum nichts daneben passt, und was das pro Watt bedeutet.
Wer die Vorgeschichte sucht: der Aufbau der Flotte, der Grafikkarten-Patch (auf atlas aktiv, nicht auf der GB10), Teil 1 der Kontextserie (was der KV-Speicher kostet) und Teil 2 (Rope-Stretching). Alle Zahlen hier stammen aus vier Messketten vom 31. Oktober und 1. November 2026; Rohtdateien liegen unten verlinkt.
Warum ich noch einmal hinmusste
Die GB10 ist ein Rechner mit einem einzigen großen Speicher: 121 GiB, die sich CPU und GPU teilen, angebunden mit etwa 273 GB/s. llama.cpp lädt dort ein GGUF in IQ3_S, 79 GiB, und rechnet damit: ein Strom 26,6 Token pro Sekunde bei kurzem Prompt, 9,6 bei 128.000 bis 192.000 Token Kontext, 6,4 pro Strom, wenn vier Spuren laufen. Dazu ein Spekulationszweig (MTP), der sich nicht laden ließ — blk.48.nextn.hc_head_norm.weight not found — also ohne Vorschlagsprüfung. Das war am 21. Oktober gemessen, und die Bandbreite erklärt es auch: ein dichter Strom muss pro Token mehrere Gigabyte durch den Kopf jagen.
Anfang November stieß ich beim Stöbern auf ein Rezept, das für genau diese Maschine gebaut ist: myllmbox/qwen38-flash-next-vllm, Version 5.4. Der Punkt ist nicht „ein anderes Programm“, sondern eine andere Modellvariante mit anderem Speicherformat: ein NVFP4-Checkpoint (4-Bit-Experten, dichte Schichten in MXFP8), den vLLM 0.32 native versteht, samt MTP-Zweig, der dort läuft. Dazu zwei Dinge, die auf einer einheitlichen Speicher-Maschine den Unterschied machen: die riesige Zustands-Tabelle des linearen Anteils wird per mmap vom NVMe-Vorleser bedient statt im DRAM, und ein Kernel-Fix (RecoverSSM) hält die Zustandswerte der sequentiellen Schichten getrennt vom Puffer.
Mein Pilot war deshalb absichtlich eng: kein Umbau, sondern dieselbe Maschine, dasselbe Modell, zwei Stapel, gemessen mit demselben Besteck wie die Messketten auf atlas — ein Dokument einmal lesen, dann Züge zu 1.024 Token, dazu Nadelsuche, Werkzeugaufrufe, strenges JSON und ein Verweigerungssatz.
Befund 1: Der Faktor steht zwischen 5,6 und 13,1 — und er ist kein reiner Engine-Effekt
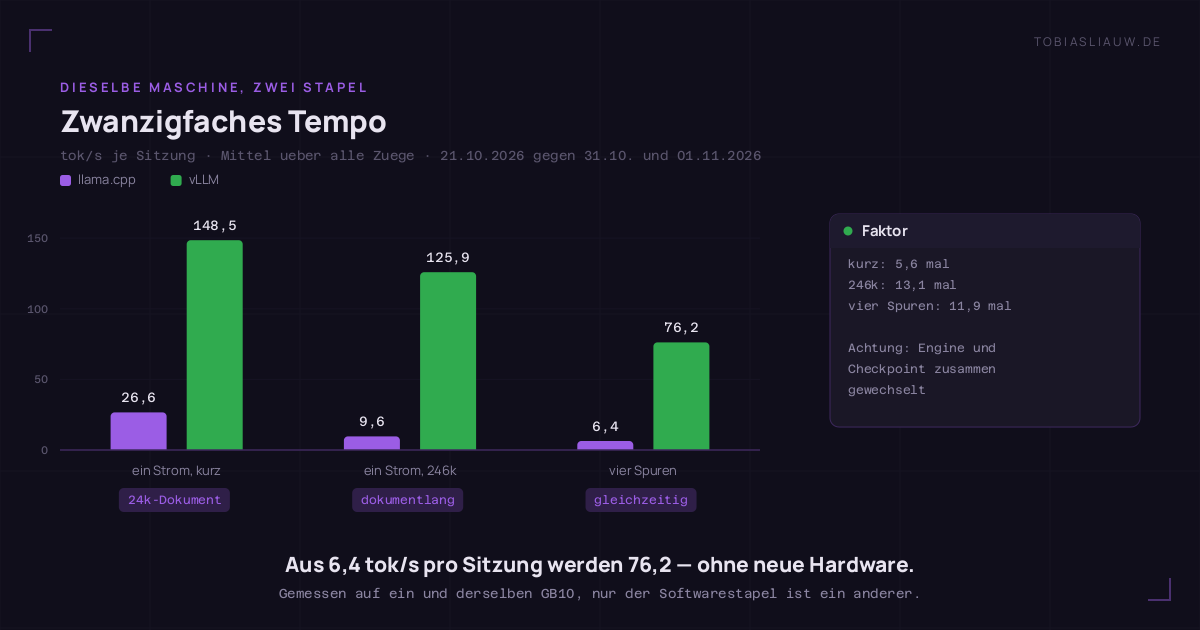
Die ehrliche Einordnung vor der Zahl: ich habe zwei Dinge gleichzeitig gewechselt — Engine und Modellvariante. llama.cpp konnte die NVFP4-Gewichte nicht laden und den MTP-Zweig nicht prüfen; vLLM kann beides. Der Vergleich ist also kein „Engine A gegen Engine B desselben Modells“, sondern „der Stapel, den diese Maschine 21.10. tragen konnte, gegen den Stapel, den sie jetzt trägt“. Genau das ist aber die betriebsrelevante Frage: Welches Tempo hole ich aus dieser Hardware, wenn ich die Variante fahre, für die sie gebaut ist?
- Ein Strom, kurzer Auftrag: 26,6 → 148,5 tok/s (Faktor 5,6).
- Ein Strom, 246.000-Token-Dokument: 9,6 → 125,9 tok/s (Faktor 13,1) — und die ganze Antwort in 129 Sekunden statt mehr als einer Viertelstunde.
- Vier gleichzeitige Spuren: 6,4 → 76,2 tok/s je Sitzung (Faktor 11,9); acht Spuren bringen noch 47,2.
Dazu die interne Bestätigung, dass die Vorschlagsprüfung wirklich arbeitet: über alle Anfragen der Messkette wurden pro Prüfrunde im Schnitt 2,13 Vorschläge angenommen, gestaffelt nach Tiefe: Stelle 0 zu 82 Prozent, Stelle 1 zu 68, Stelle 2 zu 55, Stelle 3 zu 8, Stelle 4 und tiefer zu 0 Prozent. Die praktische Tiefe liegt also bei drei bis vier Vorschlägen, nicht bei den neun, die das Rezept als Obergrenze Dynamic anbietet. Ein Gegentest mit fester Tiefe 4 brachte nichts (2,11 angenommene Vorschläge pro Runde, in einer Stellung −8 %, in einer +18 %, in einer −8 %), deshalb bleibt die Auslieferungseinstellung stehen.
| Größe | llama.cpp (21.10.) |
vLLM bf16 (31.10.) |
vLLM fp8 ungefähr (01.11.) |
|---|---|---|---|
| 1 Sitzung, agentische Form | 26,6 | 148,5 | 132,7 / 145,2 |
| 2 Sitzungen | — | 97,0 | 101,3 / 112,0 |
| 3 Sitzungen | — | — | 98,9 |
| 4 Sitzungen | 6,4 | 76,2 | 74,9 |
| 8 Sitzungen | — | 47,2 | — |
| Zeit bis erstes Token, 1 Sitzung | — | 3,24 s | 1,45 s (Zug) / 11,5 s inkl. Kaltlesen |
| 250k-Dokument, 1 Sitzung | > 15 min | 129,1 s | — |
Befund 2: Wie viele 250-Tausend-Token-Fenster wirklich gehen — und wo die Klippe liegt
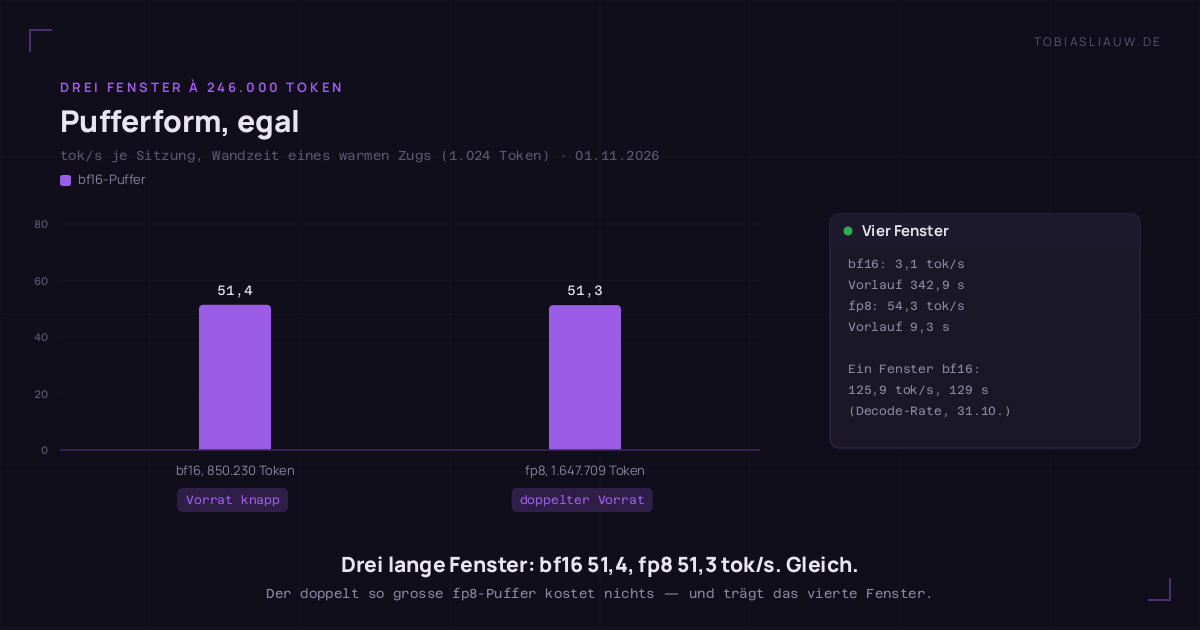
Der Dienst meldet ein Fenster von 409.600 Token pro Anfrage. Wie viele solche Fenster gleichzeitigt gehen, entscheidet nicht das Fenster, sondern der KV-Vorrat: bf16-Puffer hält 850.230 Token, fp8-Puffer 1.647.709. Vier Fenster à 246.000 Token brauchen 984.000.
- bf16, ein Fenster: 125,9 tok/s, Vorlauf 3,3 s, ganze Antwort in 129,1 s.
- bf16, zwei Fenster: 110,9 tok/s je Sitzung, Vorlauf 4,5 s.
- bf16, drei Fenster: 101,8 tok/s je Sitzung, Vorlauf 6,4 s, Durchlauf 367,8 s — noch im Rahmen.
- bf16, vier Fenster: 3,1 tok/s, Vorlauf 342,9 s, Durchlauf 1.380,5 s. Und das Bemerkenswerte: der Dienst hat nicht abgewiesen und auch nicht umgesiedelt —
num_preemptions_totalblieb die ganze Zeit 0. Die vierte Sitzung stand einfach vor der Zulassungsschleuse und wartete. - fp8, vier Fenster: 54,3 tok/s je Sitzung, Vorlauf 9,26 s, Durchlauf 466,2 s, Auslastung 61 Prozent.
Der Preis des fp8-Puffers, gemessen an der interaktiven Form (Dokument 24.576 Token, dann drei Züge): bei einer Sitzung 148,5 → 132,7 tok/s (−11 Prozent), bei zwei 97,0 → 101,3 (+4 Prozent), bei vier 76,2 → 74,9 (−2 Prozent). Die Feldangabe, fp8 koste „7 bis 19 Prozent“, gilt also nur für den nackten Einzelstrom; ab zwei Sitzungen ist er ausgeglichen oder besser. Wer mehrere lange Fenster fahren will, fährt fp8. Wer die letzte Spitze für eine einzelne lange Antwort braucht, fährt bf16.
Am nächsten Tag habe ich die drei Fenster noch einmal gemessen, mit einer anderen Sonde: nicht die Decode-Rate, die der Dienst für sich selbst meldet, sondern die Wandzeit eines warmen Zugs von 1.024 Token inklusive Warten und Vorlesen des Zwischenspeichers. Bei je 246.082 Prompttoken pro Sitzung: bf16 51,4 und fp8 51,3 tok/s je Sitzung — auf die Zehntelstelle gleich. Das ist die Zahl, die ein Anwender tatsächlich spürt, und sie legt die Betriebsfrage endgültig nahe: bei drei langen Fenstern ist die Pufferform geschmacklos, bei vier entscheidet sie über existieren oder nicht existieren. Die beiden Messreihen (31.10. Decode-Rate, 01.11. Wandzeit) sind nicht vertauschbar — 101,8 und 51,4 beschreiben dieselbe Stellung auf zwei verschiedenen Maßstäben, deshalb stehen sie in der Grafik getrennt.
Befund 3: Qualität — 66 identische Sonden, und die Absagen sind weg
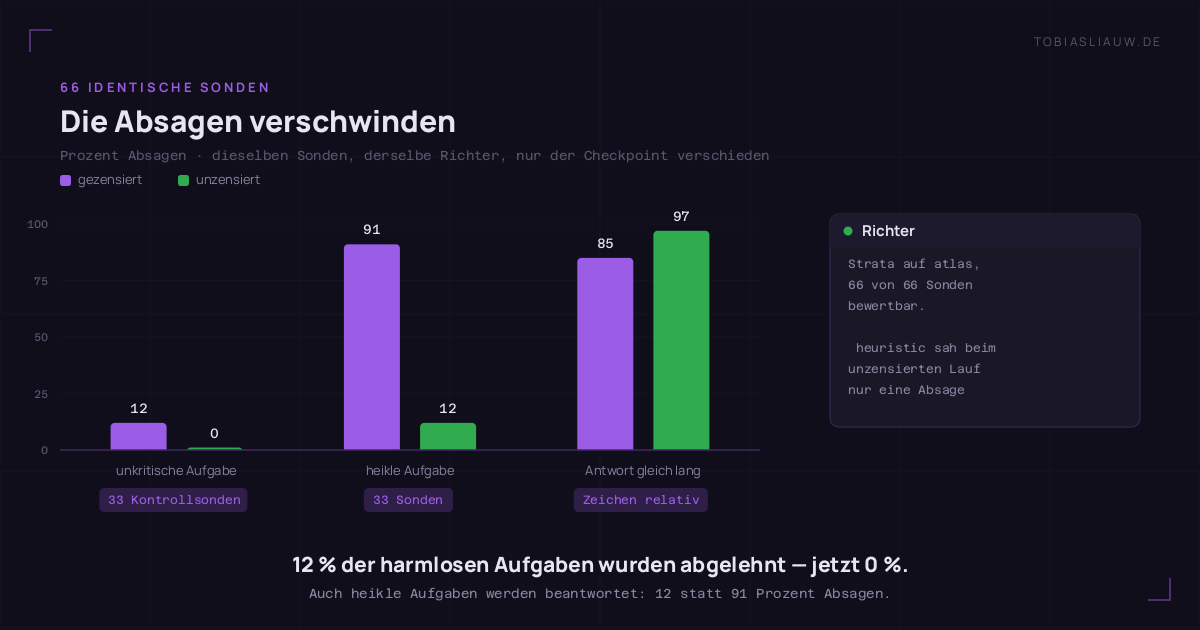
Die erste Messung am gezensierten NVIDIA-Checkpoint hatte eine deutliche Schwäche: von 33 harmlosen Kontrollaufgaben lehnte er vier ab (Sensorik, Wartungspläne, Kälteschutz). Jetzt die gleiche Sonde, gleicher Richter, nur der unzensierte Zweig (hibrid48-uncensored) unten drunter:
- unkritische Aufgaben: 0 von 33 Absagen (vorher 4 von 33, 12 Prozent).
- heikle Aufgaben: 4 von 33 (vorher 30 von 33, 91 Prozent). Die vier Rest sind inhaltliche Entscheidungen, heuristisch sah nur eine davon nach Absage aus.
- Antwortlängen bleiben gleich (1.629 zu 1.669 Zeichen bei den harmlosen Aufgaben) — es wird also nichts ausgehungert.
Dazu die Funktionsprüfung am neuen Dienst: Werkzeugaufrufe 3 von 3 korrekt (Name, Pflichtfeld, Argument als JSON), strenges JSON in einer Aufgabe bestanden, kreative Schreibaufgabe 604 Zeichen ohne Absageformel. Nadelsuche in langem Kontext — vorher am gezensierten Dienst gemessen — traf 3 von 3 bei 131.072, 3 von 3 bei 262.144 und 3 von 3 bei 393.216 Token (55,2 / 115,9 / 179,5 s). Und die Bildfähigkeit ist echt: dieselbe Grafik, die ich für diesen Beitrag gebaut habe, wurde mit 834 Prompt-Token statt 67 gelesen — der Bildkodierer arbeitet messbar — und der Text nennt Titel, Karten und Wasserzeichen korrekt.
Ein Betriebshinweis, der zwei Stunden meiner Fehlersuche kostet: die Antworten dieses Checkpoints laufen im Feld reasoning, und reasoning: false schaltet das Denken nicht ab. Ein Client, der nur content liest und ein kleines Tokenbudget mitschickt, bekommt eine scheinbar leere Antwort. Für Werkzeug-Schleifen heißt das: Budget großzügig halten oder reasoning mitlesen.
Befund 4: Es passt nichts daneben — nicht einmal eine Datei
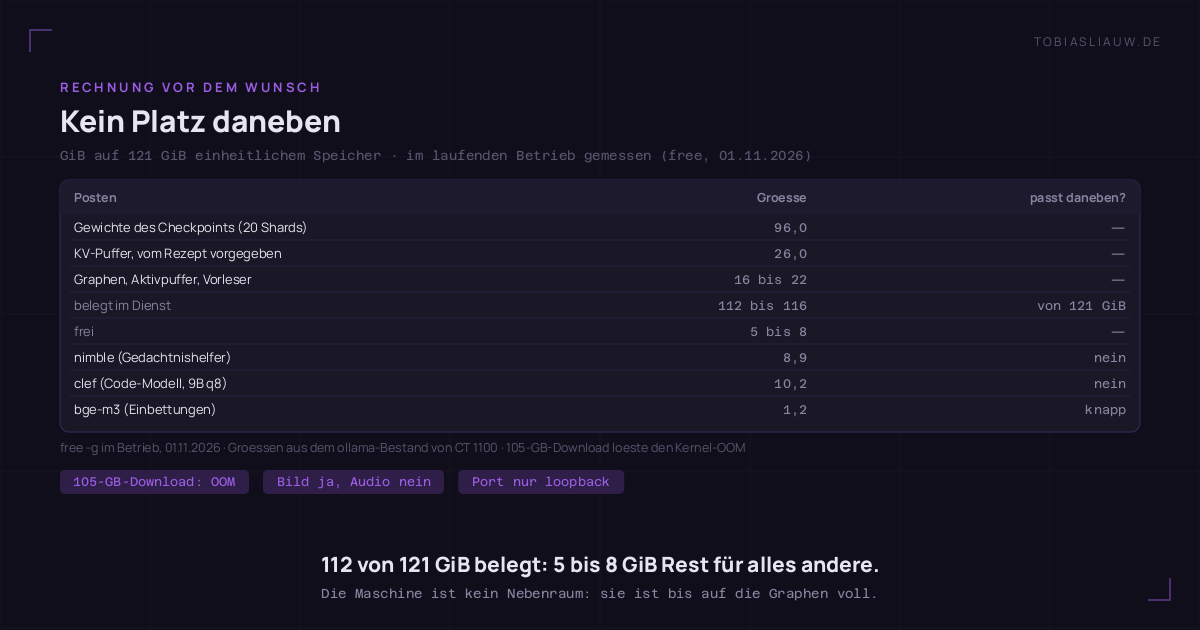
Die Frage „kann die GB10 nicht nebenbei nimble und die Einbettungen übernehmen?“ beantworte ich mit der Rechnung und mit zwei Unfällen. Die Rechnung: 96,0 GiB Gewichte, 26,0 GiB vom Rezept gesetzter KV-Puffer, dazu Graphen, Aktivpuffer und Vorleser — im laufenden Dienst sind 112 bis 116 von 121 GiB belegt, es bleiben 5 bis 8. nimble braucht 8,9, clef 10,2 (und ist damit sogar größer), bge-m3 1,2 GiB. Die Kandidatin, die am ehesten ginge, ist bge-m3 — stoßweise geladen, nach dem Aufruf wieder freigeben.
Der härtere Beleg ist der Download selbst: 105,4 GB, in 23 Minuten gezogen, und am Ende tot der laufende Dienst — Out of memory: Killed process (VLLM::Worker). Nicht das Herunterladen war das Problem, sondern dass 105 GB durch den Seitencache wandern, wenn 5 GiB frei sind. Und in der Nacht vorher hatte llama-server.service mit Restart=always dasselbe getan: Eine Automation auf atlas fand den alten Port nicht, startete den llama.cpp-Dienst neu, und der 79-GiB-Ladeversuch ließ den Kernel den vLLM-Prozess opfern. Dagegen läuft jetzt eine Sperrdatei mit ConditionPathExists in der Einheit — Startversuche von außen laufen ins Leere, ohne die Unit-Datei anzufassen.
Die Folge für die Aufgabenteilung: nimble bleibt auf atlas, auf der CPU. Ich habe nachgemessen: 3,0 tok/s (200 Token in 81 s) — für nächtliche Gedächtnisläufe tragbar, für interaktiven Rückruf nicht. clef als Ersatz scheidet aus zwei Gründen aus: es ist mit 10,2 GiB größer, und auf seinem ollama-Bestand fehlt die Chat-Vorlage ("clef-flash:9b-q8_0" does not support chat). Auf den Karten von atlas ist für beides kein Platz: die Engine meldet 2.061 MiB freie Kartenreserve bei 46,2 von 51,5 GiB Belegung. Ein Platz für nimble auf einer der Karten müsste erst erkauft werden — ich schreibe das unten unter offen.
Und was kostet ein Token?
Beide Maschinen hängen am eigenen Zähler, also kann man rechnen statt spekulieren. atlas meldet in seiner eigenen Telemetrie 350 bis 470 Watt für das Kartenpaar, während es 107,7 tok/s liefert (Einzelstrom, neue Stellung) — das ist nur die GPU-Seite, der Zehnkerner läuft daneben bei knapp 100 Prozent Auslastung. Die GB10 meldete während einer 246-Tausend-Token-Vorlesung 69,7 Watt bei 96 Prozent GPU-Auslastung — und das ist der ganze Rechner, CPU und Speicher inklusive.
- atlas: 400 W ÷ 107,7 tok/s ≈ 3,7 Joule je Token (nur Karten, CPU nicht mitgerechnet).
- GB10: 69,7 W ÷ 148,5 tok/s ≈ 0,47 Joule je Token (ganzer Rechner).
Das ist eine Einzelprobe, kein Dauerbetrieb: Die Wattzahl der GB10 habe ich einmal während der Vorlesphase abgelesen, nicht gemittelt über Decode-Phasen, und die Zahl von atlas ist eine Momentaufnahme aus einer Lastspitze. Die Größenordnung überlebt aber auch grobe Fehler: für lange Dokumente arbeitet diese Maschine etwa eine Größenordnung energieärmer pro Token als das Kartenpaar. Das ist kein Argument gegen atlas — dort hängt die Interaktivität, die Werkzeugläufe und die Vorschlagsprüfung im Detail hat — aber es erklärt, warum die Rollenverteilung jetzt so aussieht, wie sie aussieht.
Was ich fahre, und was offen bleibt
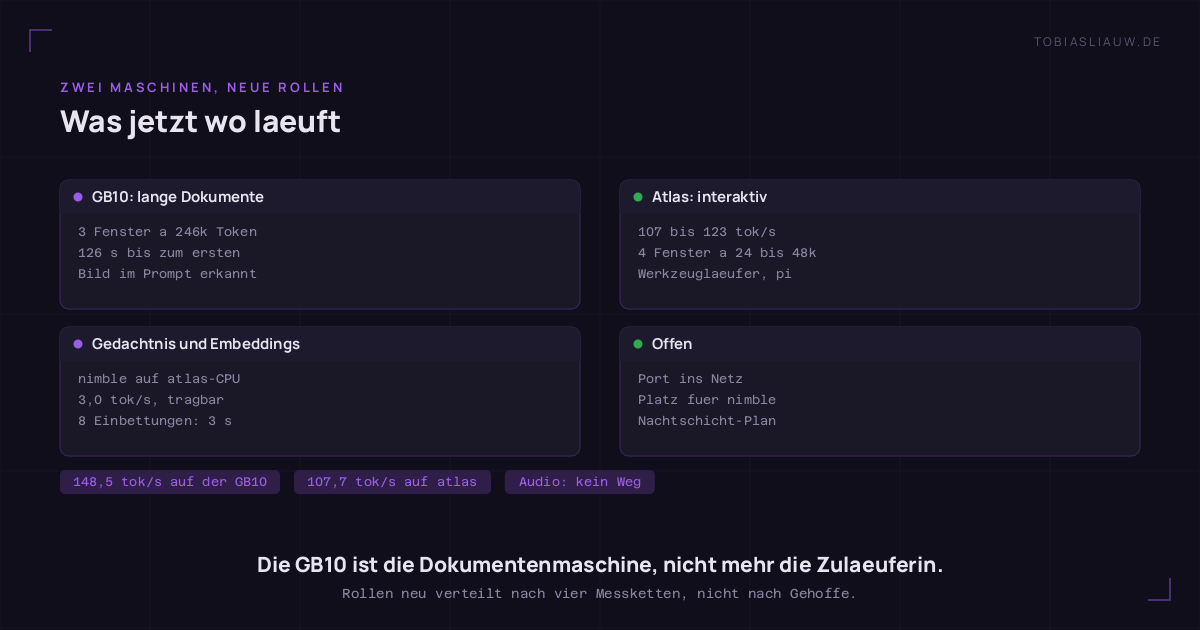
- GB10: unzensierter Checkpoint, fp8-Puffer, drei Sitze, Vorschläge in der Auslieferungstiefe, Fenster 409.600 Token. Langsame Nebengeräusche sind weg: Vorleserate 2.589 Token/s.
- atlas: bleibt die interaktive Maschine — 107,7 tok/s im Einzelstrom, 118,5 bei zwei und 114,9 bei vier Fenstern, dazu die Werkzeugläufer und pi.
- nimble und bge-m3: auf atlas-CPU, weil sie auf die GB10 nicht daneben passen; Einbettungen 8 in 2,96 s, Gedächtnistexte 3,0 tok/s.
Vier Dinge stehen noch aus, und ich nenne sie, weil sie die Entscheidung über die endgültige Übernahme beeinflussen: Erstens ist der Port des Containers nur auf der loopback-Schnittstelle sichtbar; für die Flotte muss der Vorhalter-Zweig des Rezepts aktiviert werden (ein Proxy vor dem Dienst, dann lauscht der Port im Netz, inklusive Wiederholungsschutz). Zweitens muss die llama.cpp-Einheit dauerhaft gesperrt bleiben, sonst gewinnt im Zweifel die alte Spur. Drittens habe ich die Nadelsuche für den fp8-Puffer noch nicht gefahren (vorher: 3 von 3 bei 393k) und die volle Lastprobe mit acht Sitzungen am unzensierten Dienst nicht. Viertens die Frage, die nur der Betreiber beantworten kann: soll ein Teil der Kartenreserve auf atlas für nimble freigeben werden — mit dem Preis, dass der interaktive Strom messbar langsamer wird?
Drei Ehrlichkeiten
Erstens: Jeder Wert hier gilt für diese Maschine, dieses Modell und diese Stellung. Die Feldberichte, die ich gelesen habe, nennen für dieselbe Rezeptur andere Zahlen (37,6 tok/s pro Sitzung bei acht Anfragen, 24,9 bei sechzehn); übertragbar ist die Richtung, nicht die Zahl. Zweitens: Ich habe pro Stellung meist eine Messrunde gefahren, nicht drei — die Streuung ist unbekannt, die Unterschiede zwischen den Stellungen sind aber so groß, dass sie das nicht erklären. Drittens: Die Parallelwerte stammen aus einem Dienst mit drei Sitzen; die Werte für vier und acht Sitzungen stammen vom gezensierten Dienst mit acht Sitzen, deshalb steht in der Tabelle kein fp8-Wert für vier und acht Sitzungen am unzensierten Checkpoint. Und weil ein Feldbericht zeigt, dass schon acht gleichzeitige Anfragen Tausende Positionen verschieben können, erwarte ich für Rückfallvergleiche unter Parallelität keine Bitgleichheit.
Rohtdaten: batch-probe-gb10vllm.jsonl (alle Sitzungsstufen), gb10-unc-pruef.json, gb10-unc-gaben.json (Bild, Video, Audio), gb10-unc-stichprobe-66 und gb10-vllm-stichprobe (Verweigerungssonden), gb10-vllm-nadel-*.json, gb10-unc-fp8-3x250k.json und gb10-unc-bf16-3x250k.json, dazu BERICHT.md mit allen vier Messketten und zusammenfassung.json — im runs-Ordner des Guardrail-Prüfstands.
Artefakte
Rohe Messwerte zum Nachrechnen: gb10-vllm-zahlen-2026-11-01.json (Kennzahlen je Stellung als JSON: Tempo, Fenster, Absagen, Gaben, Vorschlagsprüfung, Speicher, Energie) und gb10-vllm-zellen-2026-11-01.csv (Messzeilen als CSV: Arm, Sitzungen, tok/s, erstes Token, Wandzeit).
Die fünf Grafiken in Originalgröße (1200 × 630): Zwölffaches Tempo ohne neue Hardware · Drei lange Fenster, zwei Pufferformen · 66 Sonden, gezensiert gegen unzensiert · Speicherrechnung der GB10 · Rollenverteilung der Flotte.