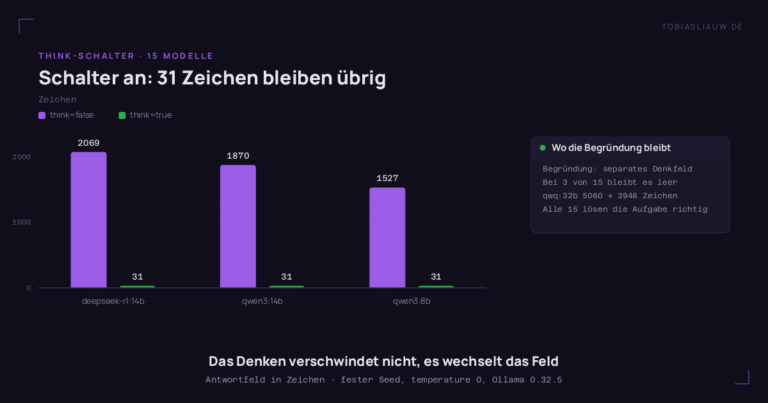
Der think-Schalter entscheidet nicht, ob gedacht wird, sondern wohin
Modelle, die „denken können“, haben in Ollama einen Schalter dafür. Die Serie hat ihn von Anfang an ausgeschaltet und das in jedem Beitrag dazugeschrieben: gemessen mit…
Blog
Infrastruktur, KI, Werkzeuge – und die Entscheidungen dahinter.
Modelle, die „denken können“, haben in Ollama einen Schalter dafür. Die Serie hat ihn von Anfang an ausgeschaltet und das in jedem Beitrag dazugeschrieben: gemessen mit…
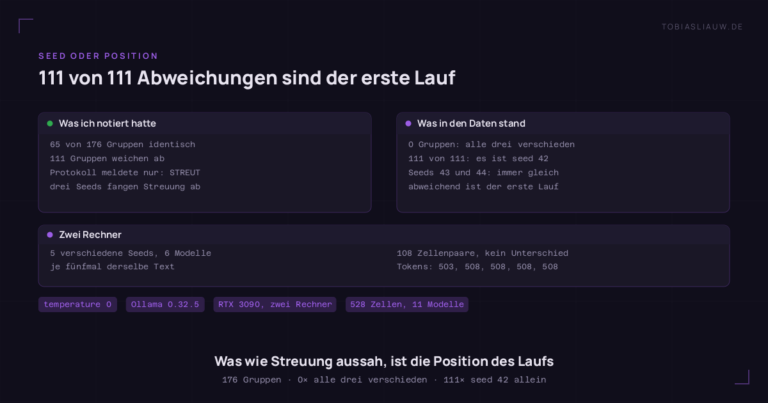
Jede Messung dieser Serie läuft mit temperature 0 und drei Seeds. Der Gedanke dahinter war: falls das Modell doch streut, fangen drei Durchgänge es ab. Beim…
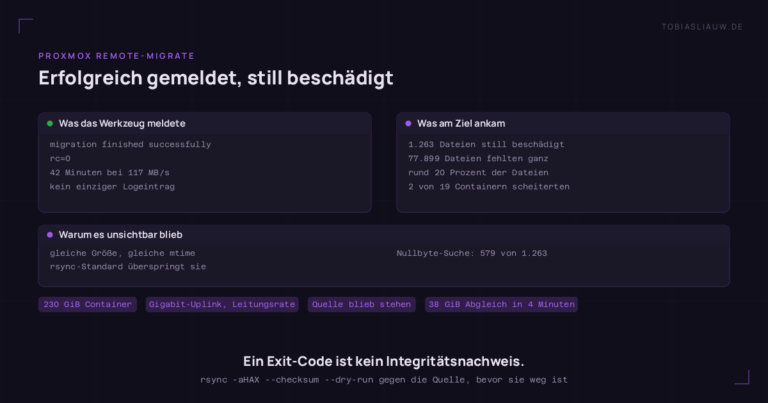
Eine X299-Workstation von 2020 wird zum Proxmox-Hauptknoten. Teil 1: Hardware, ZFS-Layout, GPU-Passthrough. Teil 2: sieben Fallstricke von pct remote-migrate — darunter einer, der bei rc=0 still…
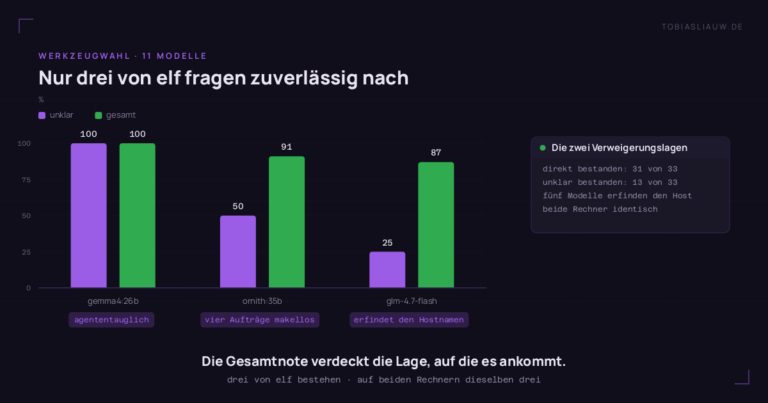
Ein Agent ist kein Chat. Die Frage ist nicht, ob das Modell klug klingt, sondern ob es das richtige Werkzeug zieht — und ob es die…
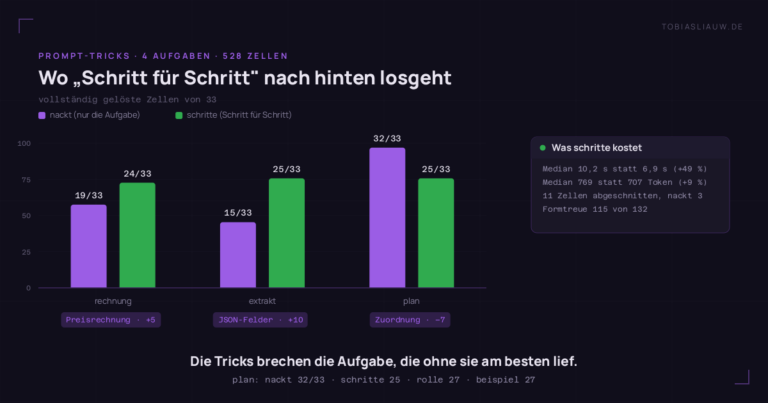
Drei Ratschläge stehen in jedem Prompt-Leitfaden: sag dem Modell, es soll Schritt für Schritt denken. Gib ihm eine Rolle. Zeig ihm ein Beispiel. Alle drei klingen…
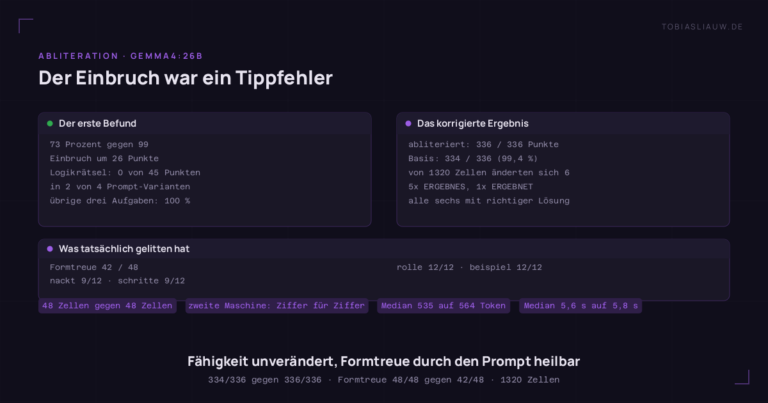
Ein abliteriertes Modell fiel im Logikrätsel auf exakt null von 45 Punkten. „Abliteration zerstört das Denken" wäre eine gute Überschrift gewesen. Sie war nur nicht wahr…
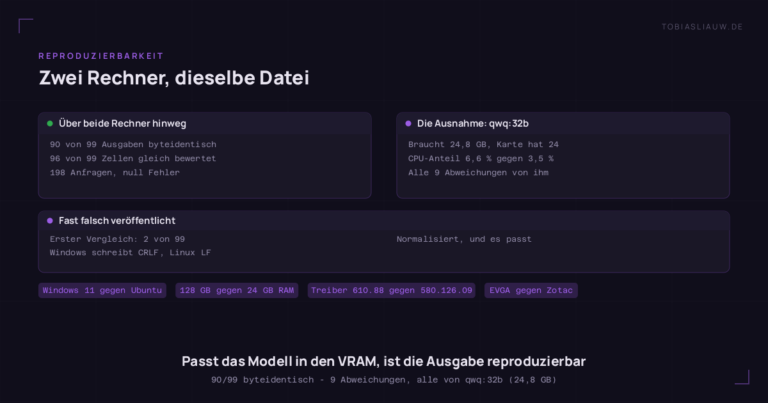
Elf lokale Modelle, drei echte Arbeitsaufgaben, zwei RTX-3090-Hosts, 198 Anfragen, null Fehler. 90 von 99 Ausgaben kamen über beide Rechner hinweg byteidentisch zurück — und die…
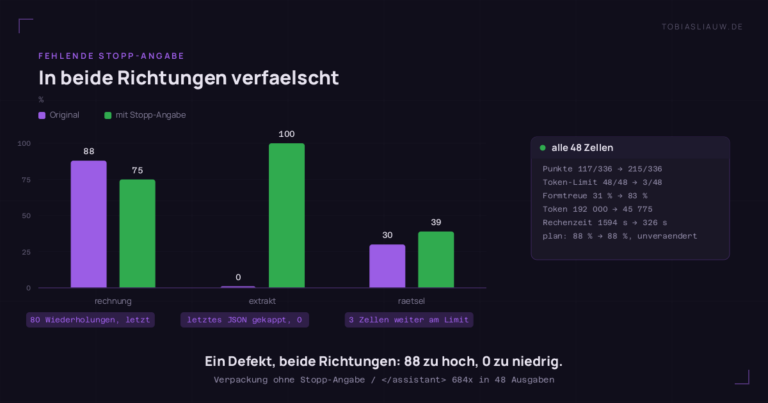
Ein Modell steht mit 35 Prozent am Tabellenende. Die Zahl ist echt gemessen — und trotzdem falsch, in beide Richtungen zugleich. Was passiert, wenn eine Ollama-Verpackung…
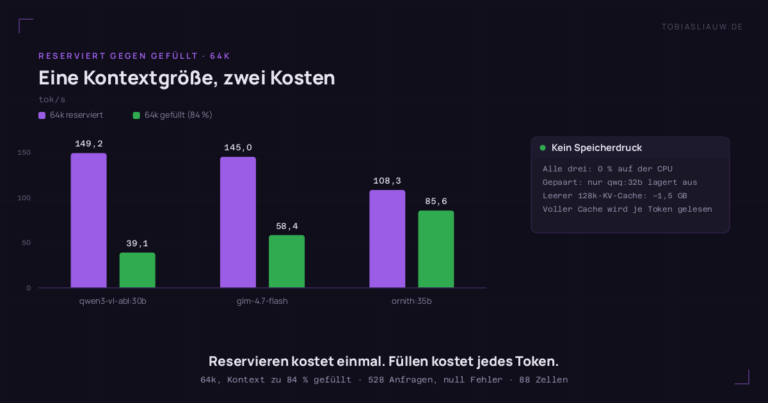
Zwei RTX 3090, elf Modelle mit identischen Digests, 528 Anfragen ohne Fehler. Einen 128k-KV-Cache zu reservieren ist beinahe umsonst; ihn zu füllen kostet 10 bis 66…