Jev, das gehostete „Decision Model“ von TypeSafe, ist gerade in aller Munde. Man gibt ihm einen Zustand und ein paar typisierte Fragen (ja/nein, eine Option wählen, auf einer Skala bewerten) und bekommt Wahrscheinlichkeitsverteilungen zurück statt Fließtext. Das Versprechen heißt Tempo und Kosten. Meine Frage war einfacher: Wie nah komme ich auf eigener Hardware heran? Es zeigte sich, dass die Open-Source-Welt die API schon nachgebaut hat, und Ollama 0.35 beantwortet denselben Endpunkt /v1/systemone inzwischen lokal. Zur Sicherheit habe ich in den Quellcode geschaut: Cloud-Modelle werden abgewiesen, und bewertet wird im lokalen Runner per Softmax über die Antwortbuchstaben.
Der Test
- Benchmark: der öffentliche Datensatz
typed-decisions(Apache-2.0), Test-Split mit 400 Fällen und 2.000 Entscheidungen aus vier Workflows. Jede Zeile ist wörtlich ein Request-Body für diesen Endpunkt. - Hardware: eine RTX 3090, ein Modell nach dem anderen, sonst nichts auf der Karte, warm, eine Anfrage nach der anderen.
- Zuerst die Kontrollen: Jedes Modell musste zwei synthetische Fälle mit gegensätzlichen Antworten bestehen, bevor seine Zahlen zählten. Das fängt Modelle ab, die immer die erste Option wählen. Genau daran war ein früherer offener „Jev-Klon“ in meinem Test gescheitert. Alle vier haben bestanden.
- Jev selbst habe ich nicht ausgeführt. Seine Zeile stammt aus der Benchmark-Karte, gemessen von den Betreuern über TypeSafes API.
Ergebnisse
| Modell | Accuracy ↑ | KL zum Gold ↓ | Brier ↓ | Accuracy der sichersten 80 % | Median-Latenz |
|---|---|---|---|---|---|
| qwen3.8:27b als Decision-Modell (Template ohne Thinking) | 0,712 | 0,335 | 0,133 | 0,776 | 4,0 s pro Fall |
| Bespoke Nimble 9B, eine Frage pro Anfrage | 0,707 | 0,451 | 0,167 | 0,771 | 0,27 s pro Frage |
| Cloudflare clef-flash 9B | 0,706 | 0,209 | 0,110 | 0,763 | 7,5 s pro Fall |
| Bespoke Nimble 9B, ganzer Fall pro Anfrage | 0,685 | 0,475 | 0,184 | 0,751 | 1,6 s pro Fall |
| Jev 1.13 (gehostet, laut Benchmark-Karte) | 0,727 | 1,442 | 0,148 | – | 0,71 s pro Fall |
| Prior (ignoriert die Eingabe, mein Scorer) | 0,483 | 0,397 | 0,197 | – | – |
Ein Fall enthält fünf Entscheidungen. Die lokalen Latenzen stammen von einer Consumer-Karte. Jevs Wert ist Ende-zu-Ende von einem Client zu einem gehosteten Dienst gemessen. Die beiden sind nicht direkt vergleichbar.
Was die Zahlen sagen
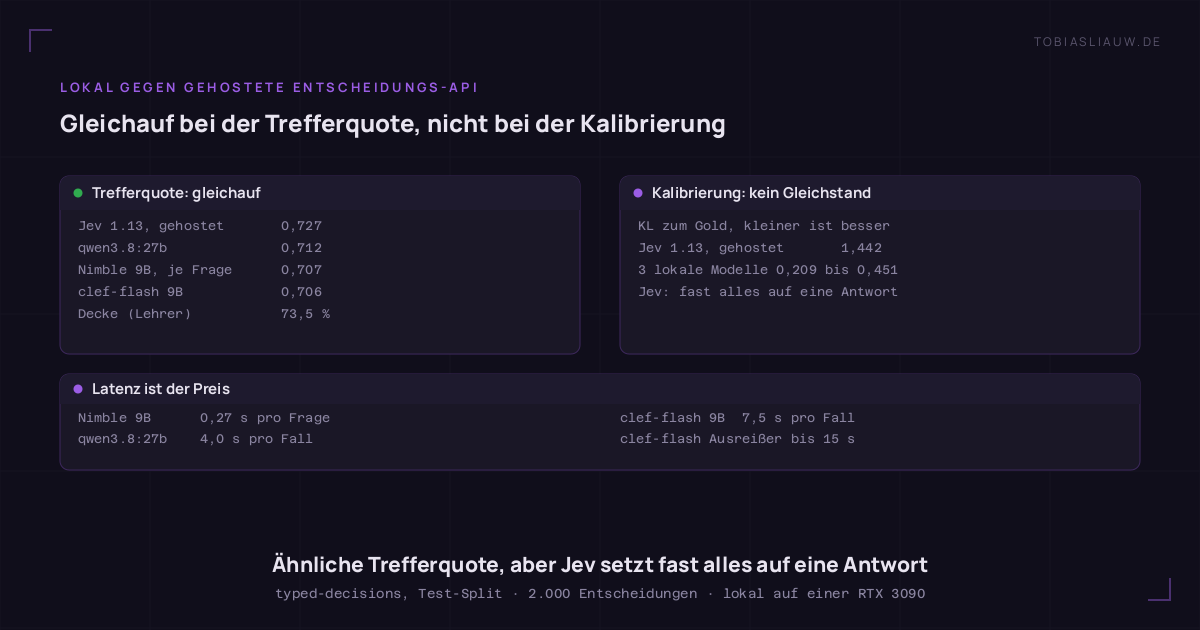
- Bei der Accuracy liegen alle gleichauf, nahe an der Decke. Die Gold-Labels sind gemittelte Antworten eines etwa 4B großen „Lehrer“-Modells. Eine frische Stichprobe desselben Lehrers stimmt nur zu 73,5 % mit ihnen überein. Jev mit 0,727 und die drei lokalen Modelle mit 0,706–0,712 liegen alle knapp unter dieser Decke. Bei 2.000 Entscheidungen beträgt ein Standardfehler etwa 0,01. Drei der vier lokalen Ergebnisse sind statistisch nicht voneinander zu unterscheiden und liegen innerhalb von etwa zwei Standardfehlern von Jev.
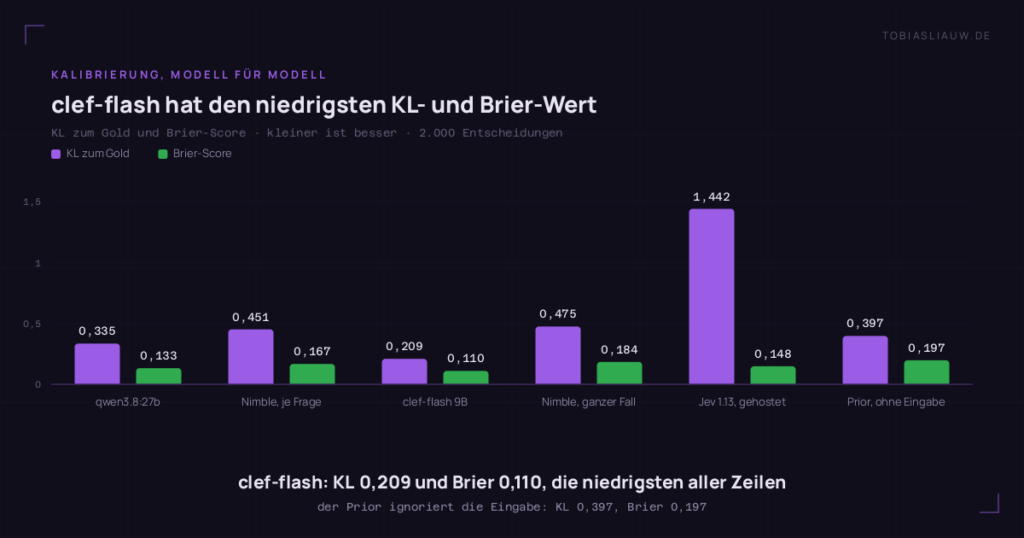
- Bei der Kalibrierung liegen sie nicht gleichauf. Jev legt fast seine gesamte Wahrscheinlichkeit auf eine Antwort, daher der KL-Wert von 1,442. Jedes lokale Modell ist deutlich weniger übertrieben selbstsicher.
- Nur clef-flash und qwen3.8:27b haben Verteilungen, die den ahnungslosen Prior beim KL schlagen, clef-flash mit großem Abstand (0,209 gegen 0,397). Beide liegen auch beim Brier vor Jev.
- Wer auf die Konfidenz hin handelt, etwa unsichere Fälle an einen Menschen weitergibt, für den zählt diese Spalte mehr als die Accuracy.
- Der Preis ist die Latenz. Nimble beantwortet eine einzelne Frage in etwa einer Viertelsekunde. clef-flash braucht 7,5 s pro Fall, mit Ausreißern bis 15 s. Das 27B-Modell ist lokal am genauesten, mit 4 s pro Fall aber kein schnelles Gate.
Was schiefging oder fast schiefgegangen wäre
- Ein früher Blick hat gelogen. Nach den ersten 105 Fällen sah es so aus, als sei es deutlich besser, alle fünf Fragen in einer Anfrage zu schicken statt einzeln. Über alle 400 Fälle ist es umgekehrt (0,707 gegen 0,685), getragen von den Auswahlfragen. Die ersten 100 Fälle waren ein einziger Workflow, und zwar der schwerste. Fast hätte ich aus einem Viertel der Daten einen Schluss gezogen.
- Die Referenzzeilen des Benchmarks konnte ich nicht vollständig nachrechnen. Bevor ich meinem Bewertungscode traute, habe ich die Baselines „Prior“ und „Uniform“ der Karte nachgerechnet.
- KL und Brier treffen die parameterfreie Uniform-Zeile exakt.
- Die Accuracy weicht in der Prior-Zeile um etwa 0,01 ab, und ich kann nicht erklären, warum.
- Den Kalibrierungsfehler (ECE) der Karte konnte ich gar nicht rekonstruieren; laut Karte berechnen ihn die Einreicher sogar unterschiedlich. Deshalb gibt es oben keine ECE-Spalte.
- Die Prior-Zeile in der Tabelle stammt aus meinem Scorer und ist damit mit meinen Zeilen vergleichbar.
- Das Label-Feld ist bei 31 von 2.000 Entscheidungen nicht das Argmax der Gold-Verteilung. Mein Selbsttest hat das aufgedeckt: Ich habe die Gold-Antworten durch meinen eigenen Parser geschickt und 100 % erwartet. Herauskamen 98,45 %.
- Ollama berechnet die „Konfidenz“ anders als Jev (eine Entropieformel statt einer Abstandsformel). Ein Schwellenwert, der auf Jevs Konfidenzfeld abgestimmt ist, lässt sich nicht übertragen. Ich habe stattdessen die vollständigen Wahrscheinlichkeitsverteilungen bewertet.
Zu „Jev schlägt Claude“
Ein viel geteilter Vergleich sah Jev bei 100 % und Claude Sonnet 5 bei 99 %, an einem Drei-Wege-Gate für Bewertungen. Das waren 102 Fälle mit je drei Läufen, also 0 Fehler gegen 3, bei dieser Stichprobe nicht unterscheidbar. Was davon trägt, sind der 57-fache Kosten- und der 9-fache Latenzabstand, dazu ein nützliches Detail: Jevs wenige Fehler kamen mit niedriger Konfidenz, die von Claude mit hoher. Das ist dieselbe Lehre wie oben. Für eine Entscheidungsschicht zählt die Kalibrierung der Konfidenz genauso viel wie die Trefferquote.
Nachtrag: dieselben Gewichte, ein zweiter Server
Alles oben lief über Ollamas Implementierung des Endpunkts. llama.cpp hat vor wenigen Tagen ein eigenes /v1/systemone gemergt, also habe ich dieselben Nimble-Gewichte dort durchgeschickt. Es waren dieselbe Karte, dieselben 2.000 Entscheidungen und dieselben Kontrollen, und alle wurden bestanden.
- Ohne Umbau ging es nicht. llama.cpp erwartet die Decision-Einstellungen in der Modelldatei: einen Modelltyp und eine Prompt-Vorlage. Ollama hält das außerhalb der Datei, in seinem eigenen Modell-Manifest. Deshalb weist llama.cpp Ollamas Nimble-Datei als „kein Decision-Modell“ ab. Ich habe die fehlenden Kopffelder aus der offiziellen llama.cpp-Konvertierung eines neueren Nimble-Release übernommen. Die Gewichte blieben Byte für Byte gleich.
- Die beiden Server bauen nicht denselben Prompt. Anweisung und Aufbau sind gleich, aber Ollama schreibt das JSON kompakt und die Vorlage von llama.cpp mit Leerzeichen. Außerdem reicht Ollama die Rohbytes des Clients durch. Mein Python-Client hat Nicht-ASCII-Zeichen escaped, deshalb sah das Modell in 125 von 400 Fällen Escape-Codes wie
\u2014statt der eigentlichen Zeichen. Ein Client, der schlichtes UTF-8 schickt, bekommt für dieselbe Anfrage einen anderen Prompt. Um Server und Prompt zu trennen, lief llama.cpp zweimal. Ein Lauf nutzte eine Vorlage, die Ollamas Prompt Byte für Byte nachbaut, geprüft an allen 4.000 Prompts. Der andere nutzte die offizielle Vorlage.
| Nimble 9B, eine Frage pro Anfrage | Accuracy ↑ | KL zum Gold ↓ | Brier ↓ | Median-Latenz | gleiche Antwort wie Ollama |
|---|---|---|---|---|---|
| Ollama 0.35 (Zeile oben) | 0,707 | 0,451 | 0,167 | 268 ms | – |
| llama.cpp mit Ollamas Prompt | 0,708 | 0,451 | 0,167 | 114 ms | 99,0 % |
| llama.cpp mit der offiziellen Vorlage | 0,688 | 0,462 | 0,169 | 124 ms | 89,6 % |
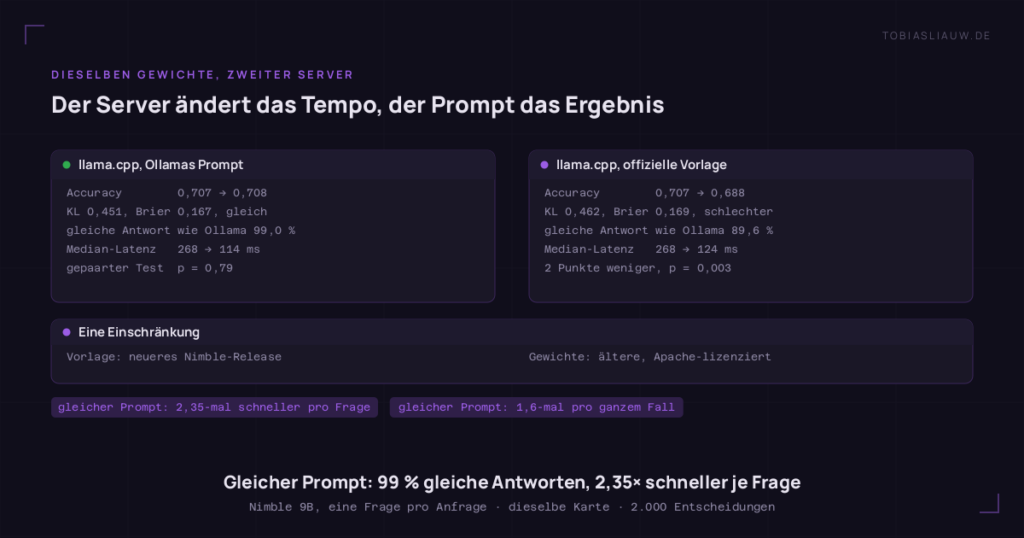
- Der Server ändert nur das Tempo. Mit identischem Prompt wählt llama.cpp in 99 % der Fälle dieselbe Antwort wie Ollama, der Rest sind Beinahe-Gleichstände. Accuracy und Kalibrierung stimmen auf drei Nachkommastellen überein (gepaarter Test, p = 0,79). Auch ganze Fälle stimmen überein: 0,683 gegen 0,685, p = 0,50. Pro Frage ist llama.cpp 2,35-mal schneller, pro ganzem Fall 1,6-mal. Die Ergebnistabelle oben hat also das Modell gemessen, nicht Ollama.
- Das Prompt-Format ändert das Ergebnis. Die offizielle Vorlage verliert bei Einzelfragen 2 Punkte Accuracy (p = 0,003) und ist schlechter kalibriert, vor allem bei Bewertungsskalen und Auswahlfragen. Bei ganzen Fällen zeigt sie in dieselbe Richtung, aber schwächer: 1,1 Punkte, nicht signifikant.
- Eine Einschränkung. Diese offizielle Vorlage gehört zum neueren Nimble-Release, die Gewichte hier sind die ältere, Apache-lizenzierte Version. Gemessen ist also: ältere Gewichte unter dem neueren Prompt. Das zeigt nicht, dass JSON mit Leerzeichen grundsätzlich schlechter ist. Für diese Gewichte ist Ollamas Format das bessere.