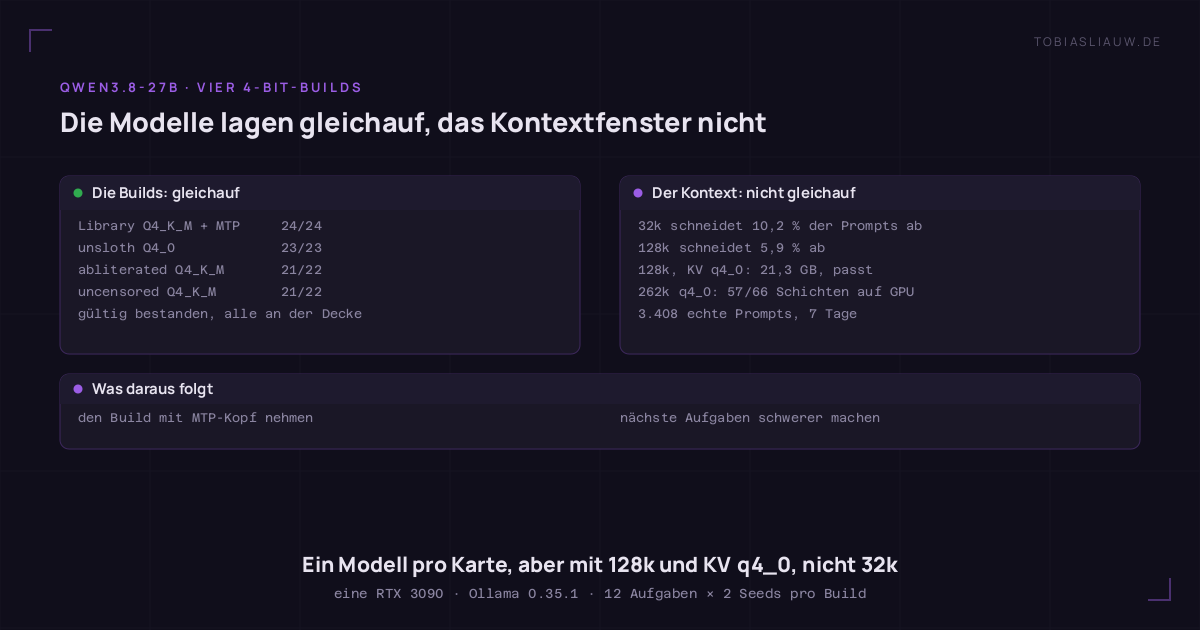
Ich wollte eine Maschine mit zwei RTX 3090 auf „ein Modell pro Karte“ umstellen: zwei unabhängige 27B-Modelle statt eines Modells, das sich mit riesigem Kontextfenster über beide GPUs streckt. Vorher brauchte ich zwei Antworten. Welcher 4-Bit-Build von Qwen3.8-27B gehört auf eine Karte? Und wie viel Kontext fasst eine einzelne 24-GB-Karte wirklich? Die erste Frage hatte eine langweilige Antwort. Die zweite hat den Plan verändert.
Der Aufbau
- Eine RTX 3090 (24 GB), Ollama 0.35.1, eine eigene Serverinstanz, fest an diese eine Karte gebunden. Während der Messung durfte nichts anderes auf die GPU. Eine Sperre prüfte vor und nach jeder Anfrage auf fremde Prozesse.
- KV-Cache
q4_0, Flash Attention an, Kontext fest auf 32.768 Tokens, und zwar auf Serverebene. Nie pro Anfrage; warum, steht weiter unten. - Die echten Flags jedes Runners (
-c 32768, KV-Typ, Flash Attention, spekulatives Dekodieren) habe ich am Prozess selbst geprüft, nicht in einer Konfigurationsdatei. - Identisches Sampling für alle Modelle (Temperatur 1,0, top_k 20, top_p 0,95), zwei Seeds, ein eindeutiger Prompt pro Anfrage, und jedes Modell wurde vor der Messung warmgefahren.
- Zwölf Aufgaben: vier Denkaufgaben mit exakter Lösung, vier Programmieraufgaben, deren Ergebnis gegen eine Referenzimplementierung ausgeführt wird, und vier Aufgaben zum Befolgen von Anweisungen mit programmatischer Prüfung.
- Jeder Prüfer musste vorab eine bekannt richtige Antwort annehmen und eine bekannt falsche ablehnen, bevor er überhaupt bewerten durfte.
- Ein Lauf, der ans Token-Limit (6.144) stieß oder eine leere Antwort lieferte, zählt als ungültig, nicht als Fehlschlag. Das Limit ist eine Eigenschaft meines Tests, kein Urteil über das Modell.
Befund 1: Die vier 4-Bit-Builds liegen gleichauf, der Tempounterschied kommt von der Verpackung
| Build | gültig bestanden | ungültig | Generierung tok/s | Prompt tok/s | VRAM bei 32k |
|---|---|---|---|---|---|
Ollama-Library qwen3.8:27b (Q4_K_M, mit MTP-Kopf und Vision) | 24/24 | 0 | 43,5 | 1.056 | 18,6 GB |
| unsloth Q4_0 | 23/23 | 1 | 35,8 | 1.308 | 16,8 GB |
| Community-Build „abliterated“ Q4_K_M | 21/22 | 2 | 32,6 | 1.222 | 16,4 GB |
| Community-Build „uncensored“ Q4_K_M | 21/22 | 2 | 30,6 | 1.164 | 16,4 GB |
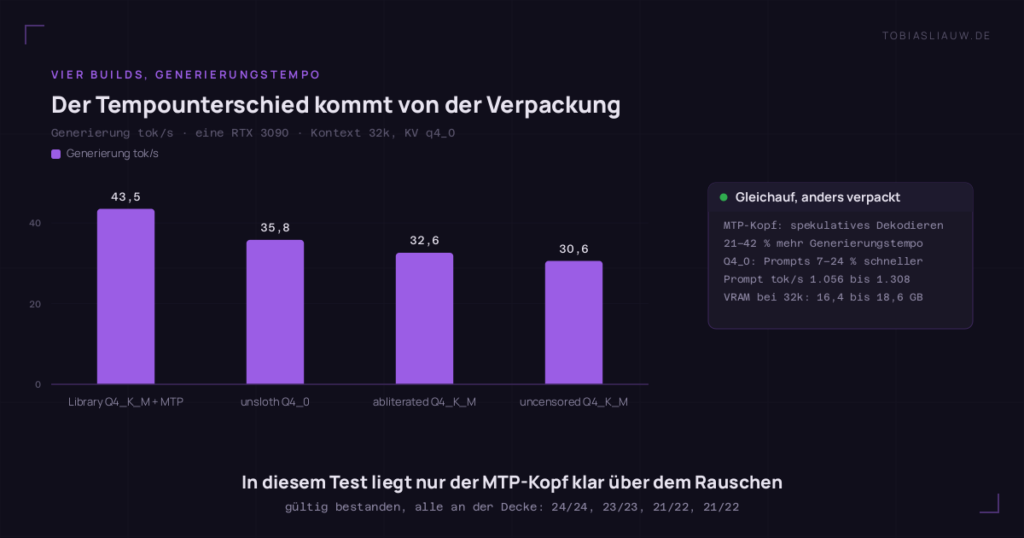
Bei 24 bewerteten Zellen pro Modell bedeuten ein oder zwei Zellen Unterschied nichts. Diese Aufgaben sind schlicht zu leicht, um 27B-Modelle zu trennen. Alle vier stoßen an die Decke. Ob die „uncensored“-Builds an Fähigkeit verlieren, kann ich weder belegen noch ausschließen.
Die belastbaren Unterschiede liegen woanders:
- Tempo kommt von der Verpackung, nicht von der Quantisierung. Der Library-Build bringt einen Multi-Token-Prediction-Kopf (MTP) mit und dekodiert damit spekulativ. Das bringt 21–42 % mehr Generierungstempo als die einfachen GGUFs. Q4_0 liest Prompts 7–24 % schneller ein als die Q4_K_M-Builds.
- Die Fehlschläge lohnen den Einzelblick.
- Drei der fünf ungültigen Läufe waren eine Kalenderfrage („Welches Datum ist 1.000 Tage nach dem 14. März 2027?“). Die Modelle dachten bis zu 13.000 Zeichen lang nach und antworteten nie.
- Ein Code-Fehlschlag war ein echter Bug: ein Parser für römische Zahlen, der den Buchstaben „I“ ablehnte.
- Ein Fehlschlag beim Befolgen der Anweisung ist Auslegungssache. Die Antwort bestand aus zwei Sätzen, aber dem zweiten fehlte der Punkt. Mein Prüfer zählt Satzzeichen. Nachträglich umgewertet habe ich nicht, weil der Prüfer vor dem Lauf feststand.
Befund 2: 32k Kontext reichen nicht. Gemessen am echten Verkehr.
Mein Plan ging von 32k pro Modell aus. Während der Benchmark lief, war der Produktivserver vorübergehend auf eine Karte mit 32k beschränkt. Ich habe nachgesehen, was seine Clients in den sieben Tagen davor tatsächlich geschickt hatten (3.408 Prompts):
| Prompt länger als | Anteil |
|---|---|
| 16k Tokens | 21,0 % |
| 32k Tokens | 10,2 % |
| 64k Tokens | 8,0 % |
| 128k Tokens | 5,9 % |
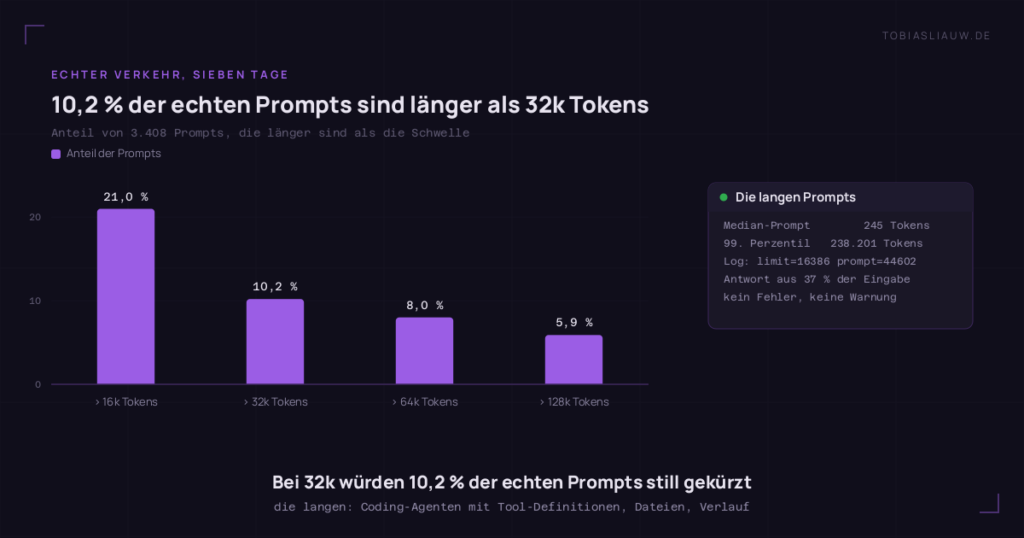
Der Median-Prompt hat 245 Tokens, das 99. Perzentil aber 238.201. Diese langen Prompts stammen von Coding-Agenten, die Tool-Definitionen, Dateiinhalte und Verlauf mitschleppen. Acht Minuten nach der Umstellung stand einer davon im Log: truncating input prompt limit=16386 prompt=44602. Der Client bekam eine Antwort auf Basis von 37 % dessen, was er geschickt hatte. Er sah keinen Fehler und keine Warnung.
Befund 3: Was eine 24-GB-Karte wirklich fasst
Den VRAM pro Kontextgröße habe ich gemessen, mit einer frischen Serverinstanz pro Konfiguration, für den 18,6-GB-Library-Build:
| Kontext | KV q4_0 | KV q8_0 |
|---|---|---|
| 32k | ✅ 18,6 GB | ✅ 19,1 GB |
| 64k | ✅ 19,5 GB | ✅ 20,5 GB |
| 128k | ✅ 21,3 GB | ❌ 63 von 66 Schichten auf der GPU |
| 262k | ❌ 57 von 66 Schichten auf der GPU | ❌ 46 von 66 Schichten auf der GPU |
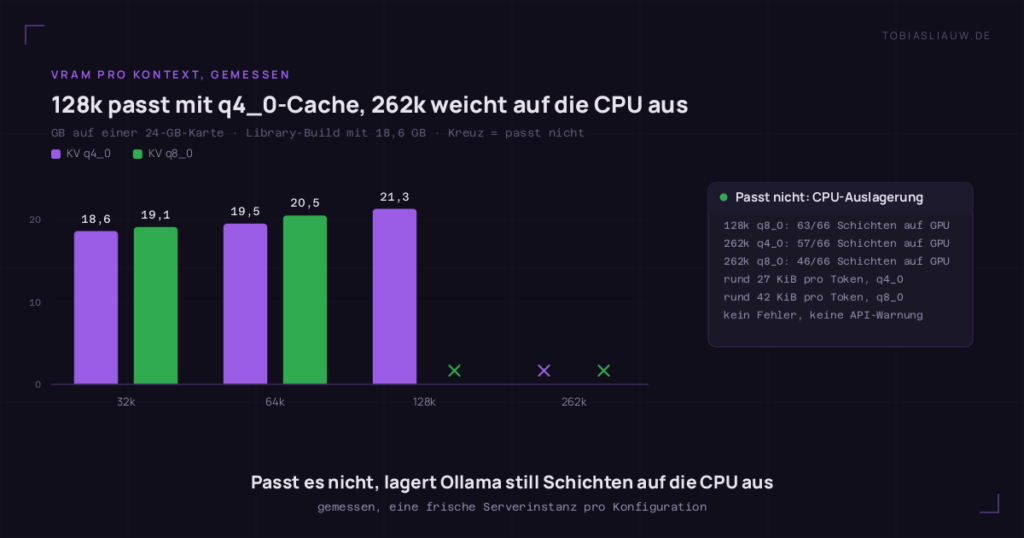
- Der Kontext kostet wenig und wächst linear. Rund 27 KiB pro Token mit q4_0, rund 42 KiB mit q8_0. Diese Modellfamilie nutzt nur in einem Teil ihrer Schichten volle Attention, deshalb ist der KV-Cache viel kleiner als bei einem klassischen Transformer gleicher Größe. Das lineare Modell hat das Scheitern bei 262k vorhergesagt, bevor es gemessen war.
- 128k mit q4_0 passt. Rechnerisch passt es auch auf die zweite Karte, neben das Embedding-Modell, das dort läuft (21,3 + 1,4 GB). Das ist gerechnet, nicht auf dieser Karte gemessen. Abgeschnitten würden damit 5,9 % des echten Verkehrs statt 10,2 %.
- Bleibt ein q4_0-KV-Cache bei langem Kontext treu? Ein Nadeltest: ein Code ganz am Anfang eines Prompts mit 101.482 Tokens, am Ende abgefragt. Er kam exakt zurück. Das Einlesen fiel bei dieser Länge auf 779 tok/s, die Generierung blieb aber bei 43,2 tok/s, genauso schnell wie mit kurzem Prompt. Eine Nadel ist ein positives Signal, kein Beweis.
- Wenn es nicht passt, scheitert Ollama nicht. Es lagert still Schichten auf die CPU aus (die „57 von 66“ oben), und das Modell antwortet weiter, nur langsamer. Kein Fehler, keine Warnung in der API. Nur die Offload-Zeile im Serverlog verrät es.
Wo Ollama selbst zugebissen hat
Ollama 0.35 nutzt darunter den llama-server von llama.cpp, Kernels und Tempo sind also dieselben. Die Überraschungen kamen alle aus der Steuerschicht darum herum:
- Der Standardkontext folgt dem verfügbaren VRAM, nicht meiner Konfiguration. Mit 48 GB auf zwei Karten lud Ollama das Modell ganz von selbst mit 256k. Weder die Modelldatei noch mein Pin-Job verlangen das. Das Modell einfach zu entladen hätte deshalb keine Karte freigemacht: Die nächste Client-Anfrage hätte es sofort wieder mit 256k über beide GPUs geladen. Genau deshalb habe ich die Produktivinstanz auf eine Karte umgestellt, statt das Modell nur zu entladen.
- Zu lange Prompts werden still gekürzt (Befund 2).
- Eine Anfrage, deren
num_ctxvom geladenen Runner abweicht, verschwindet. Kein Fehler, keine Logzeile, der Client läuft einfach in sein Timeout. Deshalb setze ich den Kontext am Server, nie pro Anfrage. - „Passt nicht“ heißt „still langsamer“ (Befund 3).
Zum Messen nehme ich ab jetzt llama-server direkt: explizite Flags, laute Fehler, Timings pro Anfrage, ein Modell pro Prozess. Für die Frage „Was bekommen meine Clients tatsächlich?“ bleibt Ollama im Spiel.
Meine eigenen Messfehler
- Meine Leerlaufprüfung konnte nie gelingen. Vor dem Neustart des Produktivservers habe ich gewartet, bis die GPU im Leerlauf ist, aber die Auslastung des ganzen Geräts gelesen. Auf dieser Karte rendert eine virtuelle Maschine ihren Desktop, das Gerät war also nie im Leerlauf. Schlimmer noch: Mein Skript startete trotzdem neu, weil ich den Neustart nicht von der Prüfung abhängig gemacht hatte. Im Log steht kein abgebrochener Request, beweisen kann ich das aber nicht. Die Korrektur: auf die Auslastung des Serverprozesses selbst prüfen und gar nicht neu starten, wenn er nie ruhig wird.
- Mein Harness stürzte an seinem eigenen Bericht ab. Nach dem ersten Modell stolperte die Zusammenfassung über die Metadatenzeile des Laufs. Die Messwerte lagen schon auf der Platte, ich habe von dort aus fortgesetzt. Berichtscode kann eine Messschleife jetzt nicht mehr beenden.
Was ich daraus mache
- Ein Modell pro Karte bleibt der Plan, aber mit 128k und q4_0-KV, nicht mit 32k.
- Den Build mit MTP-Kopf nehmen. In diesem Test ist das der einzige Unterschied, der klar über dem Rauschen liegt.
- Den nächsten Aufgabensatz schwerer machen. Ein Benchmark, den alle bestehen, misst nichts.