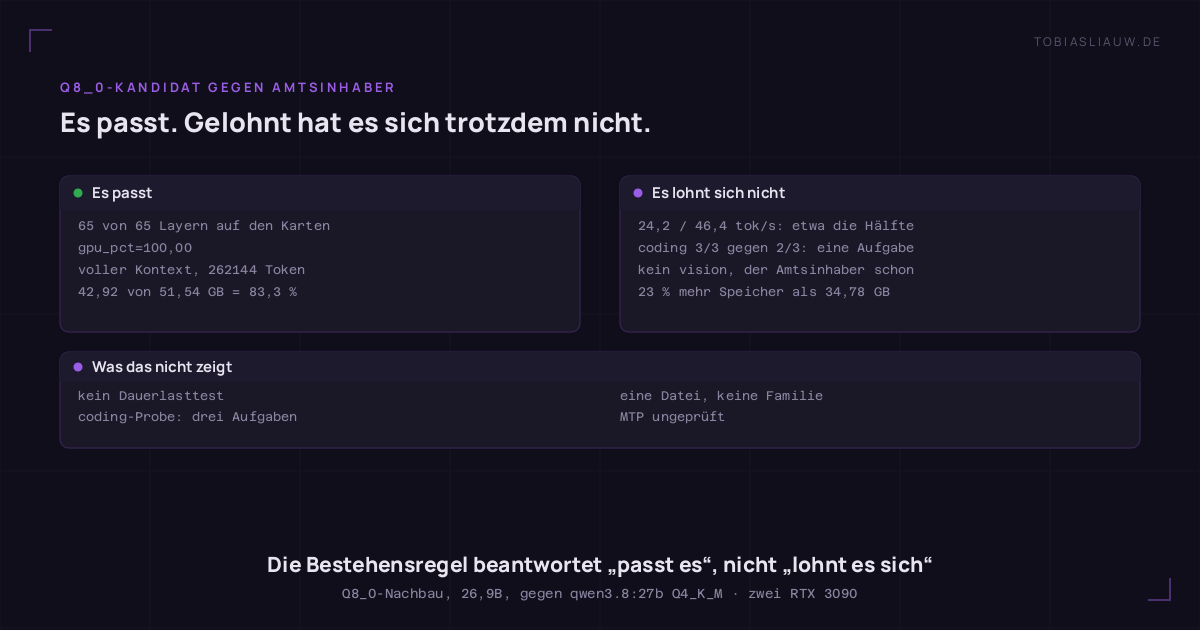
Der Kandidat hat bestanden. Die Bestehensregel stand vor dem Lauf fest, und er hat sie sauber erfüllt: 65 von 65 Layern auf den Karten, gpu_pct=100,00. Er löst trotzdem nichts ab. Zwischen „es passt“ und „es lohnt sich“ liegt bei diesem Modell vor allem die Hälfte des Durchsatzes — und 23 % mehr Speicher, mit nvidia-smi nachgemessen, nachdem hier zuerst 60 % standen.
Der Kandidat — ein fremder Q8_0-Nachbau mit 26,9B Parametern — läuft bei vollem Kontext von 262144 Token vollständig auf zwei RTX 3090, belegt dabei nachgemessene 42,92 GB und liefert 24,2 tok/s gegen 46,4 tok/s des Amtsinhabers.
Damit ist meine alte Annahme widerlegt: dass ein Q8_0 dieser Größe bei vollem Kontext nicht auf zwei Karten passt. Er passt. Nur haben „passt es“ und „lohnt es sich“ hier verschiedene Antworten.
„Bestanden“ war vorher definiert, nicht hinterher
Ein Modell, das antwortet, beweist nicht, dass es auf der Karte liegt. Es beweist, dass es antwortet. Deshalb stand die Regel vor dem Lauf schriftlich fest, und sie hat genau zwei Arme: Das Journal muss offloaded N/N layers melden, die Laufzeitabfrage muss gpu_pct=100 liefern. Nicht „ist nicht abgestürzt“. Nicht eine tok/s-Zahl, die dir hinterher gefällt.
Der Kandidat erfüllt beide Arme: 65 von 65 Layern, gpu_pct=100,00. Der Amtsinhaber ebenso, mit 66 von 66. Laden dauert beim Kandidaten 54,1 s gegen 10,6 s — aber Ladezeit war nie Teil der Regel, und ich schiebe sie jetzt nicht nach, nur weil sie mir gerade passen würde.
Was auf zwei Karten passt, und was er davon nimmt
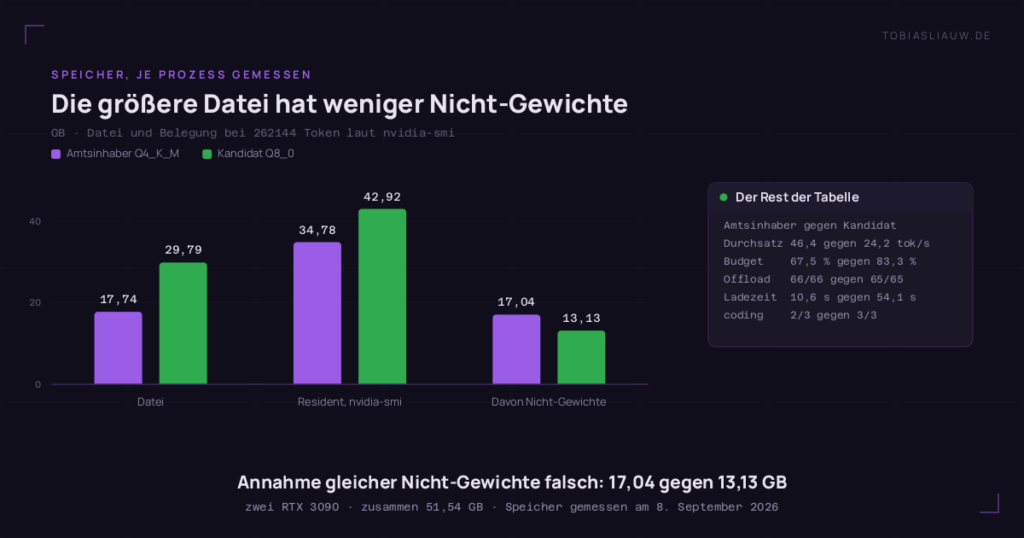
Zwei RTX 3090 haben je 24576 MiB, zusammen 49152 MiB, also 51,54 GB. Der Amtsinhaber legt sich mit 34,78 GB hinein, gemessen als 33172 MiB über beide Karten, das sind 67,5 % des Budgets. Der Kandidat nimmt 42,92 GB — 40935 MiB — und damit 83,3 %. Frei bleiben etwa 8,6 GB gegen 16,8 GB beim Amtsinhaber: für ein zweites Modell dieser Klasse reicht beides nicht, der Abstand ist also kleiner, als ich hier zuerst geschrieben hatte.
Ein Nachtrag, bevor du mit diesen Anteilen weiterrechnest: Hier stand eine Warnung, weil weiter unten eine dritte Zahl steht, die nicht dazu passte — im gescheiterten ersten Lauf hielt der Prozess des Amtsinhabers 33214 MiB, mehr als die 26,33 GB der Tabelle. Inzwischen habe ich nachgemessen, und die dritte Zahl lag richtig: nvidia-smi rechnet dem Amtsinhaber 33172 MiB zu, die Laufzeitabfrage lag um 8,45 GB daneben. Beim Kandidaten irrte dieselbe Abfrage nur um 0,66 GB, bei einem Viertel des Kontexts um 0,67 GB, beim mitresidenten Einbettungsmodell um 0,83 GB — der Fehler ist also nicht konstant, ein pauschaler Aufschlag hätte ihn nicht gerettet. Die Prozentwerte hier rechnen deshalb mit 34,78 und 42,92 GB, beide von den Karten abgelesen; danebengelegen ist die Speicherbilanz dieser Abfrage, nicht ihre Meldung darüber, wo die Layer liegen. Erledigt ist damit nicht alles: Die Freispeicherzeile weiter unten zählt jeden Nachbarn auf den Karten mit, diese Messung nur den einen Prozess.
Beide Modelle liefen ohne gesetztes num_ctx, also auf ihrem Modellmaximum von 262144 Token. Die Tabellenwerte stammen aus dem zweiten Lauf — außer der Belegung, den Nicht-Gewichten und dem Budgetanteil: die drei kommen aus einer eigenen Messung am Tag danach, mit nvidia-smi je Prozess aufgelöst, damit Nachbarn auf den Karten nicht mitzählen. „Nicht-Gewichte“ heißt dabei nichts weiter als: alles, was nvidia-smi dem Prozess über die Dateigröße hinaus zurechnet. Warum der erste Lauf gar keine Werte liefert, steht weiter unten.
| Kennzahl | Amtsinhaber Q4_K_M | Kandidat Q8_0 |
|---|---|---|
| Datei | 17,74 GB | 29,79 GB |
| Resident bei 262144 Token — nvidia-smi | 34,78 GB | 42,92 GB |
| Davon Nicht-Gewichte | 17,04 GB | 13,13 GB |
| Anteil am Kartenbudget | 67,5 % | 83,3 % |
| Offload | 66/66 | 65/65 |
| Ladezeit | 10,6 s | 54,1 s |
| Durchsatz | 46,4 tok/s | 24,2 tok/s |
| coding | 2/3 | 3/3 |
Halber Durchsatz gegen einen einzigen Punkt
24,2 tok/s gegen 46,4 tok/s. Im ersten Lauf zeigte der Amtsinhaber 47,8 tok/s, die Größenordnung hält also. Ehrlicher ist die ganze Spanne: über alle Läufe dieses und des folgenden Tages lag der Amtsinhaber bei identischer Konfiguration zwischen 43,4 und 54,7 tok/s. Das Verhältnis zum Kandidaten schwankt damit zwischen 1,79 und 2,26. „Ungefähr die Hälfte“ hält über die ganze Spanne — und es hält, weil ich die Spanne nenne, nicht obwohl. Ein einzelner Wert ohne seine Streuung ist eine Behauptung mit Nachkommastelle. Über die Gesamtdauer einer Antwort sagt das alles nichts — Ladezeit und Prefill sind eigene Posten, und gemessen wurden zwei Läufe von wenigen Minuten.
Eine naheliegende Erklärung für den Unterschied habe ich nachgemessen und verworfen. Die zweite Karte hängt mit acht statt sechzehn Lanes am Bus, also mit der halben Bandbreite — 7,88 gegen 15,76 GB/s, unter Last bestätigt und keine Leerlaufdrosselung. Wenn das etwas kostet, dann beim Laden der Gewichte. Also habe ich dasselbe Modell dreimal auf jeder Karte geladen, abwechselnd, mit vorher aufgewärmtem Dateisystem-Cache, damit die SSD nicht mitmisst: 8,44 s auf der breit angebundenen Karte, 8,85 s auf der schmalen. Das 1,05-fache. Bei halber Bandbreite wären für 17,74 GB Gewichte 1,13 s Unterschied zu erwarten gewesen, gemessen sind 0,41 s. Die halbe Anbindung ist real und kostet hier fünf Prozent.
Fast hätte ich daraus „PCIe ist egal“ gemacht. Dann fiel mir eine eigene Messung vom August wieder ein, und die sagt das Gegenteil: bei einem MoE-Modell, das nicht in den Speicher einer Karte passt und seine Experten deshalb laufend über den Bus nachlädt, war dieselbe schmale Karte 2,6-mal langsamer als die breite. Und Tensor-Parallelität über beide Karten war gegenüber einer einzigen nicht schneller, sondern 3,5- bis 5,2-mal langsamer. Derselbe Steckplatz, dieselben Karten, ein anderer Lastfall — und aus fünf Prozent werden 260.
Beide Zahlen stimmen. Meine gilt für ein dichtes Modell, das komplett im Speicher der Karte liegt und den Bus nur beim Laden berührt. Die andere gilt, sobald bei jedem Token Daten über den Bus müssen. Eine Messung ohne ihren Geltungsbereich ist keine Erkenntnis, sondern eine Zahl, die auf den nächsten Anwender wartet. Ich hatte die zweite Messung selbst gemacht und war trotzdem drauf und dran, sie zu übergehen.
Dem steht genau ein belastbarer Vorteil gegenüber: die coding-Probe, 3/3 statt 2/3. Ein Punkt auf einer Probe mit drei Aufgaben. Die tools-Probe endet 3/3 zu 3/3, der Kandidat brauchte dafür 5 s. Schwerer wiegen darf dieser Punkt nicht, nur weil der Repo-Name den Nachbau als Coder ausweist — mehr als den Namen habe ich dazu nicht. Eine Aufgabe Unterschied ist eine Aufgabe Unterschied.
Die thinking-Probe trägt kein Urteil
Derselbe Amtsinhaber, dieselbe Probe, elf Minuten zwischen den beiden Durchläufen: einmal PASS, einmal FAIL — und der Fehlschlag lief über einen anderen Arm als beim Kandidaten. Lauf 1: THINK_TRACE_CHARS 89, Urteil PASS. Lauf 2: 98, Urteil FAIL. Der Kandidat: 32, Urteil FAIL. Die Probe schreibt beide Fehlerarme selbst in ihren Bericht:
FAIL_ARM: content contains the trace verbatim => aliasing/no channel split
FAIL_ARM: trace 32 chars < 40 (gate open, resolver empty)
In allen drei Fällen meldete dieselbe Probe THINK_ANSWER ok. Die inhaltliche Antwort war jedes Mal richtig. Gemessen wird also Spurenlänge und Substring-Überlappung, nicht Denken. Hier die vollständige Spur des Kandidaten, 32 Zeichen lang und mathematisch korrekt:
41 * 32 = 1312 1312 - 100 = 1212
Der Schwellwert liegt bei 40 Zeichen. Wer knapp und richtig rechnet, fällt durch — meine Probe belohnt Weitschweifigkeit. In der Absicht stand das nie, nur im Code. Der andere Arm ist nicht besser: Eine kurze Antwort, die den Rechenweg mitführt, ist von einer nie getrennten Spur nicht zu unterscheiden.
Das FAIL des Kandidaten zählt deshalb nicht gegen ihn, und das PASS des Amtsinhabers zählt nicht für ihn. Eine Probe, die dasselbe Modell binnen elf Minuten zweimal verschieden bewertet, bewertet nicht das Modell.
Der erste Lauf hat vom Kandidaten nichts gemessen
Im ersten Lauf lief der Amtsinhaber zuerst — er ist zugleich das dauerhaft im Speicher gehaltene Produktionsmodell. Der Prüfstand entlädt zwischen zwei Modellen alles, mit einer Ausnahme, und die steht als Absicht im Code, nicht in einer Konfiguration:
UNLOAD_REFUSED: qwen3.8:27b is the production pin - left resident on purpose
Sein Prozess behielt 33214 MiB. Der Vorlauf fordert für den Kandidaten 32030 MiB an; geladen belegt der Kandidat 42,92 GB. Was übrig blieb, steht ebenfalls im Log:
only 13604 MiB free across all GPUs after 182s, needed 32030
per GPU: gpu0=7963 MiB gpu1=5641 MiB
Nach 182 Sekunden gab der Prüfstand auf. Der Kandidat wurde nie geladen, seine fünf Proben endeten als SKIP, Deckung über beide Modelle 40 %, exit 3. Der Prüfstand gibt den Pin einmal im Vorlauf frei — und danach stellt der erste Eintrag seiner Modellliste genau den Zustand wieder her, den die Freigabe beseitigen sollte. Ein Messaufbau, der sein eigenes Hindernis mitbringt, misst das Hindernis.
Das Schlimme daran ist nicht der Prüfstandsfehler. Es ist die Deutung, die ich vorher daraus gemacht hatte: Dieselben Zahlen — 7963, 5641, 13604 — lagen schon einmal vor mir und waren als „das Modell wird nicht über beide Karten verteilt“ abgelegt worden. Es wurde nie etwas verteilt. Der Vorgänger ging nur nicht aus dem Weg.
Zwei ungleich befüllte Karten und zwei ungleich frei gebliebene sehen in der Ausgabe gleich aus. Der Unterschied steht nicht in den Zahlen, sondern in der Reihenfolge der Ereignisse davor — und die hatte ich nicht gelesen. Lauf 2 drehte nur die Reihenfolge um, Kandidat zuerst auf leere Karten: Deckung 80 %, exit 0, alles gemessen.
Meine Vorhersage war nicht knapp daneben, sondern falsch begründet
Vor dem Lauf hatte ich gerechnet: Der KV-Cache hängt an Layern und Heads, nicht an der Dateigröße; gleiche Architektur, also gleicher Nicht-Gewichte-Anteil. Beim Amtsinhaber meldete die Laufzeitabfrage 26,33 minus 17,74, macht 8,59 GB. Kandidat: 29,79 plus 8,59, macht 38,38 GB.
Gemessen wurden 42,92 GB. Der Nicht-Gewichte-Anteil des Kandidaten liegt bei 13,13 GB, der des Amtsinhabers bei 17,04 GB — gegenüber der alten Tabelle kehrt sich die Rangfolge damit um, und meine Annahme, beide seien gleich, war ohnehin falsch. Die Vorhersage lag 11 % zu niedrig; mit dem gemessenen Anteil des Amtsinhabers wären es 29,79 plus 17,04 gewesen, also 46,83 GB und 9 % zu hoch. Die Begründung war komplett falsch, und das ist der Teil, der wehtut: Ich hatte eine Konstante angenommen, wo eine Variable stand, und ich hatte sie aus einer Quelle geholt, die um 8,45 GB danebenlag. Eine Vorhersage, die aus zwei Fehlern fast stimmt, ist gefährlicher als eine, die klar danebenliegt. Sie bestätigt dich.
Zwei Belege, die keine waren
Am Vormittag desselben Tages war der Kandidat schon einmal angelegt worden. Der Anlegevorgang kopiert 30 GB und zeigt dabei minutenlang dieselbe Zeile, „verifying conversion“, mit einem rotierenden Zeichen. Eine frühere Sitzung sah hinein, schloss „tot“, reparierte von Hand.
Das Skript lief danach von allein zu Ende: CREATE_RC=0, LOAD_RC=0, offloaded 65/65. Es räumte hinterher selbst auf und stellte den Ausgangszustand wieder her, Produktionsmodell eingeschlossen. „Gescheitert“ stand danach als Tatsache in den Notizen, bis jemand das Log las. Ein laufender Vorgang ohne Fortschrittsanzeige ist nicht dasselbe wie ein toter.
Die zweite Falle steckte im Nachprüfen. Lauf 1 endete mit exit 3; die Abfrage für Dienstzustände sagte etwas anderes als das Systemjournal:
Result=success, ExecMainStatus=0
status=3, "Failed with result exit-code"
Der Lauf lief in einer kurzlebigen Umgebung, die sich nach dem Ende selbst aufräumt. Danach kennt die Statusabfrage ihn nicht mehr und liefert für einen unbekannten Vorgang plausible Vorgabewerte statt eines Fehlers. Eine Abfrage, die für „kenne ich nicht“ dasselbe antwortet wie für „hat geklappt“, ist als Beleg wertlos.
Beobachten, nicht übernehmen
Von den fünf Proben ergibt genau eine einen Unterschied, der zählt. Die anderen vier sehen nur so aus.
Die vision-Probe scheitert beim Kandidaten mit einem http-400. Das ist kein Befund. Das Modell hat diese Fähigkeit nicht — es meldet tools, thinking und completion und wurde ohne den Bildteil gebaut. Der Amtsinhaber bringt vision mit und besteht. Wirfst du einem Modell vor, dass es etwas nicht kann, wofür es nie gebaut wurde, misst du deine eigene Erwartung.
Die reasoning-Probe sieht nach einem Sieg aus: PASS beim Kandidaten in 56 s, ERROR INCONCLUSIVE beim Amtsinhaber, und zwar in beiden Läufen. Nur kam dieses INCONCLUSIVE daher, dass eine der drei Aufgaben auswendig gelernt war. Wieder ein Probenfehler, keine Modellschwäche. Das thinking-FAIL zählt ohnehin nicht, und die tools-Probe steht unentschieden.
Bleibt: coding 3/3 statt 2/3, gegen 24,2 statt 46,4 tok/s. Dazu eine Bedingung, die keine Probenwertung ist: Der Amtsinhaber kann vision, der Kandidat nicht — ein Ersatz muss können, was der Amtsinhaber kann. Der Speicher stützt das nur noch: 23 % mehr statt der 60 %, die ich aus der Laufzeitabfrage gerechnet hatte. Beobachten, nicht übernehmen — auf schmalerer Grundlage, als ich beim ersten Schreiben behauptet habe.
Was das nicht zeigt
- Keinen Dauerlasttest. Zwei Läufe von je wenigen Minuten, mehr ist es nicht.
- Die coding-Probe hat drei Aufgaben. 3/3 gegen 2/3 ist ein Unterschied von einer Aufgabe, kein Klassenunterschied.
- Über die Basisarchitektur sagt ein fremder Q8_0-Nachbau nichts. Ich habe eine Datei gemessen, keine Familie.
- Multi-Token-Prediction ist ungeprüft. Von fast jedem Quant gibt es eine MTP- und eine Nicht-MTP-Fassung; ich habe bewusst die Nicht-MTP-Fassung genommen und nicht gemessen, ob die Laufzeitumgebung MTP fährt oder still auf den Normalpfad zurückfällt.
- Die zwei Probendefekte sind benannt, nicht behoben. Solange sie stehen, ist jede Aussage dieser beiden Proben über jedes Modell mit Vorsicht zu lesen.
Der Aufbau, für die Nachrechner
Zwei Läufe desselben selbstgebauten Prüfstands am 7. September 2026, acht Minuten auseinander gestartet, unter gleichen Bedingungen: Die Karten standen dem Prüfstand exklusiv zur Verfügung. Fünf Fähigkeitsproben — thinking, reasoning, vision, coding, tools. Hardware: zwei RTX 3090 mit je 24576 MiB, zusammen 49152 MiB oder 51,54 GB. Ollama als Laufzeit, KV-Cache-Typ q8_0, Flash-Attention an. Der Prüfstand sendet kein num_ctx, beide Modelle liefen also auf context_length 262144. Die Speicherzahlen der Tabelle stammen aus einer dritten Messung am 8. September 2026: beide Modelle bei denselben 262144 Token, die Belegung mit nvidia-smi nach Prozess aufgelöst, dazu als Kontrolle der Kandidat bei 65536 Token.
Amtsinhaber: qwen3.8:27b, Q4_K_M, 27,3B, Datei 17,74 GB, digest 22130167c4c2, Fähigkeiten laut Modell completion, vision, tools, thinking. Kandidat: der Q8_0-Nachbau, 26,9B, Datei 29,79 GB, digest ab7447c5e7b1, Fähigkeiten tools, thinking, completion — kein vision. Er stammt aus dem Upstream-Repo DavidAU/Qwen3.8-27B-TURBO-Fable-Cold-Fusion-735-882-Heretic-Uncensored-NEO-CODER-MAX-MTP-GGUF.
Wichtig beim Nachbauen: In diesem Repo endet eine zweite Q8_0-Datei auf 30,24 GB, das ist die MTP-Fassung. Der einzige zuverlässige Unterschied ist die Bytezahl — meine Datei hat 29787699808. Zeiten des Kandidaten: reasoning 56 s, coding 31 s, tools 5 s. Lauf 1: Amtsinhaber zuerst, Deckung 40 %, exit 3, vom Kandidaten nichts gemessen. Lauf 2: Kandidat zuerst auf leere Karten, Deckung 80 %, exit 0.
Und wenn du es nachbaust: Setz das Modell, das dein Aufbau nicht entladen darf, an die letzte Stelle der Modellliste — oder gib es frei und prüfe danach den tatsächlich freien Speicher, statt dich auf die Freigabe zu verlassen.
Was ich mitnehme
„Es passt“ und „es lohnt sich“ sind zwei Fragen, und nur die erste beantwortet eine Bestehensregel. Deshalb schreibe ich sie vorher auf: Der Kandidat hat sie erfüllt, sauber und ohne Nachhilfe, und die Entscheidung fiel trotzdem gegen ihn. Ohne die Regel hätte ich hier nachträglich gedreht — nach oben, wenn mir das Ergebnis gefällt, nach unten, wenn nicht.
Jede Schwelle im Code ist eine unausgesprochene Behauptung über die Welt. Vierzig Zeichen behaupten, dass unter vierzig Zeichen nicht gedacht wird. Zweiunddreißig richtig gerechnete Zeichen widerlegen das.
Der Rest sind drei Sätze, die ich mir merke. Eine Ausnahme im Prüfcode wird irgendwann als Messwert ausgegeben; mein erster Lauf war genau das. Ein Vorgang ohne Fortschrittsanzeige ist nicht tot, nur weil er still ist. Und eine Abfrage, die Unwissen genauso meldet wie Erfolg, ist kein Beleg, sondern eine höfliche Antwort.