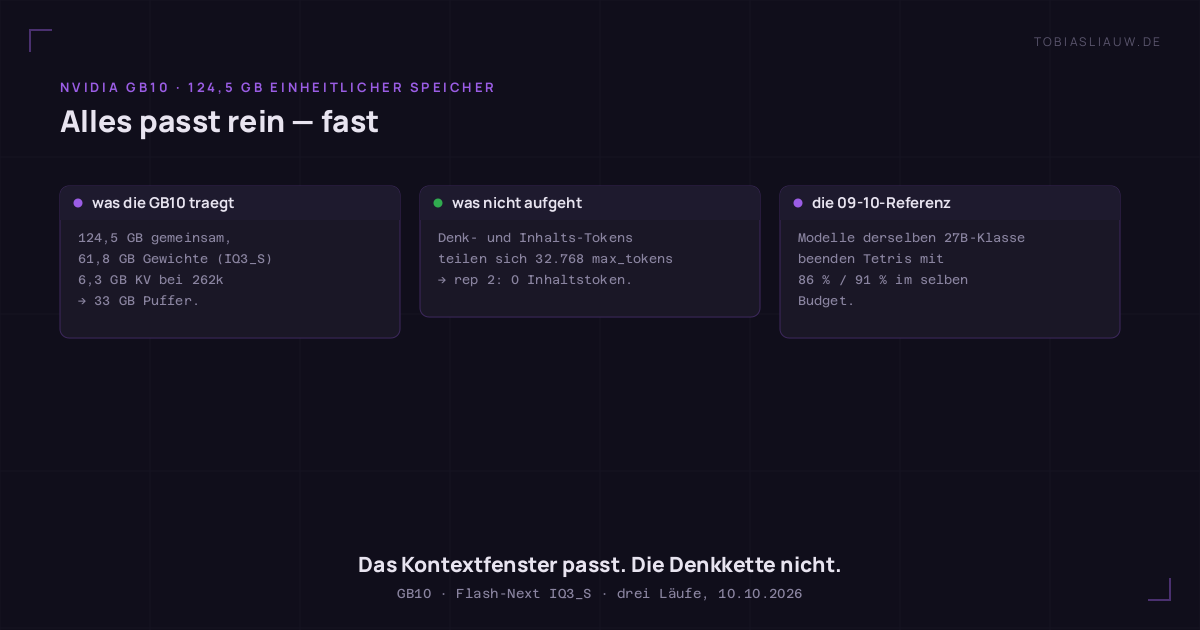
Eine Nvidia-GB10 hat 124,5 GB gemeinsamen Speicher, den Prozessor und GPU sich teilen. Ich habe daraus ein einzelnes Modell gemacht: einen 27B-Klassen-Runner mit großem Kontextfenster statt zwei Modelle auf zwei Karten. Zwei Fragen standen an. Was kostet das Kontextfenster auf 124 GB wirklich? Und baut ein Modell, das bis zu 32.768 Tokens lang über eine Aufgabe nachdenkt, am Ende trotzdem ein funktionierendes Tetris?
Der Aufbau
- Eine GB10: 124,5 GiB unified memory, 20-CPU, eine Blackwell-GPU, 3,092 GiB NVMe. Das Modell liegt auf der Platte und wird über den Page-Cache (mmap, komprimiert) direkt auf dem Beschleuniger ausgeführt. Während der Messung durfte nichts anderes auf die GPU; eine Sperre prüfte vor und nach jeder Zelle auf fremde Prozesse.
- Modell:
Qwen3.8-Flash-Next-abliterated, IQ3_S-Quantisierung, zwei Shards (66,97 GiB auf der Platte, ca. 61,8 GB Gewicht), KV-Cache f16, Flash Attention an, Kontext fest am Server. llama-serverdirekt, nicht Ollama. Die Begründung steht in meinem Beitrag über die vier 4-Bit-Builds: explizite Flags, laute Fehler, Timings pro Anfrage, ein Modell pro Prozess.- Identische Sampling-Parameter, ein eigener Seed pro Wiederholung, jede Zelle zählt erst ab drei gültigen Wiederholungen, Mediane mit Standardabweichung. Abgeworfene Proben fließen nie in Mediane ein.
- Die Tetris-Task ist dieselbe wie am 9. Oktober: ein komplettes Spiel aus einer einzigen generierten HTML-Datei, 16 Checks, der Code wird ausgeführt und nicht gelesen. Jeder Prüfer musste vorab eine bekannt richtige Antwort annehmen und eine bekannt falsche ablehnen. Drei Wiederholungen, Budget 32.768 Tokens, Thinking im Modell-Default.
Befund 1: Die 27 Token/s gelten auch bei 32.768 Kontext
Sechs Zellen über die Promptlänge von 512 bis 32.768 Tokens, je 3 gültige Wiederholungen:
| Prompt | Einlesen PP tok/s | Generierung TG tok/s | erstes Zeichen |
|---|---|---|---|
| 512 | – (Overhead) | 27,36 | 0,86 s |
| 2.048 | 738 | 27,08 | 2,86 s |
| 8.192 | 716 | 26,95 | 11,58 s |
| 32.768 | 675 | 25,83 | 49,45 s |
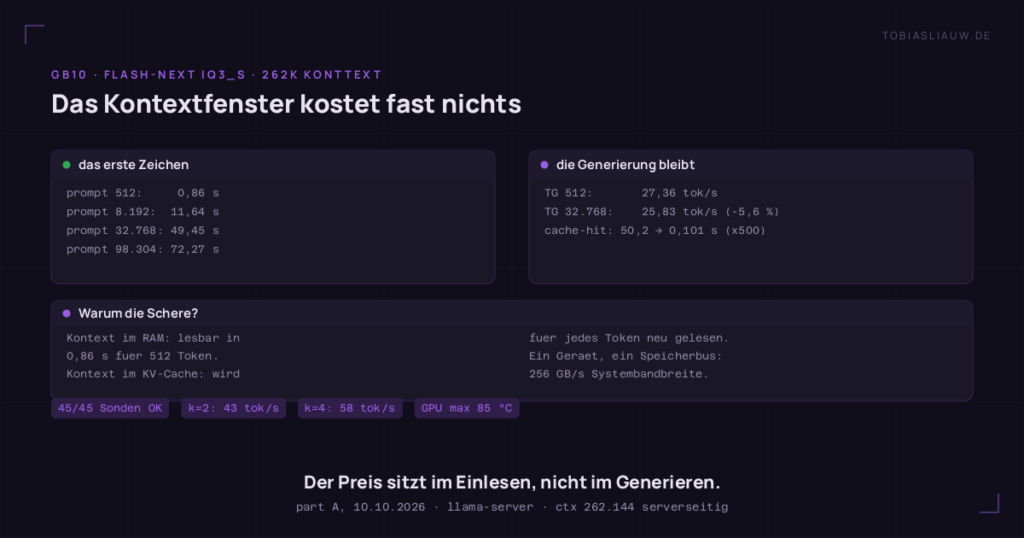
- Generierung kennt praktisch kein Kontextfenster. Von 27,36 tok/s bei kurzen Prompts auf 25,83 bei 32.768: −5,6 %. Selbst bei einer Kontexttiefe von 65.536 Tokens sind es noch 21,12 tok/s gegenüber 26,77 bei Tiefe 0. 64k Kontext kosten etwa ein Fünftel, keine Größenordnung.
- Der Preis des Kontexts sitzt im Einlesen. Das erste Zeichen rückt von 0,86 s auf 49,45 s. Genau das ist der 32k-Prompt, der am 9. Oktober auf einer 24-GB-Karte still gekürzt wurde — hier wird er nur langsam gelesen.
- Derselbe PräFix zweimal kostet fast nichts. Cache-Treffer: 50,21 s ohne Treffer, 0,101 s mit. Ein Faktor 500. Für Agenten, die denselben Kontext mit Werkzeugaufrufen mehrfach durchziehen, ist das der Unterschied zwischen lauwarm und nutzbar.
Befund 2: Bei der Generierung liegt sie gleichauf, beim Einlesen verliert sie
Basislauf 2.048 Prompt / 512 Antwort, Leerlauf, frisch geladen — gegen die Messung auf meiner Zweikarten-Maschine (2× RTX 3090) vom 9. Oktober:
| GB10 (124,5 GB) | Zweikarten (2× 24 GB) | Unterschied | |
|---|---|---|---|
| Einlesen, tok/s | 738 | 970 | −23,9 % |
| Generierung, tok/s | 27,08 | 26,6 | +1,8 % |
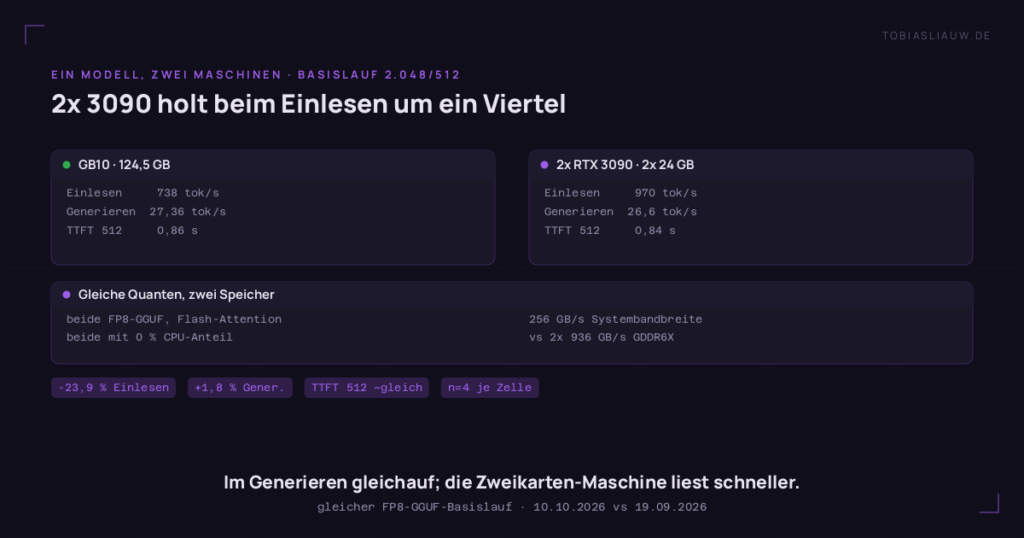
Die 124 GB machen die Maschine also nicht bei der Generierung besser — die liegt auf Augenhöhe. Was sie können, ist anders: Das Modell, sein 61,8-GB-Gewicht, der KV-Cache für ein großes Fenster und das Betriebssystem liegen zusammen unter 124,5 GB. Nichts wird ausgelagert. Auf der 24-GB-Karte heißt „passt nicht„ dagegen still „langsamer„: Ollama lagert Schichten auf die CPU aus, das Modell antwortet weiter, niemand merkt es. Auf der GB10 ist „passt„ einfach wahr.
Ehrlich dazu: Wer lange Prompts in Echtzeit braucht, holt sie mit der alten Zweikarten-Konfiguration schneller ins Haus — 49,5 Sekunden sind für einen 32k-Prompt trotzdem viel.
Befund 3: Tetris — 32.768 Tokens reichen bis zum Denken, nicht bis zum Bauen
Die Task vom 9. Oktober, jetzt auf der GB10: eine einzige HTML-Datei, in der ein voll spielbares Tetris steckt. Drei Wiederholungen, eigenes Seed je Lauf, Thinking im Modell-Default, Budget 32.768 Tokens:
| Rep | Denk-Tokens | Inhalt-Tokens | erster Inhalt | Ende |
|---|---|---|---|---|
| 1 | 29.912 | 2.856 | nach 1.337 s | Length-Cap (GEKAPPT) |
| 2 | 32.768 | 0 | – | Length-Cap (GEKAPPT) |
| 3 | 29.635 | 3.133 | nach 1.323 s | Length-Cap (GEKAPPT) |
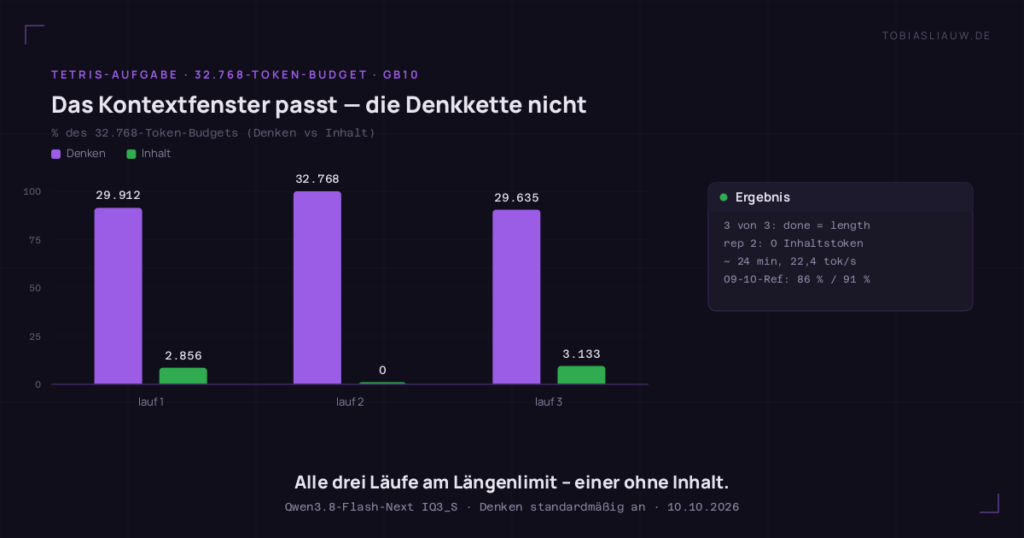
Alle drei Läufe enden nach rund 24 Minuten mit done: length bei 22,4 Generierungs-Tok/s. In zwei Läufen beginnt der Inhalt erst, nachdem das Modell rund 30.000 Tokens in seine Denkkette geschrieben hat; im zweiten Lauf kommt nie ein einziger Inhalt-Token. Das Modell ist nicht abgestürzt und hat keine Fehlermeldung produziert — es hat nur nicht geendet, bevor das Budget aufging. Thinking stand auf Modell-Default; ich habe ihn weder an- noch abgestellt.
Am 9. Oktober dieselbe Task, anderer Rechner: zwei Modelle dieser Größeklasse haben sie mit 30/35 und 32/35 Checks beendet (86 % und 91 %). Ein 30B-Modell ist an ihr gescheitert (12/35), ein Coder-Modell ist an seinem eigenen Verifizierer hängengeblieben. Die Aufgabe ist also lösbar — auf der GB10 wäre das Budget nur zu klein gewesen, um es zu zeigen.
Nach der Regelung aus dem 4-Bit-Beitrag zählt ein Lauf, der an das Token-Limit stößt, als ungültig, nicht als Fehlschlag. Genau das ist hier passiert: nicht ein Urteil über das Modell, sondern die Messung eines zu kleinen Budgets für ein denkendes Modell.
Meine eigenen Messfehler
- 36 von 409 Messwerten hatten steigende Drossel-Zähler (Software-Thermal- oder Power-Cap), die GPU-Temperatur kam auf 85 °C. Meine Plausibilitätsprüfung hat sie geflaggt und aus den Medianen herausgehalten. Ohne sie wären sie hineingelaufen.
- 136 von 307 Zellen der größeren Modellbatterie erreichten die Mindestzahl von drei Wiederholungen; der Rest steht im Bericht als „unvollständig„. Interpoliert habe ich nichts.
- Einer nicht durch Messung, sondern durch Annahme: Ich habe vorausgesetzt, die Denkkette endet von selbst. Sie kann 32.768 Tokens lang sein — länger als eine ganze Codetask. Das Limit ist eine Eigenschaft des Testrads, und es war zu klein.
Was ich daraus mache
- Tetris kommt im nächsten Nachtfenster zweimal rein: einmal mit Thinking explizit aus, einmal mit 96k-Budget. Ein 128k-Budget wäre rechnerisch auch gegangen (124,5 GB); gemessen nicht.
- Kandidaten stehen an:
Qwen3.8-27Bin FP8 und ein 274B-MoE mit Q2-Quantisierung (97,6 GB — passt mit rund 20 GiB Rest für KV-Cache und Betriebssystem). Was 124 GB bei einem wirklich größeren Modell bringen, zeigt der nächste Beitrag. - Die Produktionsinstanz bleibt, wo sie ist: Flash-Next auf der GB10, Port 18180. Der Benchmark hat sie über Nacht gestopft und um 5 Uhr wiederhergestellt; die Abschlussprobe ist durchgelaufen.
- Rückverweis: Wie dieselbe 27B-Familie auf 24 GB zugibt (wenn auch nur still), steht im Beitrag “Vier 4-Bit-Builds von Qwen3.8-27B auf einer RTX 3090”: vier 4-Bit-Builds — die Modelle lagen gleichauf, das Kontextfenster nicht.