Zwei Nächte hintereinander habe ich dasselbe Modell über sein trainiertes Fenster hinaus gequält: 524.288 und 1.048.576 Kontexttoken auf zwei GeForce RTX 3090, errungen mit Rope-Stretching (YaRN, Hebel 2 und 4), gefahren über die Produktions-Engine, nach jeder Konfiguration ein Neustart. Die Frage war knapp: Findet das Modell jenseits des trainierten Rahmens noch eine Sonde im Prompt — und was kostet das an Zeit? Die Antwort in einem Satz: Es findet sie zuverlässiger, als ich erwartet habe — 24 von 24 Sonden in zwölf Zellen, drei KV-Stufen, zwei Fenster — aber die Zeit wächst nicht linear zum Kontext, sondern überlinear: 5,8 Minuten für einen vollen Durchlauf bei 512k, 13,7 Minuten bei einer Million, und beide k8v4-Doppelzellen bei 512k sind dabei eingebrochen. Der zweite Teil der Serie über Langzeitkontext auf derselben Maschine; der erste Teil misst, was der KV-Speicher bei 262.144 Token kostet.
Wer die Grundlagen sucht, findet sie hier: Teil 1 — KV-Speicher und die Wartzeit bei vollem Fenster, dazu der Aufbau der Flotte, der Grafikkarten-Patch (in allen Messungen aktiv) und die Quantleiter desselben Modells.
Was „gestreckt“ hier technisch heißt
Das Modell — qwen3.8-flash-next-abliterated, ein Experten-Mix in IQ3_S — ist mit einem Rotations-Fenster von 262.144 Token trainiert. YaRN verschiebt die Rotationsfrequenzen der RoPE-Schlüssel so, dass dieselben Schlüssel ein Mehrfaches dieses Abstandes abbilden, ohne das Training komplett zu verlassen; der Engine wird das als Parameter mitgegeben, nicht als neues Gewicht:
--rope-scaling yarn,--rope-scale 2,--yarn-orig-ctx 262144→ das Fenster meldet 524.288 Token.--rope-scale 4bei gleichem Ursprungsfenster → das Fenster meldet 1.048.576 Token, also exakt das Vierfache des trainierten Bereichs.- Der KV-Cache wächst mit dem Fenster unverändert linear: int8 bleibt bei 22.176 Byte je Token, also 5,41 GiB bei 262.144, 10,83 GiB bei 512.288 und 21,66 GiB bei einer Million. q4_0 (4 Bit für Schlüssel und Wert) braucht davon 12.096 Byte je Token: 2,95 / 5,91 / 11,81 GiB. k8v4 (8 Bit Schlüssel, 4 Bit Wert) liegt dazwischen: 4,18 / 8,37 / 16,73 GiB. Gerechnet aus den Formatgrößen, nicht gemessen.
Wichtig für die Bewertung: YaRN ist ein dokumentiertes, mathematisch sauberes Verfahren — aber ob ein konkretes Modell jenseits seines Trainingsfensters noch verwertbare Antworten liefert, steht darin nicht. Genau das ist der Beitrag hier: nicht die Theorie, sondern zwölf Zellen mit Sonde und Stoppuhr.
Wie geprüft wurde
Gemessen wurde die Phase a2 der Sweetspot-Matrix: 20 Zellen, in zwei Nächten vom 29. Oktober 18:13 bis zum 30. Oktober 04:08, jeweils nach einem Neustart der Engine mit der neuen Konfiguration. Gedreht wurden drei KV-Stufen (int8, k8v4, q4_0) × zwei Ausbaustufen des KV-Anteils (20 GiB und 64 GiB) × zwei Fenster (512k mit Hebel 2, 1 Mio mit Hebel 4), jeweils in einer Sitzung — das sind die zwölf Zellen mit Nadeltest — plus acht Zellen mit zwei gleichzeitigen Sitzungen für das Parallelverhalten.
Zwei Messinstrumente, sauber getrennt:
- Die Zeitsonde schickt einen frischen Prompt von 262.144 Token und misst erstes Token, Prefill-Rate und Decode-Rate. Sie ist bei allen drei Fenstern gleich groß und damit der Vergleichspunkt: Was kostet das gestreckte Fenster, wenn die Arbeit gleich bleibt?
- Der Nadeltest baut einen Prompt, der das Fenster fast ausfüllt, versteckt ein Codewort mit Zahl in halber und in oberster Tiefe und verlangt es zurück. Denken ist ausgeschaltet, Temperatur 0, maximal 32 Antworttoken — die Antwortzeit ist also im Wesentlichen die Vorverarbeitungszeit des ganzen Prompts. Jede Zelle bekam zwei Sonden.
Zwei Ehrlichkeiten, die ich vorher nenne. Erstens: Am oberen Rand des Fensters hat der Server mehrfach abgelehnt (HTTP 400), der Prüfer hat den Prompt dann verkleinert — das ist bei 5 von 12 Sonden bei 512k und bei 7 von 12 Sonden bei einer Million passiert. Die Prompts landeten dadurch bei 445.471 bis 524.123 Token (512k) und 890.788 bis 1.048.479 Token (1 Mio). Es wurde also nicht jede Sonde am absoluten Anschlag gemessen, sondern knapp darunter. Zweitens: Bei gestrecktem Fenster habe ich zwei Tiefen geprüft (50 und 90 Prozent), bei nativem 262k-Kontext in der Vorbereitungsphase drei. Die Nadelquote ist damit nicht zeilenweise über beide Teile vergleichbar.
Befund 1: Jenseits des trainierten Rahmens findet das Modell die Sonde — in allen zwölf Zellen
| Zelle | Sonden | Prompt (Median je Zelle) |
Vollpass | KV-Bedarf je Sitzung |
|---|---|---|---|---|
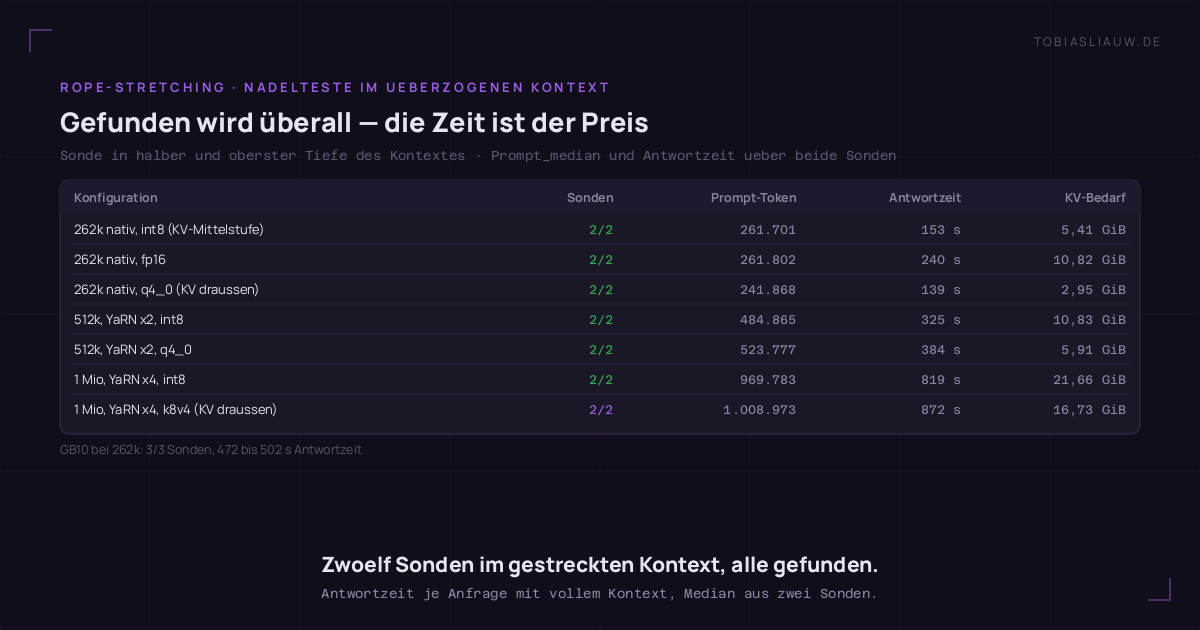
| 262.144 nativ, int8, 32 GiB | 2/2 | 261.701 | 153 s | 5,41 GiB |
| 512k, YaRN ×2, int8, 20 GiB | 2/2 | 484.916 | 325 s | 10,83 GiB |
| 512k, YaRN ×2, k8v4, 64 GiB | 2/2 | 484.637 | 348 s | 8,37 GiB |
| 512k, YaRN ×2, q4_0, 64 GiB | 2/2 | 523.759 | 419 s | 5,91 GiB |
| 1 Mio, YaRN ×4, int8, 20 GiB | 2/2 | 969.935 | 814 s | 21,66 GiB |
| 1 Mio, YaRN ×4, k8v4, 64 GiB | 2/2 | 1.047.412 | 919 s | 16,73 GiB |
| 1 Mio, YaRN ×4, q4_0, 20 GiB | 2/2 | 970.201 | 779 s | 11,81 GiB |
Zwölf Zellen, je zwei Sonden, vierundzwanzig Treffer. Kein Verfehlen in halber Tiefe, kein Verfehlen in oberster Tiefe, weder bei Hebel 2 noch bei Hebel 4, weder bei int8 noch bei k8v4 noch bei q4_0. Das ist ein anderes Ergebnis als bei 262.144 nativ: Dort ist im Vorlauf eine Sonde auf der allerletzten Kante (Prompt 262.133 von 262.144 Token) verfehlt worden — der Rand des nativen Fensters ist also unzuverlässiger als das Innere des vierfach gestreckten Fensters.
Zwei Einschränkungen, die das Ergebnis nicht kleiner machen, aber einordnen. Die Sonde ist eine Suchaufgabe: Ein Codewort mit Zahl steht im Text und soll zurückgegeben werden. Sie prüft Aufmerksamkeit über lange Distanz, aber kein Schließen über mehrere Absätze hinweg, kein Rechnen, kein Widerspruchs-Detektieren. Und: Bei einer Million Kontext ist die 50-Prozent-Sonde selbst schon 524.000 Token tief — also ebenfalls außerhalb des trainierten Bereichs; sie wurde trotzdem gefunden. Was ich daraus mitnehme: Für Suchen in langen Dokumenten ist das gestreckte Fenster brauchbar. Für Qualität jenseits der Suche habe ich keinen Beleg.
Befund 2: Die Zeitsonde merkt das Stretching kaum — der volle Durchlauf merkt es deutlich
| Fenster | Zeitsonde (262.144 Token) |
Prefill-Sonde Median tok/s |
Vollpass-Rate Median tok/s |
Verhältnis | Vollpass Median |
|---|---|---|---|---|---|
| 262.144 nativ (Vorbereitungsnacht, andere Stufen) | 139,5 s | 1.756 | 1.246 | 0,71 | 128–325 s |
| 512k, YaRN ×2 | 131,8 s | 2.053 | 1.454 | 0,71 | 293–423 s |
| 1 Mio, YaRN ×4 | 138,1 s | 1.981 | 1.210 | 0,61 | 696–920 s |
| GB10, 262k nativ (Vergleich) | 379,4 s | 669 | 520 | 0,78 | 425–576 s |
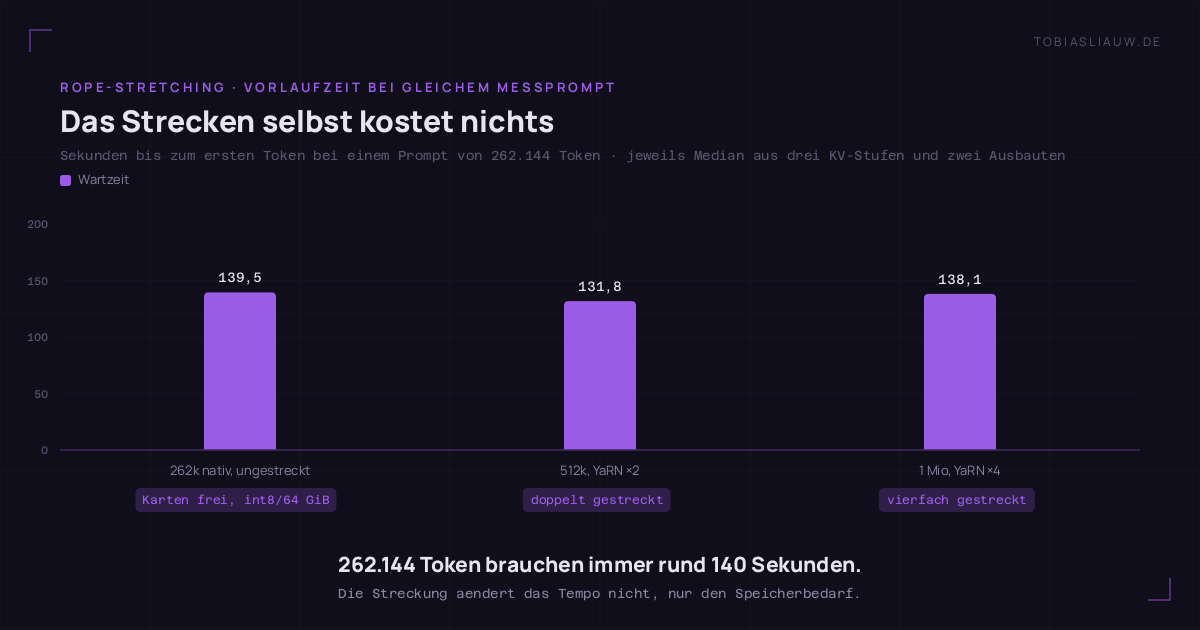
Die erste Spalte ist die gute Nachricht: Für einen Prompt von 262.144 Token braucht die Engine in einem 512k-Fenster 131,8 Sekunden bis zum ersten Token, im Millionenfenster 138,1 Sekunden — und im nativen Fenster 139,5. Das Stretching selbst kostet also messbar nichts; die Rechenarbeit für einen Prompt dieser Größe ist identisch, egal wie groß das Fenster darüber hinaus offensteht.
Die Spalten rechts sind die schlechte Nachricht, und sie ist interessanter. Füllt man das Fenster tatsächlich — 485.000 statt 262.000 Prompt-Token —, sinkt die wirksame Rate von 2.053 auf 1.454 Token pro Sekunde; bei einer Million Prompt-Token auf 1.210. Die letzten 500.000 Token eines Prompts kosten deutlich mehr Zeit pro Token als die ersten 262.000. Ob das an der quadratisch wachsenden Aufmerksamkeit, am KV-Paging oder an beidem liegt, habe ich nicht gemessen — gemessen ist nur die Konsequenz: Wer das Fenster ausnutzt, zahlt nicht proportional, sondern überlinear.
Der Decode-Takt bleibt davon unberührt: Median 49,5 Token pro Sekunde bei 512k, 49,6 bei einer Million — praktisch der Wert von Teil 1. Was sich verändert, ist ausschließlich die Zeit bis zum ersten Token. Bei langem Kontext entscheidet die Vorverarbeitung, nicht die Ausgabe.
Befund 3: Ein voller Durchlauf kostet 5,8 bis 13,7 Minuten — und die KV-Stufe ist dabei gleichgültig
| Fenster | KV-Stufe | Nadeltest | Prompt-Median (beide Sonden) |
Antwortzeit Median | Spanne der Sonden |
|---|---|---|---|---|---|
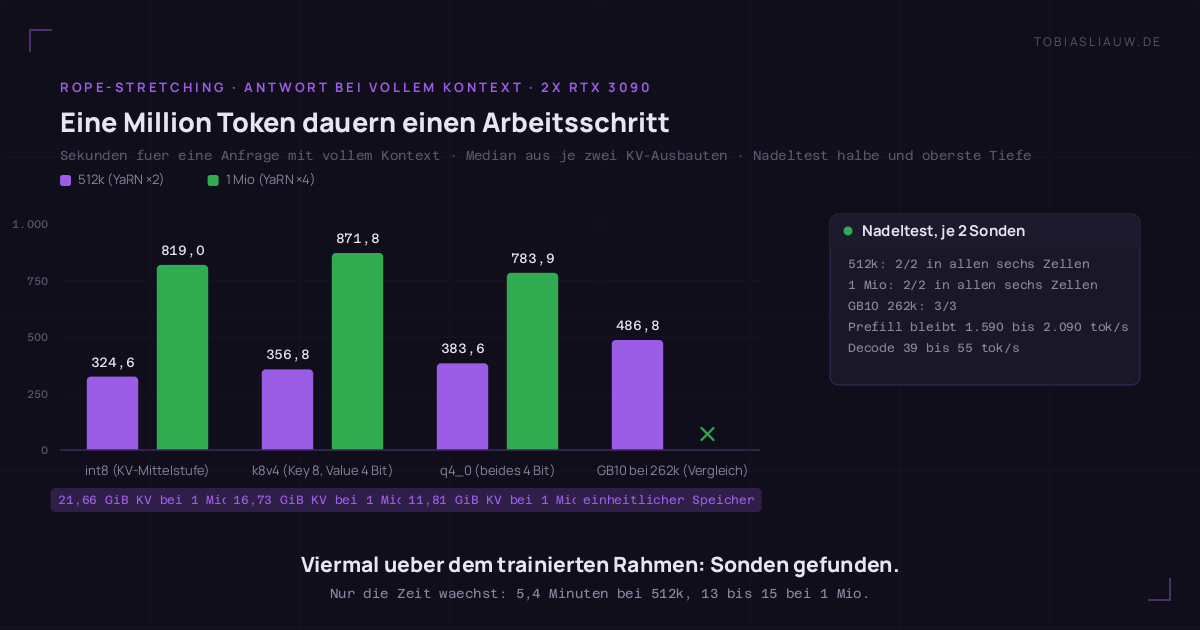
| 512k, YaRN ×2 | int8 (Mittelstufe) | 2/2 in beiden Zellen | 484.817 | 324,6 s | 293,4–355,8 s |
| k8v4 (Schlüssel 8, Wert 4 Bit) | 2/2 in beiden Zellen | 523.293 | 356,8 s | 323,2–373,6 s | |
| q4_0 (beides 4 Bit) | 2/2 in beiden Zellen | 523.795 | 383,6 s | 347,0–422,8 s | |
| 1 Mio, YaRN ×4 | int8 | 2/2 in beiden Zellen | 969.935 | 819,0 s | 723,8–920,0 s |
| k8v4 | 2/2 in beiden Zellen | 1.047.412 | 871,8 s | 735,3–919,3 s | |
| q4_0 | 2/2 in beiden Zellen | 970.201 | 783,9 s | 695,6–869,1 s |
Der Median über alle sechs 512k-Zellen liegt bei 348 Sekunden (5,8 Minuten) für eine einzige, vollständig beantwortete Anfrage, der Median über alle sechs Millionen-Zellen bei 819 Sekunden (13,7 Minuten). Zur Einordnung: 262.144 Token nativ kosten in derselben Messreihe 153 bis 240 Sekunden — der Sprung von 512k auf 1 Mio ist also kein weiterer Schritt, sondern eine Verdopplung.
Bemerkenswert ist, wie flach die Kurve über die KV-Stufen bleibt: die Stufenmediane lauten 324,6 / 356,8 / 383,6 Sekunden bei 512k und 819,0 / 871,8 / 783,9 Sekunden bei einer Million. Über drei Stufen, deren Speicherbedarf um den Faktor 3,7 auseinanderliegt (5,91 gegen 21,66 GiB bei einer Million), sind das 18 Prozent Spreizung bei 512k und 11 Prozent bei einer Million. Die Stufe entscheidet über den Speicher, nicht über die Antwortzeit. Wer bei einer Million Platz sparen muss, nimmt q4_0 und verliert nichts Messbares.
Befund 4: Zwei Sitzungen bei 512k — und das Rätsel der beiden k8v4-Zellen
| Fenster | KV-Stufe | Sitzungen | Decode je Sitzung | Parallel tok/s | erstes Token |
|---|---|---|---|---|---|
| 512k | int8, 20 GiB | 2 | 54,9 | 77,4 | 127,4 s |
| 512k | int8, 64 GiB | 2 | 54,3 | 76,1 | 128,9 s |
| 512k | q4_0, 20 GiB | 2 | 46,8 | 70,9 | 131,5 s |
| 512k | q4_0, 64 GiB | 2 | 47,8 | 73,9 | 130,1 s |
| 512k | k8v4, 20 GiB | 2 | 12,8 | 16,5 | 175,2 s |
| 512k | k8v4, 64 GiB | 2 | 8,7 | 9,7 | 193,8 s |
| 1 Mio | q4_0, 20 GiB | 2 | 47,8 | 76,2 | 131,7 s |
| 1 Mio | q4_0, 64 GiB | 2 | 47,4 | 72,1 | 132,5 s |
Fünf von acht Doppelzellen verhalten sich unauffällig: zwei parallele Anfragen kosten pro Anfrage die gleiche Vorlaufzeit wie eine einzelne und bringen zusammen 71 bis 77 Token pro Sekunde — das Muster kenne ich aus Teil 1. Zwei Zellen fallen brutal heraus: beide k8v4-Zellen bei 512k, mit 8,7 und 12,8 Token pro Sekunde und Parallelwerten von 9,7 und 16,5 — also praktisch Stillstand, nicht Aufteilung.
Ich habe dafür keine Erklärung, und ich behaupte keine. Der Musterhinweis ist krasp genug, um ihn hinzuschreiben: zwei von zwei k8v4-Doppelzellen eingebrochen, zwei von zwei int8- und zwei von zwei q4_0-Doppelzellen nicht, bei derselben Nacht, demselben Rechner, demselben Fenster. Mögliche Richtungen wären die gemischte Dekodierung (8-Bit-Schlüssel, 4-Bit-Werte) unter Parallelität, oder Speicherdruck, weil k8v4 mit 8,37 GiB je Sitzung zwischen den Stufen liegt — aber beides habe ich nicht getestet. Bis zum Gegenversuch plane ich k8v4 bei zwei Sitzungen im großen Fenster nicht ein. Bei einer Million habe ich die Doppelzellen nur mit q4_0 gefahren; dort ist nichts ausgebrochen.
Befund 5: Die GB10 hält 262.144 Token durch, aber mit fast dreifacher Vorlaufzeit
| Plattform | Fenster | KV-Stufe | erstes Token | Prefill tok/s | Nadeltest | Vollpass |
|---|---|---|---|---|---|---|
| 2 × RTX 3090 (Strata) | 262.144 nativ | int8, 64 GiB, zwei Sitzungen | 139,5 s | 1.857 | — | — |
| 2 × RTX 3090 (Strata) | 262.144 nativ | int8, 32 GiB (Nadelzelle) | — | — | 2/2 | 153,1 s |
| GB10 (llama-server) | 262.144 nativ | int8, einheitlicher Speicher | 379,4 s | 698 | 3/3 | 471,6 s |
| GB10 (llama-server) | 262.144 nativ | q4_0, einheitlicher Speicher | 404,6 s | 641 | 3/3 | 502,0 s |
| GB10 (llama-server) | 512k / 1 Mio | — | nicht gemessen | — | — | — |
Auf der GB10 mit ihrem einen einheitlichen Speicher (121 GiB, von denen das Modell 51 GiB belegt) laufen 262.144 Token in beiden Stufen sauber und mit Treffer in allen drei geprüften Tiefen — aber die Vorverarbeitung dauert 379 bis 405 Sekunden statt 139, der Vollpass 472 bis 502 Sekunden statt 139 bis 261 in den nativen Vergleichszellen der 3090 (dort zwei Tiefen geprüft, hier drei). Hochgerechnet auf eine Million Token, wo der int8-KV-Bedarf auf 21,66 GiB steigt und der Vollpass auf der 3090-Kombination schon 13,7 Minuten braucht, wäre die GB10 bei etwa 35 bis 40 Minuten pro Anfrage. Das ist eine Rechnung, keine Messung — und der Grund, warum lange Kontexte bei mir auf den beiden Karten laufen und die GB10 die Einbettungs- und Abrufmodelle übernommen hat.
Was ich nicht gemessen habe
- Keine Qualitätsachse jenseits der Sonde. Kein perplexity-Wert, keine Zusammenfassungs- oder Rechenaufgabe, kein Widerspruchs-Test über zwei Dokumentteile. Zwölf Zellen mit Suchaufgabe sind ein starker Hinweis auf brauchbare Langfeld-Aufmerksamkeit und kein Qualitätsurteil.
- Nur zwei Tiefen im gestreckten Fenster (50 und 90 Prozent) statt drei wie im nativen Vorlauf. Die ganz flachen und die ganz tiefen Ränder des gestreckten Fensters sind ungeprüft.
- Je Zelle ein Lauf. Die Mediane der Tempospalten beruhen bei 512k und 1 Mio auf je einer Messung je Konfiguration, die Antwortzeiten auf zwei Sonden. Die Rangfolge der KV-Stufen (Befund 3) ist damit Rauschen, die Größenordnung der Antwortzeiten nicht.
- Kein YaRN-Hebel jenseits von 4, kein Dynamic/LongRoPE, kein lückenloses Fenster bei gleicher Qualität: Ich habe zwei Punkte gemessen, nicht die Kurve.
- Nicht gemessen: warum k8v4 unter Parallelität einbricht — und ob es reproduzierbar ist.
- Produktivbetrieb lief weiter, vor allem nachts über Router und Einbettungen auf der GB10. Die Zeitsonden der gestreckten Zellen liegen zwischen 1.557 und 2.092 Token pro Sekunde — die Streuung ist auch Betriebsgeräusch.
Was ich daraus mache
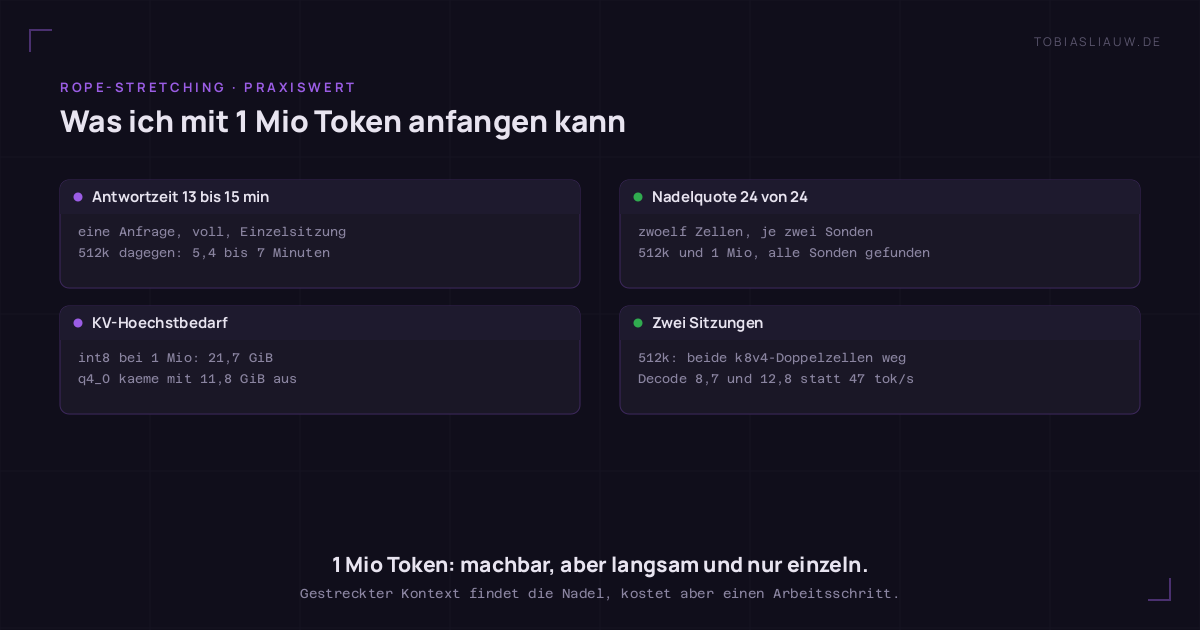
Vier Sätze, die mir aus diesen zwei Nächten bleiben. Erstens: 524.288 Token sind für mich betriebsbereit — eine Anfrage, die das Fenster füllt, dauert 5,8 Minuten und findet, was sie suchen soll; das ist ein Nachschlage-Job, kein interaktiver. Zweitens: Eine Million Token sind machbar und spürbar am Rand: 13,7 Minuten pro Anfrage, Einzelbetrieb, und der Prompt landet praktisch auf der Anschlaggrenze (größte verarbeitete Anfrage: 1.048.479 von 1.048.576 Token). Ich plane Fenster künftig mit 5 bis 10 Prozent Luft nach oben, weil der Anschlag Randprobleme hat — bei nativem Kontext ist dort eine Sonde verfehlt worden, bei gestrecktem Kontext mussten 12 von 24 Sonden nach einer HTTP-Ablehnung verkleinert werden. Drittens: q4_0 ist bei gestrecktem Kontext die vernünftige Stufe: 11,81 GiB statt 21,66 bei einer Million, und bei der Antwortzeit messbar gleichauf. Viertens: Stretching ist kein Gratis-Fenster. Solange ich 131.072 Token brauche, nehme ich das native Fenster mit 66 Sekunden Vorlaufzeit; die Dehnung kostet nicht das Fenster, sondern die Überlinearität dahinter.
Offen für die nächste Nacht: der Gegenversuch zu k8v4 unter Parallelität, eine Qualitätsaufgabe jenseits der Sonde bei 512k, und die Millionen-Zelle auf der GB10. Wenn ich sie gemessen habe, schreibe ich darüber.
Artefakte
Die Messwerte dieser Phase als offene Dateien: alle Kennzahlen als JSON (Mediane je Zelle, Hebel, Nadeltest-Einzelergebnisse mit Promptgrößen und Anmerkungen, Herkunftszeitstempel) und die Zellen als CSV (Phase, Plattform, Rope-Hebel, KV-Stufe, Ausbau, Fenster, Sitzungen, Promptgröße, erstes Token, Prefill, Decode, Paralleldurchsatz, Nadelquote, Antwortzeit). Teil 1 der Serie liegt hier, dort auch die vollständige Zellenmatrix der KV-Achse.
Die vier Grafiken in Originalgröße (1200 × 630): Eine Million Token dauern einen Arbeitsschritt · Das Strecken selbst kostet nichts · Gefunden wird überall — die Zeit ist der Preis · Was ich mit 1 Mio Token anfangen kann.